
Redis缓存介绍
在高并发场景下,如果所有请求都直接访问数据库,数据库将面临资源开销巨大、性能低下甚至被冲垮的风险。因此,一种常见做法是将那些频繁被查询、使用率极高的“热数据”提前存入Redis。客户端请求时,优先查询Redis,若未命中再转向数据库。
这正是Redis缓存的核心价值——如同一个保护层,替数据库扛住了大部分请求流量。
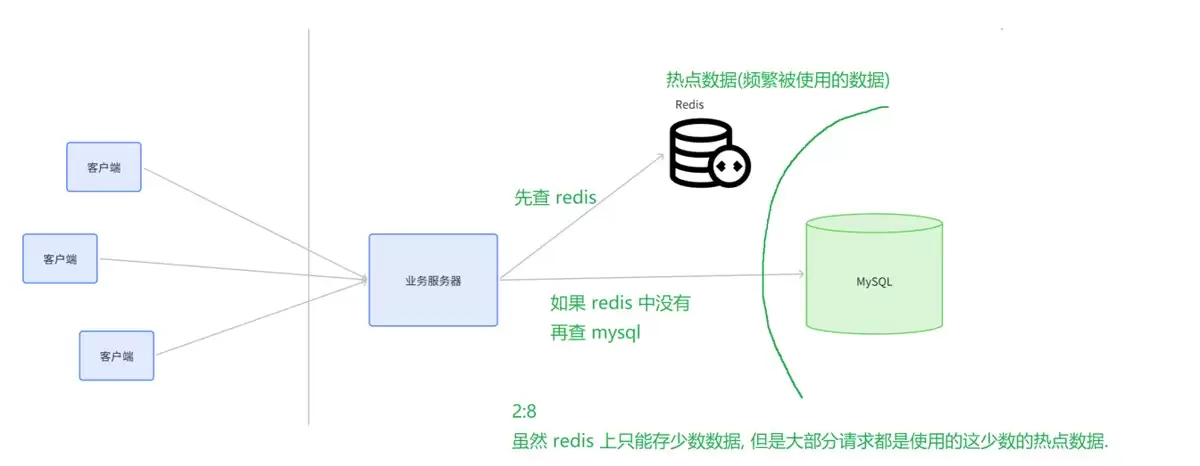
但随之而来两个必须解决的关键问题:
- 如何准确识别哪些数据属于“热数据”?
- 如何确保Redis中始终存储的是最活跃的数据,而非大量冷数据占据空间?
接下来,我们将围绕这两个核心问题展开深入探讨。
缓存策略
1)定期生成
简单来说,就是每隔一段时间,统计数据库中各项数据的访问频率,将排名靠前(如前N%)的数据提取出来,写入Redis。
这种方法的最大优点是操作直观,能对缓存内容进行稳定控制。但缺点也很明显——时效性较差。因为刚过期的热门数据,如果恰好在这段时间内变为冷数据,那么缓存中存储的实际上已不再是“热”数据。
2)实时生成
更常用的做法是:先为缓存设定一个容量上限(通过Redis配置文件的maxmemory参数控制)。然后按照以下逻辑运行:
- 先从Redis中查询,若命中则直接返回结果。
- 若未命中,则去数据库查询,返回结果的同时将数据写入Redis。
当缓存容量达到上限时,需要依据一套可靠的缓存淘汰策略,将Redis中相对不那么“热”的数据清除,从而保持热数据的动态平衡。
3)缓存淘汰策略
实际上,不仅仅是Redis,所有缓存系统面临的核心问题都一样:如何在有限容量下,尽可能保留最有价值的数据。常见策略包括以下几种:
- FIFO(先进先出):缓存中停留时间最长的数据优先被淘汰。
- LRU(最近最少使用):记录每个key最近一次被访问的时间,淘汰最久未被访问的key。
- LFU(最不常使用):记录每个key在最近一段时间内的访问次数,次数最少的优先淘汰。
- Random(随机淘汰):随机选择一个key淘汰——简单粗暴,但可靠性较低。
而Redis在具体实现时,进一步细化了这些策略:
volatile-lru:仅在设置了过期时间的key中,使用LRU算法淘汰。
allkeys-lru:在所有key中,使用LRU算法淘汰——这是最常用的配置。
volatile-lfu:4.0版本新增,仅针对有过期时间的key,使用LFU算法淘汰。
allkeys-lfu:4.0版本新增,在所有key中使用LFU算法淘汰。
volatile-random:在设置了过期时间的key中,随机淘汰。
allkeys-random:在所有key中随机淘汰。
volatile-ttl:对于设置了过期时间的key,优先淘汰“剩余存活时间最短”的——相当于FIFO的变种。
noeviction:默认策略。当内存不足时,新的写入操作直接报错。该策略极少在生产环境中使用。
简而言之,Redis的淘汰策略主要围绕LRU和LFU展开,区别仅在于作用范围是全部数据(allkeys)还是仅限设置了过期时间的数据(volatile)。
缓存中需要考虑的问题
1)缓存预热
设想一下:Redis刚刚启动,内部一片空白。此时发来的请求将直接穿透到数据库,数据库瞬间又回到高负载状态。
解决办法其实很简单:在Redis启动之前或刚启动时,按照定期生成热数据的思路,先将一批热数据写入Redis。即便这批数据并非完全实时,只要能帮助数据库挡住大部分请求,就已经达到预期效果。
2)缓存穿透(Cache penetration)
定义:
- 客户端发来的key在Redis和数据库中都不存在。
- 如果这种“无效key”请求频率很高,就会直接压垮数据库。
常见原因:
- 业务代码存在漏洞,参数校验不严格。
- 运维或开发人员不慎删除了某个热数据key,但未察觉。
- 黑客故意发起攻击,构造大量不存在的key进行试探。
解决方法:
- 严格校验查询参数,拒绝无效key请求。
- 对于数据库中不存在的key,在Redis中也设置一个空值(如空字符串)作为拦截。
- 使用布隆过滤器,在查询前先判断key是否存在,若不存在直接返回。
布隆过滤器:一种高效判断元素是否存在的数据结构,本质上可理解为“Hash + 位图”的变体。它不存储实际值,内存占用极低,非常适合此类场景。
3)缓存雪崩(Cache avalanche)
定义:
- 短时间内大量key同时过期,导致数据库查询量瞬间激增。
原因:
- 设置过期时间时,使用了统一的时间点,例如所有key都设置为1小时过期。
解决办法:
- 不给key设置过期时间,或为每个key的过期时间添加一个随机偏移量,避免“集体失效”。
4)缓存击穿(Cache breakdown)
定义:
- 缓存雪崩是“成片”key同时失效,而缓存击穿则是某个或某几个热点key失效——这类key访问频率极高,一旦失效,瞬间会有一波海量请求直接冲向数据库,数据库极易被打穿。
简单理解:就像双11秒杀商品,那个热门商品的缓存突然过期,成千上万个用户同时刷新,数据库瞬间面临“灭顶之灾”。
解决这个问题的核心无非两条:要么不让所有请求都去查数据库,要么干脆不让热点key过期。
方案一:设置互斥锁(Mutex Lock)
这是最常用的方案。当缓存失效时,并非每个请求都去查数据库,而是先让请求尝试获取一把“锁”(通常使用Redis的SETNX命令)。
- 只有拿到锁的请求才能去数据库查询并回写缓存。
- 其他未拿到锁的请求要么等待重试,要么返回空值。
- 优点是保证了数据库的安全性,数据一致性高;缺点是代码逻辑稍复杂,且高并发下存在一定等待延迟。
方案二:热点数据“永不过期”
从物理或逻辑上,让这个key永远不被淘汰。
- 物理永不过期:写入时就不设置过期时间。简单粗暴,但会一直占用内存,且无法自动更新。
- 逻辑永不过期(后台异步更新):在value中记录一个逻辑过期时间。程序发现逻辑时间即将到期时,由后台线程异步去数据库更新key,并延长逻辑时间。在更新完成前,所有请求继续读取旧数据。这种方式能实现“用户无感知”的更新,但需要额外维护一个后台任务。
总结
以上是对Redis缓存机制的系统梳理。从缓存的核心价值(保护数据库、提升响应速度),到具体的淘汰策略,再到实际应用中必须警惕的缓存穿透、雪崩、击穿等问题,每一条都是高并发场景下绕不开的关键点。掌握这些知识,能够帮助我们在架构设计时少走许多弯路。


