
安装与配置 line_profiler:开始逐行性能分析
在 Python 性能优化的实践中,标准库 cProfile 往往只能提供函数级别的调用统计,难以触及具体的代码行。line_profiler 填补了这一空白,它能精确到每一行代码的 CPU 耗时,特别适用于数值计算、数据处理流水线或复杂算法中的局部热点定位。安装过程十分直接,推荐使用 pip install line_profiler,当前版本已全面兼容 Python 3.8 及以上环境。使用时,只需在待分析的目标函数上方添加 @profile 装饰器(无需显式导入,kernprof 会在运行时自动注入该名称)。随后在终端执行 kernprof -l -v your_script.py,其中 -l 表示启用逐行分析,-v 表示分析完成后直接在终端打印报告。例如,针对一个包含嵌套循环与列表推导的函数,添加装饰器后运行命令,即可在控制台看到首次生成的逐行耗时数据,完成从零到一的性能探查。
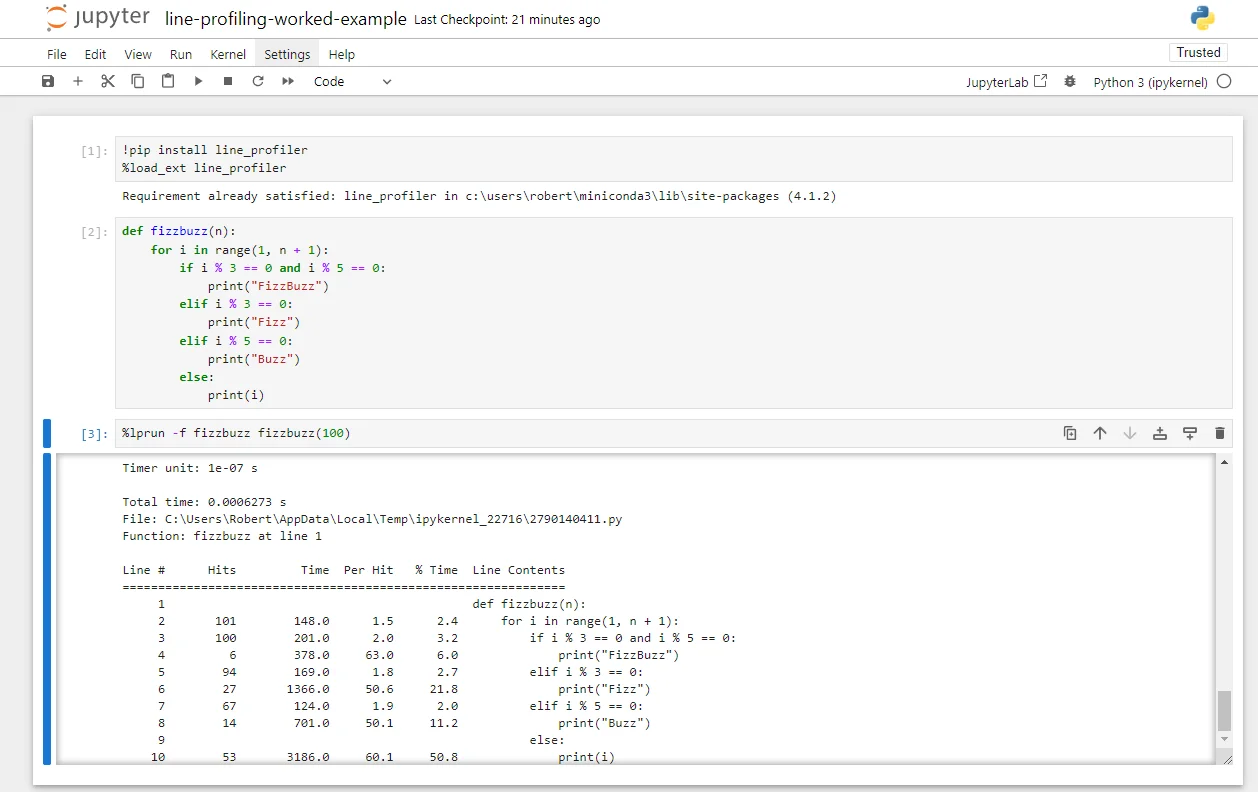
读懂逐行报告:从耗时数据定位瓶颈
运行 kernprof 后生成的报告包含五个核心字段:Line 表示源码行号,Hits 记录该行被执行的总次数,Time 为该行累计消耗的计时器单位(通常 1 个单位等于 1 微秒),Per Hit 是单次执行的平均耗时,% Time 则反映该行占整个函数总耗时的百分比。以一段包含矩阵运算与条件过滤的代码为例,若报告显示某行列表推导式的 % Time 占比极高,且 Per Hit 显著高于其他行,即可判定此处为性能瓶颈。需要注意的是,不能仅凭 Hits 数量判断性能,高频执行但单次极快的代码往往不是优化重点;真正需要关注的是 % Time 占比大或 Per Hit 异常高的行。通过交叉比对执行频率与单次耗时,开发者能精准剥离伪热点,将优化资源集中在真正拖慢程序的关键逻辑上。
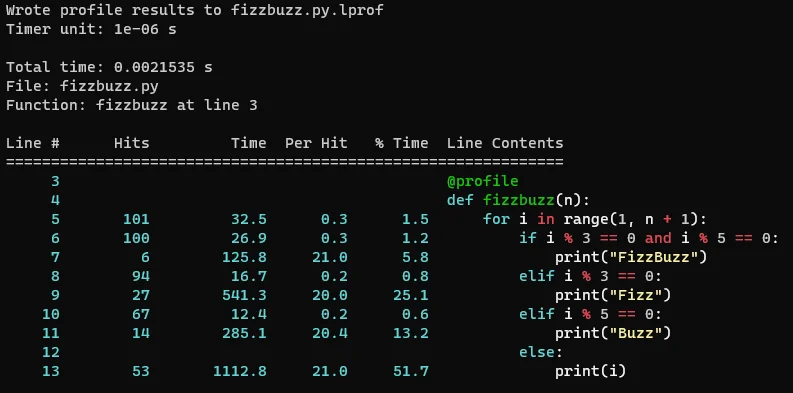
针对热点优化:修改代码并重新测量
获得逐行报告后,优化应遵循假设、实施与验证的闭环。例如,若发现某行频繁调用数学函数且 % Time 占比突出,可假设将其替换为向量化操作或预计算缓存能提升性能。修改代码后,务必再次执行 kernprof -l -v 获取新报告,对比优化前后的 Time 与 % Time 变化。若目标行的耗时显著下降且函数总耗时缩短,则证明优化有效。切忌凭直觉修改 % Time 低于 5% 的代码,因为根据阿姆达尔定律,非瓶颈部分的加速对整体性能贡献微乎其微,反而可能引入额外复杂度。真正的性能提升必须依赖数据对比:只有当热点行的 Per Hit 明显降低,且整体执行时间呈现可复现的下降趋势时,才能确认优化策略成立。
验证与避坑:让 profiling 结果可信
性能分析本身会引入插桩开销,导致测量值普遍高于实际运行时间,因此结果仅用于相对对比而非绝对基准。为确保数据可信,测试必须使用具有代表性的数据规模,避免极小样本掩盖真实热点;同时需固定运行环境,关闭无关后台进程,并排除网络请求与磁盘 I/O 的干扰,因为 line_profiler 仅统计 CPU 时间。常见误区包括:在生产环境遗留 @profile 装饰器导致性能骤降、盲目分析整个项目而非聚焦核心函数、以及仅凭单次运行结果下结论。规范的验证流程应包含:使用固定随机种子生成测试数据、连续执行多次取中位数、对比优化前后的相对耗时变化,并在确认优化有效后彻底移除装饰器。只有建立可重复、受控的测量机制,才能避免被噪声数据误导,确保每一次代码改动都带来真实的性能收益。


