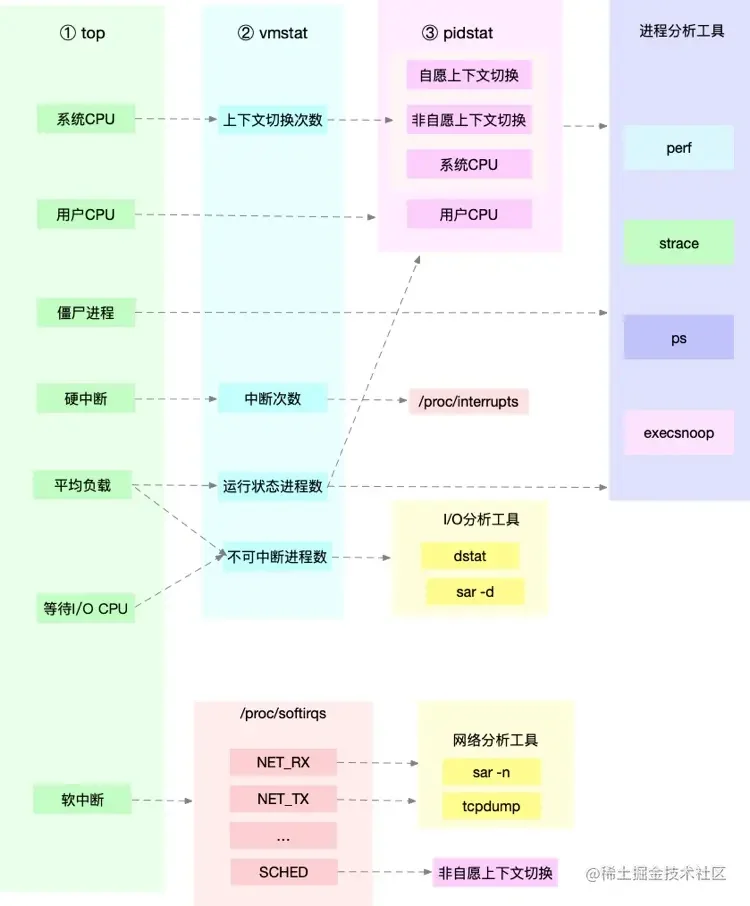
先看懂系统整体状态:负载、CPU与内存
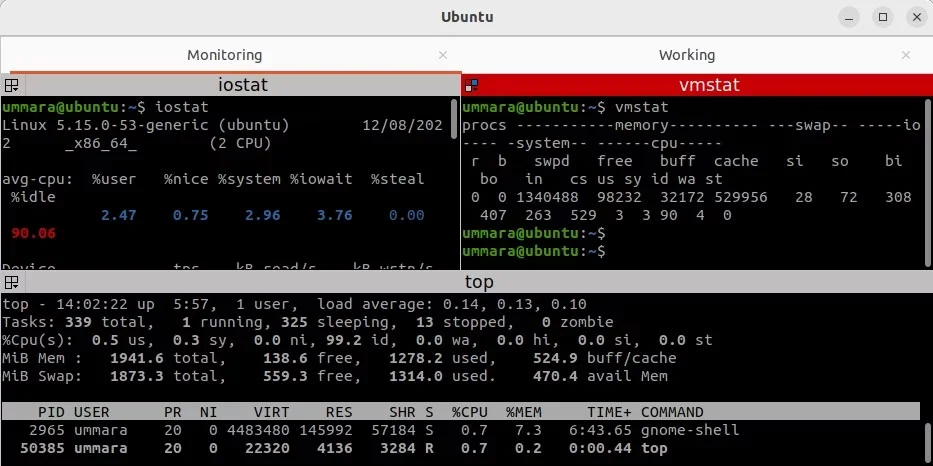
top适合实时、交互式地观察系统瞬时状态与进程级细节,而vmstat更擅长以固定间隔输出系统级汇总数据,便于捕捉趋势与周期性波动。在top头部,load average分别代表过去1、5、15分钟的平均运行队列长度,若持续超过CPU核心数,说明系统存在排队压力。CPU行中,us(用户态)与sy(内核态)占比过高通常指向计算密集或系统调用频繁,id为空闲率,wa(iowait)升高则表明CPU在等待磁盘I/O。内存方面,top的MiB Mem与Swap行展示了物理内存与交换分区的使用情况,需注意Linux会利用空闲内存做缓存(buff/cache),因此可用内存应看avail而非free。结合vmstat 1的初始输出,可快速建立基线:正常负载下r队列应小于核心数,si/so应为0,wa低于5%。掌握这些关联后,即可在监控初期准确判断系统是处于计算瓶颈、内存压力还是I/O阻塞。
用top定位CPU与异常进程
进入top界面后,进程列表是定位资源消耗的核心区域。PID标识进程唯一编号,USER显示运行身份,%CPU与%MEM分别反映该进程占用的CPU时间片比例与物理内存占比,TIME+记录累计消耗的CPU时间,COMMAND为启动命令。默认按%CPU降序排列,若发现某进程%CPU持续超过单核100%,需重点排查。按Shift+P可强制按CPU排序,Shift+M按内存排序。区分瓶颈类型需结合CPU状态:若us偏高,多为业务逻辑计算密集,可通过strace或perf进一步分析热点函数;若sy异常,往往伴随大量系统调用或锁竞争,常见于频繁创建销毁线程或网络包处理;若wa居高不下且对应进程%CPU不高,说明该进程正阻塞于磁盘读写,此时应转向I/O排查而非盲目优化代码。通过top -p

用vmstat判断内存、I/O与系统压力
执行vmstat 2 5可获取每2秒一次、共5次的系统快照,其输出字段是判断底层压力的关键。procs区的r表示等待运行的进程数,若长期大于CPU核心数,说明调度队列拥堵;b为处于不可中断睡眠(通常等待I/O)的进程数,持续非零即存在阻塞。memory与swap区的si(换入)与so(换出)若频繁大于0,表明物理内存不足,系统正频繁读写磁盘交换区,将引发严重性能抖动。io区的bi(读块)与bo(写块)反映块设备吞吐量,结合wa可确认I/O瓶颈。system区的in(中断)与cs(上下文切换)若异常飙升,通常由高频网络包、定时器或大量短生命周期进程引起,会消耗大量内核CPU时间。最后的CPU字段中,id与wa的消长关系尤为关键:当wa上升且id下降,同时b与bi/bo同步走高,即可明确判定为存储I/O瓶颈;若cs与sy同步激增而wa正常,则多为并发模型设计不当导致的内核态开销过大。
从指标到结论:联合验证与常见误区
性能排查切忌单指标定罪,必须建立交叉验证的闭环流程。标准路径为:先用top发现异常现象(如负载飙升或某进程CPU异常),再用vmstat观察系统级指标趋势验证瓶颈类型,最后通过多次采样或结合iostat与pidstat确认结论。常见误区一:load average高不等于CPU满载。Linux负载统计包含运行态与不可中断睡眠态进程,若r正常但b极高,负载高实为I/O阻塞所致,此时CPU可能大量空闲。误区二:free内存少不一定是内存不足。Linux内核会动态将空闲内存用于页缓存,真正决定内存压力的是si/so是否持续非零以及avail字段是否逼近警戒线。误区三:wa高不一定代表磁盘硬件故障。可能是应用层突发大量小文件读写、日志刷盘策略不当或NFS挂载响应延迟。因此,每次发现指标异常后,务必结合业务特征、日志与多工具数据链进行综合研判,避免误杀正常进程或盲目扩容。