理解 Docker HEALTHCHECK 与健康状态
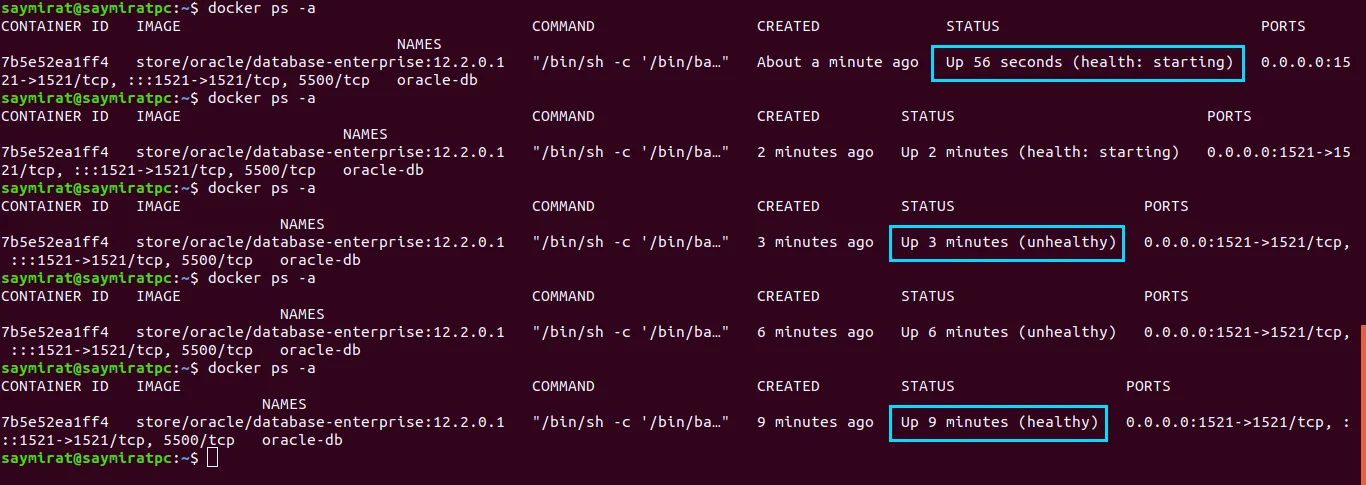
Docker 默认仅通过主进程 PID 判断容器是否存活,但进程存在绝不等于业务可用。例如应用可能陷入死锁、端口未监听、线程池耗尽或依赖服务未就绪。HEALTHCHECK 指令允许用户自定义探测逻辑,定期执行命令并根据退出码(0 为 healthy,非 0 为 unhealthy)更新状态。容器会经历 starting(启动宽限期)、healthy(探测成功)与 unhealthy(连续失败)三种状态。这与 docker ps 显示的 Up 状态完全正交:容器可以是 Up (unhealthy),意味着进程在跑但服务已假死。仅依赖进程存活会导致负载均衡将流量错误路由至不可用节点,而健康检查能实现精准的服务发现与流量隔离,是云原生架构中服务可用性的基石。
用 HEALTHCHECK + curl 配置 HTTP 探测
在 Dockerfile 中,HEALTHCHECK 语法为 HEALTHCHECK [OPTIONS] CMD command。以 Web 服务为例,完整配置为 HEALTHCHECK --interval=30s --timeout=3s --start-period=5s --retries=3 CMD curl -f https://localhost:8080/health || exit 1。参数含义明确:--interval 定义探测间隔,--timeout 为单次最大等待时间,--retries 指定连续失败阈值,--start-period 为启动宽限期,期间失败不计入重试。健康接口 /health 应仅返回 HTTP 200 及轻量 JSON(如 {"status":"ok"}),避免执行重型查询或强依赖外部组件。若 curl 捕获到非 2xx 状态码或网络超时,将触发 exit 1,Docker 随即标记容器为 unhealthy。
构建、运行与验证健康检查
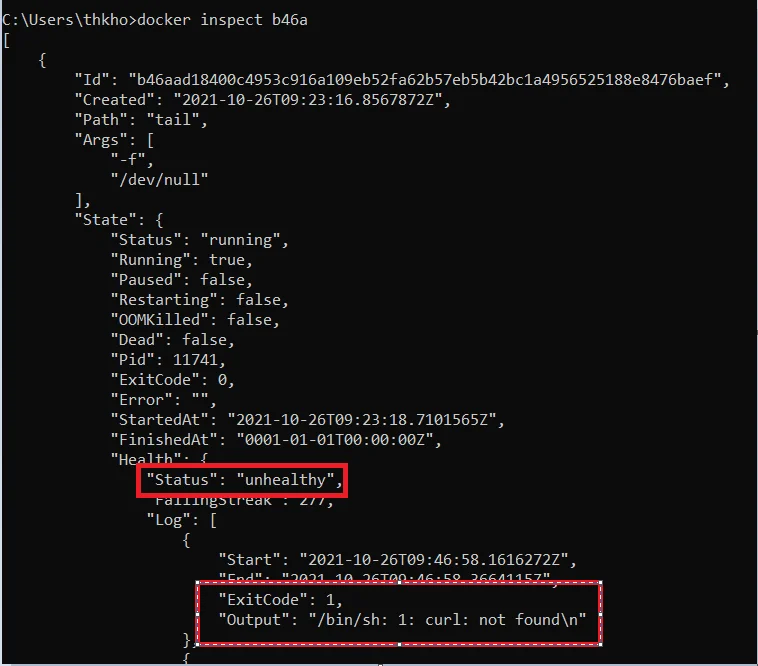
编写完 Dockerfile 后,执行 docker build -t myapp:latest . 构建镜像。启动容器使用 docker run -d --name web-app -p 8080:8080 myapp:latest。初始阶段 docker ps 显示 health: starting。等待 start-period 结束后,可通过 docker inspect --format='{{.State.Health.Status}}' web-app 查看状态,正常应转为 healthy。手动验证时,在宿主机执行 curl -v https://localhost:8080/health 确认返回 200。模拟故障可在容器内停止 Web 进程或强制接口返回 503,随后观察 docker ps 状态变为 unhealthy,并通过 docker inspect web-app 查看 Health.Log 中的失败记录与退出码,完整验证探测链路。
常见避坑与生产实践
生产环境高频问题包括:基础镜像未预装 curl 导致探测直接报错;localhost 或端口配置错误引发 Connection refused;健康接口强依赖数据库或第三方 API 导致级联误判;--interval 过短或 --timeout 过长引发资源浪费与状态延迟。必须明确 HEALTHCHECK 仅负责状态标记,绝不等于自动重启,需配合编排平台的重启策略或 Kubernetes 的 livenessProbe。排查时优先检查 docker inspect 的 Health.Log 输出,区分命令缺失、网络不通或业务超时。建议:使用 wget 或内置 HTTP 客户端作为轻量替代;健康接口仅检查核心内存与本地依赖;合理设置 start-period 覆盖冷启动耗时;结合监控告警 unhealthy 事件,实现自动化运维闭环。