
解构 Operator:CRD、CR 与控制器的角色分工
许多开发者容易混淆 CRD 与 Operator 的概念。实际上,Kubernetes Operator 是一种架构模式,而非单一的二进制程序。它由三个核心部分构成:自定义资源定义(CRD)、自定义控制器(Controller)以及封装在其中的领域运维知识。 CRD 的作用非常纯粹:它向 Kubernetes API Server 注册一种新的资源类型,并定义该资源的 OpenAPI 校验规则。CRD 本身只负责数据的存储与 RESTful 接口的暴露,它不具备任何自动化逻辑。真正的“智能”来自于 Controller。 当用户提交一个自定义资源(CR)实例时,CR 中的 spec 字段描述了用户期望的系统状态。Controller 通过控制循环(Reconciliation Loop)持续监听该 CR 及其关联的底层资源。它将实际状态与期望状态进行对比,并执行创建、更新或删除操作,最终将实际状态收敛至期望值。这种“声明期望、自动调谐”的机制,使得 CRD 从单纯的数据扩展升维为具备自动化运维能力的 Operator。

设计最小 CRD:从 API 分组到 Schema 校验
设计一个有效的 CRD,关键在于明确其 API 分组(Group)、版本(Version)、资源类型(Kind)以及作用域(Namespaced 或 Cluster)。 以定义一个 WebApp 资源为例,我们需要编写一个 YAML 文件,指定 apiVersion 为 apiextensions.k8s.io/v1,kind 为 CustomResourceDefinition。在 spec.names 中,我们需要声明 plural(复数形式,用于 URL)、singular(单数形式)和 kind(资源类型)。spec.scope 通常设为 Namespaced,表示该资源属于特定命名空间。 最关键的校验逻辑位于 spec.versions[].schema.openAPIV3Schema。通过 properties 声明 spec(如 replicas、image)与 status 的结构,并利用 type、required、minimum 等字段实现强类型校验。例如,我们可以强制要求 replicas 必须大于等于 1。 用户通过 kubectl apply 注册该 CRD 后,API Server 即开始接受并存储符合该 Schema 的 CR 实例。需要注意的是,CRD 仅扩展了 API Server 的数据面。如果涉及复杂的认证、子资源或跨集群路由,应评估 Aggregated API Server 方案,而非单纯依赖 CRD。

实现 Controller:从 Watch 事件到幂等调谐
基于 controller-runtime 框架(如 Kubebuilder 脚手架),Controller 的核心逻辑封装在 Reconcile 函数中。这是 Operator 的“大脑”。 控制器启动时,会通过 Informer 机制 Watch 目标 CR 及其依赖的资源。当资源发生变更(Create/Update/Delete)时,Informer 会将事件放入 WorkQueue,触发调谐。在 Reconcile 内部,逻辑通常分为三步: 1. 读取 CR 的 spec,解析用户期望。 2. 计算期望的下游资源清单(如 Deployment、Service)。 3. 调用 Kubernetes Client 执行 Create 或 Update 操作。 此过程必须严格保证幂等性:无论 Reconcile 被调用多少次,只要输入相同,输出结果与副作用必须一致。这是实现最终一致性的基石。每次操作后,需将执行结果写回 CR 的 status 字段,以便用户通过 kubectl get 查看当前状态。 通过设置 OwnerReference,可建立 CR 与下游资源的级联删除关系;同时利用 EventRecorder 记录关键事件。若调谐失败,应返回 RequeueAfter 实现指数退避重试,避免阻塞工作队列导致其他资源无法处理。

部署验证与故障排查:从日志到事件
完整的验证链路始于 kubectl apply 安装 CRD,随后部署 Controller Deployment,最后提交 CR 实例触发调谐。
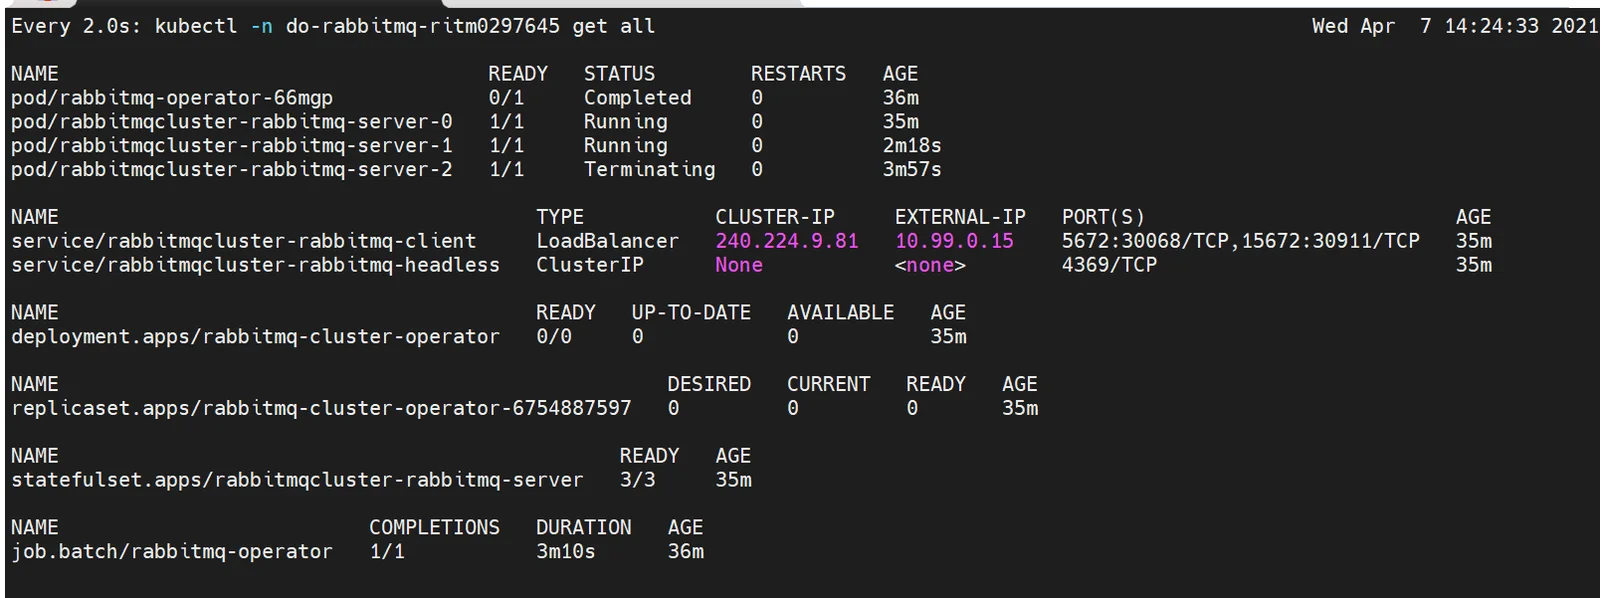
验证阶段,首先使用 kubectl get 确认对象存在,再通过 kubectl describe 查看 Events 区域,确认 Controller 是否成功接收并处理请求。若出现“CR 已创建但业务资源未生成”,需检查 Controller 日志,常见原因为 RBAC 权限不足导致 Create 被拒,或 Watch 配置错误导致未触发。
若“资源已生成但状态不正确”,应重点审查 status.conditions 字段,确认是否因下游 Pod 启动失败或健康检查未通过导致状态未更新。通过结合 kubectl get events 与结构化日志,可快速定位调谐断点,判断是网络问题、权限拦截还是业务逻辑缺陷。
以下是一个典型的排查命令序列:
``bash
# 1. 检查 CR 状态
kubectl get webapp my-webapp -o yaml
# 2. 查看 Controller 日志
kubectl logs -l app=my-operator-controller -f
# 3. 查看集群事件
kubectl get events --sort-by=.metadata.creationTimestamp
``
生产实践:防御性设计与常见陷阱
生产级 Operator 与“能跑通”的 Demo 核心差异在于可维护性与防御性设计。以下是几个关键的设计原则: 1. **绝对幂等**:Reconcile 函数必须是无副作用的纯逻辑计算(除了对 K8s 资源的修改)。避免在循环中执行耗时操作或依赖外部状态。 2. **最小 RBAC**:权限控制必须遵循最小权限原则,仅授予 Controller 操作所需资源的必要权限。避免使用 cluster-admin 或过于宽泛的 Role。 3. **Schema 严格校验**:CRD Schema 应避免过度嵌套,利用 strict 模式强制校验,防止非法字段污染数据。 4. **结构化状态反馈**:状态反馈需通过 status.conditions 提供结构化、可观测的运维信号,便于上层监控系统抓取。 5. **级联清理**:资源清理必须依赖 OwnerReference 实现级联删除,严禁在调谐逻辑中硬编码清理逻辑,以免在 Controller 重启或重部署时产生孤儿资源。 6. **版本演进**:应遵循渐进策略,并配置 conversion webhook 兼容旧版。 7. **避免竞争**:严禁多个 Operator 实例竞争管理同一 Group/Kind 的 CRD,否则将引发状态撕裂与无限调谐循环。通常通过 Leader Election 机制解决。


