
很多企业做数据管理时,经常遇到一个挺头疼的问题:一张报表里的数据,到底是从哪儿来的?
业务部门盯着销售额异常,搞不清楚是订单数据没抓全、同步延迟了,还是计算逻辑本身就出了岔子;技术人员这边,改一个字段也得小心翼翼,但根本不知道这个改动会波及哪些任务、哪些报表。
数据量是越堆越多了,但企业反而越来越难回答那几个最基础的问题:数据最初从哪里来?中间经过了哪些加工?现在被哪些业务在用?我改一下,又会影响到谁?
这些灵魂拷问,本质上就是数据血缘要解决的事。简单说,数据血缘就是帮企业梳理清楚数据从产生到消亡的完整脉络:它从哪里来、中间经历了什么、最终流向哪里,以及一旦发生变化,会牵动哪些业务环节。
下面,咱们就来具体拆一拆:什么是数据血缘?数据来源、流向和影响分析,到底该怎么看?
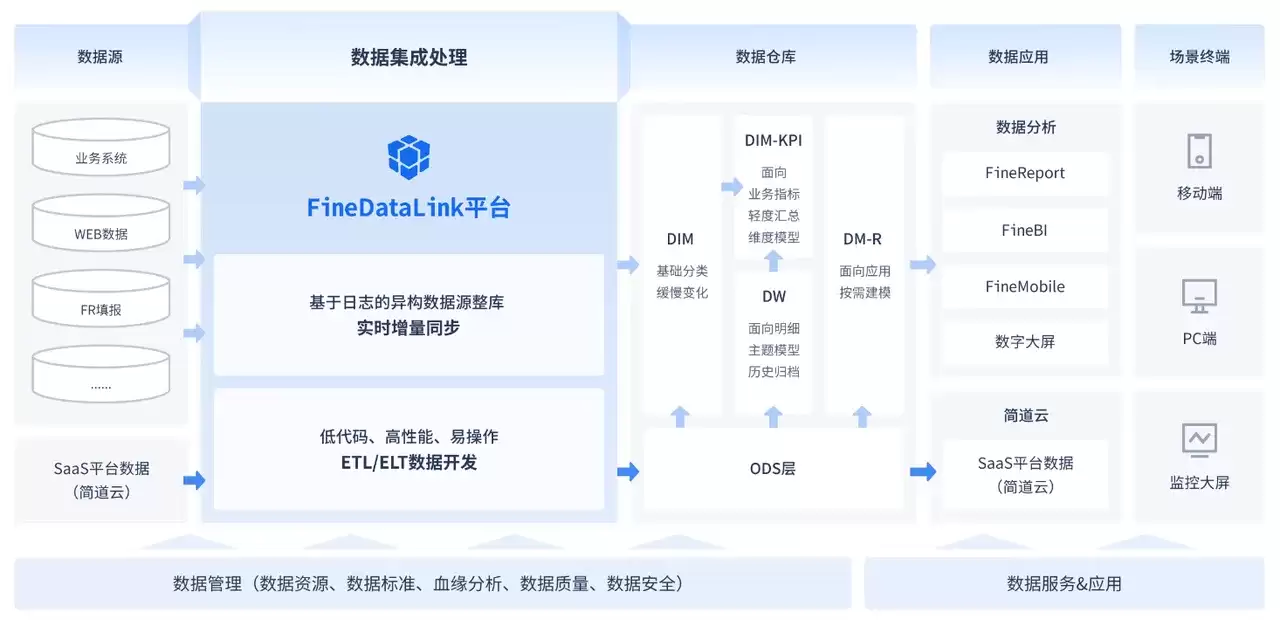
一、为什么企业需要数据血缘?
数据平台建设初期,关注点往往很直接:数据能不能接入,能不能出报表,能不能支撑业务决策。但当系统多起来、数据量上去之后,事情就没那么简单了。
原因在于,企业的数据并不是一堆静态的表格。一条业务数据从产生到被使用,通常会经历好几个环节。举个例子:订单数据产生于ERP系统,客户信息来自CRM,商品信息来自产品管理系统。这些数据被扔进数据平台后,还得进行关联处理——订单要匹配客户,商品要关联分类,金额要按照规则计算。只有走完这一整套流程,才能形成最终的销售分析数据。
如果企业没有把这些过程记录下来,那当业务人员发现销售指标异常时,就只能从结果反推原因。到底是订单源头的原始数据有问题?还是同步任务失败了?抑或是计算逻辑写错了?每一种可能性,都需要技术人员逐一排查。这也是很多企业数据运维效率低下的根本原因:数据明明存在,但彼此之间的关系一团乱麻。

数据血缘要解决的,就是这件事。通过血缘分析,企业可以清晰地知道:某个数据对象来自哪里,中间经过了哪些加工,最终被哪些业务使用。可以说,数据血缘就是一套描述数据生命周期的关系模型——它记录数据从产生、加工,到最终应用的全过程。比如:CRM客户表 → 客户主题数据 → 客户价值分析模型 → 销售分析看板。
很多企业的数据问题,并不是没有数据,而是不清楚数据为什么会形成当前的结果。这反而是最可怕的。

二、数据血缘主要分析哪些内容?
企业理解数据血缘时,通常关注三个方面,咱们一个一个来看。
1. 数据来源:搞清楚数据“出生地”
数据来源分析解决的是一个很朴素的问题:“这个数据,最初到底是从哪儿来的?”企业里的业务指标,很少是直接产生的。就拿“销售收入”这个指标来说,它可能来自订单系统,进入分析平台后,还得经过订单清洗、客户关联、商品分类、收入口径计算等一系列加工,最终才能变成报表上那个数字。
如果没有血缘信息,业务人员看到的就是一个最终结果,却无法确认:它用了哪些数据表?依赖了哪些字段?计算规则是什么?通过数据血缘,企业就能追踪到指标的“根”,让数据口径变得清晰、可追溯。

2. 数据流向:了解数据“被谁用”
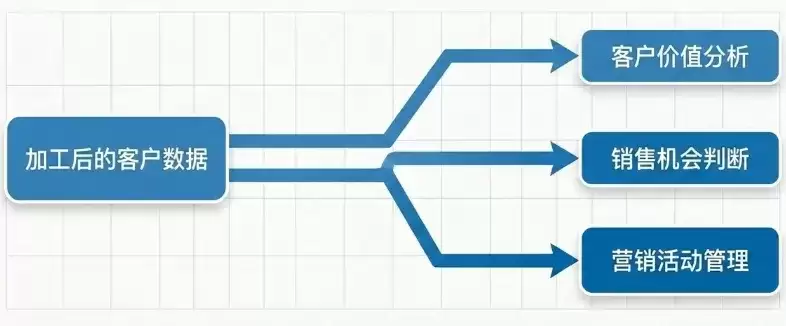
数据进入企业后,不会只服务于一个场景。比如,客户数据经过加工后,可以用于客户价值分析、销售机会判断、营销活动管理;库存数据处理后,可以用于库存周转分析、采购计划制定;设备数据加工后,可以用于设备状态分析。
数据血缘的价值在于,它能帮企业看清楚:一份数据被哪些任务引用了、哪些报表依赖它、哪些业务流程在用这个结果。这样一来,当你要调整数据结构时,就能提前判断出影响范围,不至于捅了篓子还不知道。
3. 数据影响:评估“改动的后果”
数据影响分析,是数据血缘最实用的应用场景之一。举个例子,开发人员打算修改订单表里的某个字段。如果没有血缘关系,根本没法判断:这个字段到底有没有被用到?哪些任务依赖它?哪些报表会受影响?
一个不留神,改完之后可能导致:指标计算错误、报表无法刷新、业务分析结果出现偏差。但如果有了影响分析,就能提前找到相关任务和应用,把风险降到最低。

三、如何做好数据血缘,先把数据链路理清
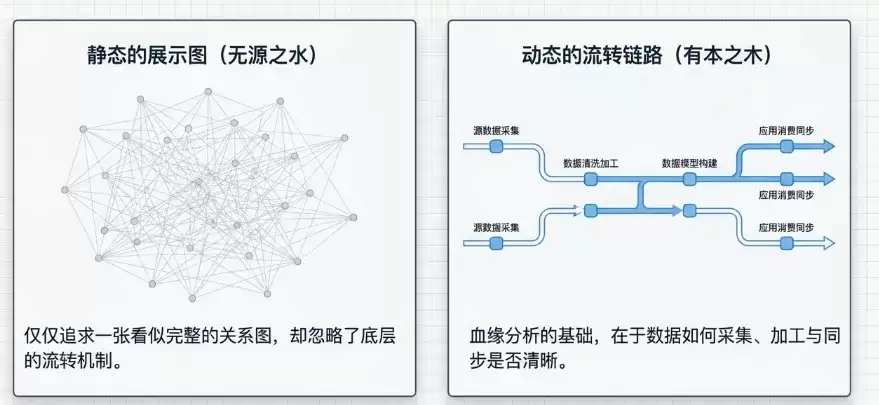
很多企业建设数据血缘时,容易一上来就盯着最终的展示效果,想着画一张完整的数据关系图。但实际上,血缘分析的基础是:数据流转过程是否清晰。如果企业连数据是怎么采集、怎么加工、怎么同步的都不知道,那血缘关系就是空中楼阁。
所以说,数据血缘的建设,往往需要和数据集成能力结合起来。

企业可以接入的数据源非常多样:ERP里的订单数据、CRM里的客户数据、MES里的生产数据、WMS里的库存数据,甚至还有数据库里的业务表和Excel里人工维护的数据。这些数据,都可以通过统一的方式进入数据平台。
在数据处理过程中,企业可以配置数据同步任务、字段转换规则、数据清洗逻辑、编码映射关系。比如,不同系统里的客户名称不一致、产品编号规则不同、日期格式存在差异,这些如果长期依赖人工修改,不仅效率低,结果也很难保证一致。
一旦通过统一逻辑来处理,后续数据更新时就稳定多了。同时,数据任务本身也成为数据血缘分析的重要基础——企业可以进一步了解:数据经过了哪些任务处理?任务运行是否正常?异常出现在哪个环节?

四、如何让企业实现数据血缘分析?
建立数据集成链路只是第一步。真正影响业务效率的,是数据出现异常时能不能快速定位问题,系统调整时能不能提前评估影响,业务追问指标时能不能解释清楚来源。这才是数据血缘分析的核心价值。
通过血缘分析,技术人员可以一目了然地看到:数据来自哪个系统、经过哪些处理任务、最终被哪些业务使用。企业的数据管理,也从过去维护大量数据表,转变为管理完整的数据流转关系。

1、从数据表查看上下游关系,降低维护成本
日常维护数据库时,经常遇到这样的问题:某张表还能不能改?某个字段删了有没有影响?这个数据表还有哪些业务在用?如果没有数据血缘,很多时候只能靠开发人员的经验来判断。尤其在系统越来越复杂之后,原开发人员可能了解全部逻辑,但新接手的人往往要花大量时间重新梳理。
但有了数据血缘,就能从数据表的角度,直接看到它上下游的关系。比如,一张销售数据表,通过血缘关系,可以查看它的来源:来自哪个业务系统、通过哪些任务同步、经过哪些加工处理。同时,也能看到它的下游应用:是否被分析任务调用、是否被数据服务使用、是否影响业务报表。对于系统升级、数据库优化、人员交接这些场景,这种能力能大大降低维护成本。

2、根据任务查看数据关系,提高开发管理效率
企业的数据加工,很少是由一个任务独立完成的。一个业务分析结果,可能依赖多个同步任务和转换任务。比如,销售分析数据,可能同时依赖订单同步任务、客户数据同步任务、商品维度加工任务。如果任务之间缺少关系记录,开发人员修改某个任务时,很容易忽略潜在影响。
3、支持SQL、同步、实时管道等多种数据场景
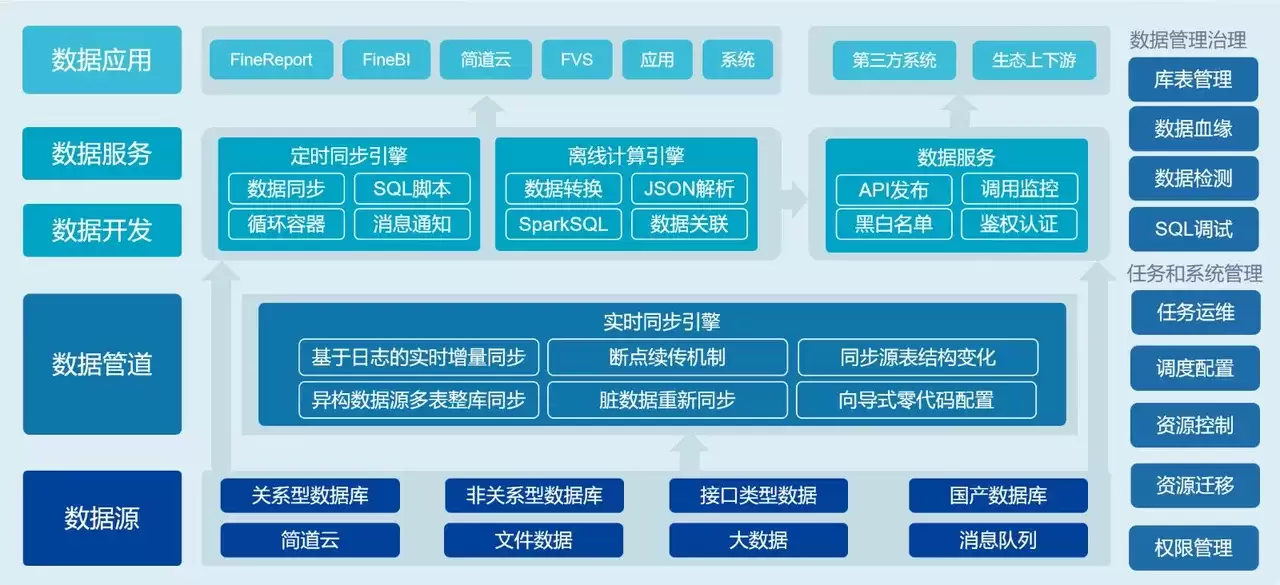
现在的数据加工方式越来越丰富,除了传统的数据同步,还包括SQL脚本处理、数据转换任务、实时管道任务、数据服务API。不同处理方式都会影响最终的数据结果。比如,通过SQL任务生成的数据,可以分析SQL中涉及的数据关系;通过同步任务产生的数据,可以查看源端和目标端之间的关联;通过实时管道处理的数据,可以了解实时数据流转过程;通过数据服务API,可以追踪接口使用的数据来源。
这样一来,企业就不仅仅是知道某张结果表在哪里,而是能进一步理解:这份数据为什么存在?经过哪些处理?服务哪些业务?

4、通过血缘分析辅助数据治理
很多企业开始做数据治理时会遇到一个问题:知道数据质量有问题,但不知道从哪里下手。比如,某个客户字段存在大量空值,问题可能来自CRM录入环节、数据同步过程,或者字段转换规则。如果没有数据链路信息,根本判断不了问题来源。而通过数据血缘分析,企业可以定位:问题数据来自哪里、经过哪些处理、影响哪些业务。

五、企业什么时候需要建设数据血缘?
并不是所有企业一开始就需要建设复杂的数据血缘体系。但随着业务发展,数据关系管理会逐渐成为一个绕不开的问题。

1、多业务系统并存,数据关系越来越复杂
很多企业最初只有ERP系统,随着业务发展,逐渐增加了CRM管客户、MES管生产、WMS管仓储、财务系统管经营数据。系统一多,数据之间的关联就越来越复杂。一个销售指标,可能同时依赖订单、客户、产品和成本数据。如果没有血缘管理,企业很难快速定位数据问题。
2、报表数量增加,但数据口径难统一
企业数字化建设过程中,会不断产生大量分析报表——销售分析、财务分析、供应链分析、生产分析,每个方向都有不同的数据需求。但问题是,报表越来越多,不代表数据管理越来越规范。如果指标没有明确来源,不同部门可能采用不同计算方式。
销售额到底按订单金额算,还是按回款金额算?库存金额包含不包含在途库存?利润包含不包含费用分摊?这些问题都需要通过数据来源和加工逻辑来确认。当数据处理过程标准化之后,业务人员使用的数据基础才会更加稳定。

3、数据异常频繁,需要提高定位效率
企业规模扩大之后,数据问题会更复杂。比如,某天经营分析报表无法刷新,原因可能包括:源系统字段发生变化、数据同步任务失败、数据处理逻辑调整、数据接口异常。如果没有血缘关系,技术人员只能逐层排查,费时费力。
写在最后
说实话,数据血缘要解决的,不只是数据关系展示问题。它解决的是企业在数据规模扩大之后,如何理解和管理数据的问题。
过去,企业关注的是数据有没有。随着数字化建设深入,大家更关心数据是否可靠,以及能不能持续支撑业务。因为当数据来源增加、加工链路变长之后,如果缺少清晰的数据关系,企业不仅难以定位问题,也很难推进数据治理。
数据血缘的价值,在于帮企业建立对数据生命周期的理解。企业可以进一步明确:数据产生的位置、数据加工的过程、数据使用的范围。而实现这些能力,需要稳定的数据集成基础。
当企业能清楚回答出“一份数据从哪里产生、经过哪些处理、影响哪些业务”时,数据才真正从数据库里的记录,转变为企业可以管理和利用的数据资产。


