
说到Netty的底层设计,Pipeline这个核心组件绝对是绕不开的关键环节。它就像一条数据流通的管道,所有的入站和出站事件都在这里流转。那么,这条管道到底是怎么搭起来的?里面的数据又是怎么依次经过各个处理器?今天就把这个问题彻底拆解开来看一看。
1 pipeline概述
先来一张架构图,看清楚pipeline在Netty中的宏观定位。

可以把它理解为一个链表,每个节点都是一个ChannelHandler,而链表的头尾分别是固定的head和tail节点。所有的事件——无论是数据读入、写出,还是异常——都会在这个链表上找到自己的传播路径。
2 pipeline初始化
当我们创建一个Channel时,pipeline的初始化工作就已经悄然开始了。下面这几张图展示了从Channel创建到pipeline就绪的完整链路。




初始化完成后,pipeline内部就是一条只有头尾的双向链表结构。

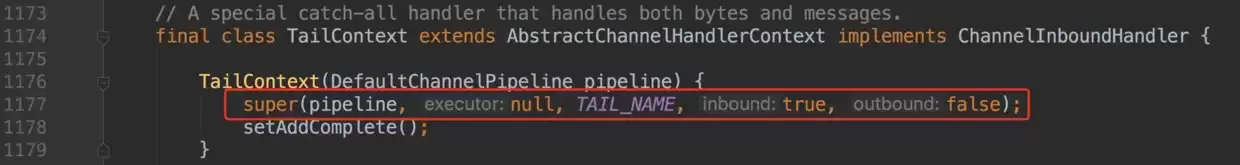
这个双向链表的每个节点,都封装了对应的事件处理器类型标识(是inbound还是outbound)以及前驱后继指针。看看它的实现类就清楚了。


再往下,是构成链表的基本数据结构组件,它们一起撑起了整个pipeline的运行骨架。
 看看其一个实现类
 基本数据结构组件




3 添加ChannelHandler
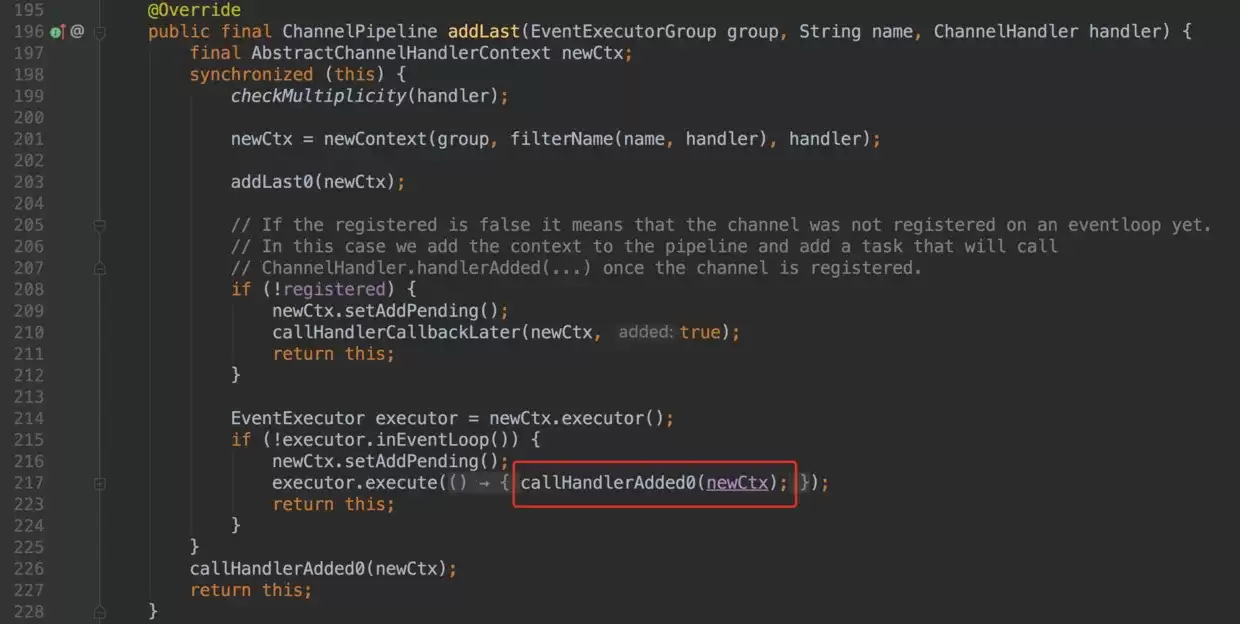
光有骨架还不够,我们得往里塞真正的业务处理器。先看用户代码是怎么添加的。







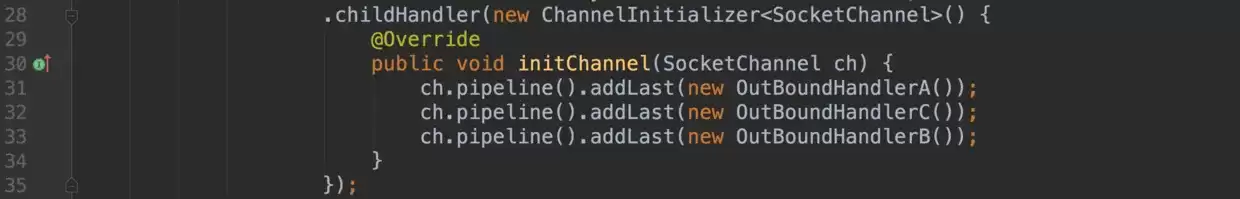
6 outBound事件的传播
理解了inbound事件的流向之后,outbound事件的传播就更容易掌握了。其实它的逻辑正好相反——inbound是从链表头向尾方向传播(找下一个inbound节点),而outbound则是从链表尾向头方向传播(找上一个outbound节点)。

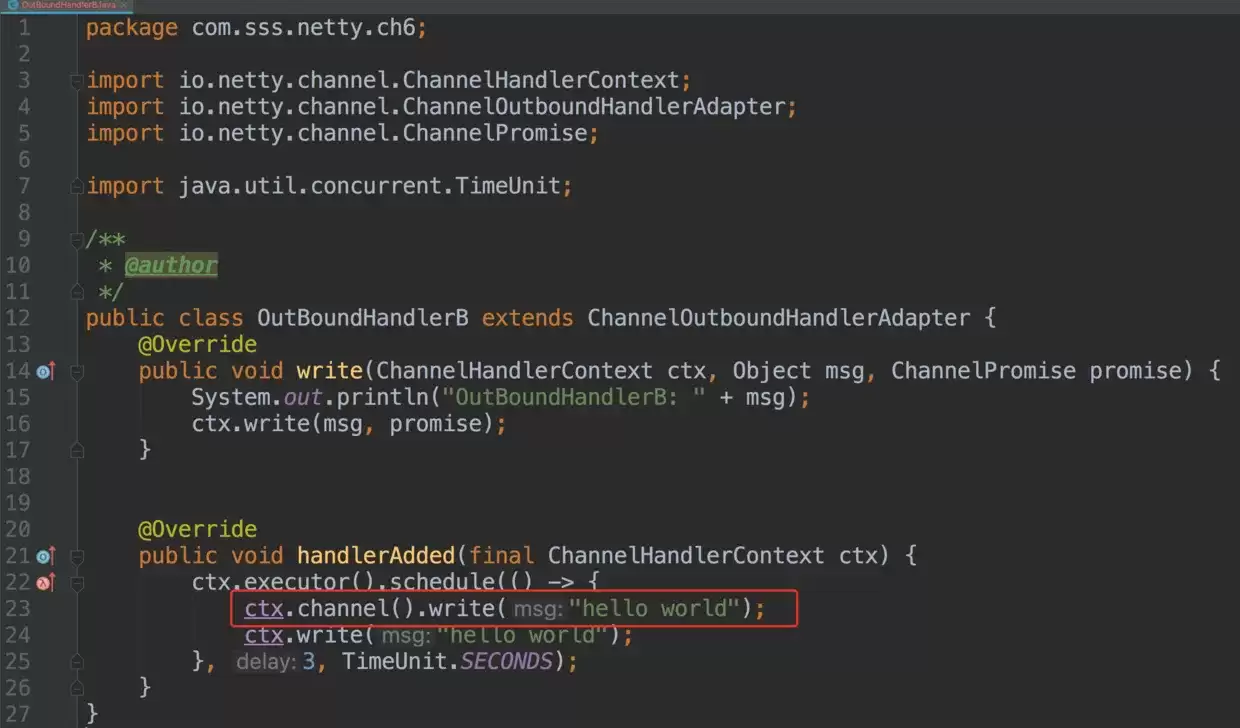


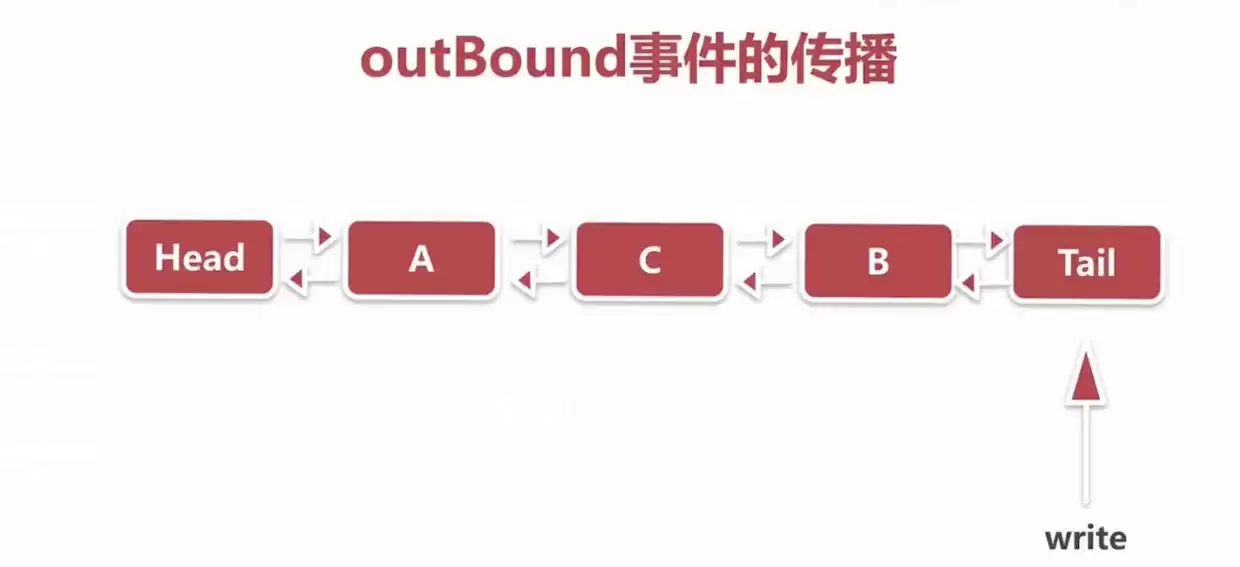


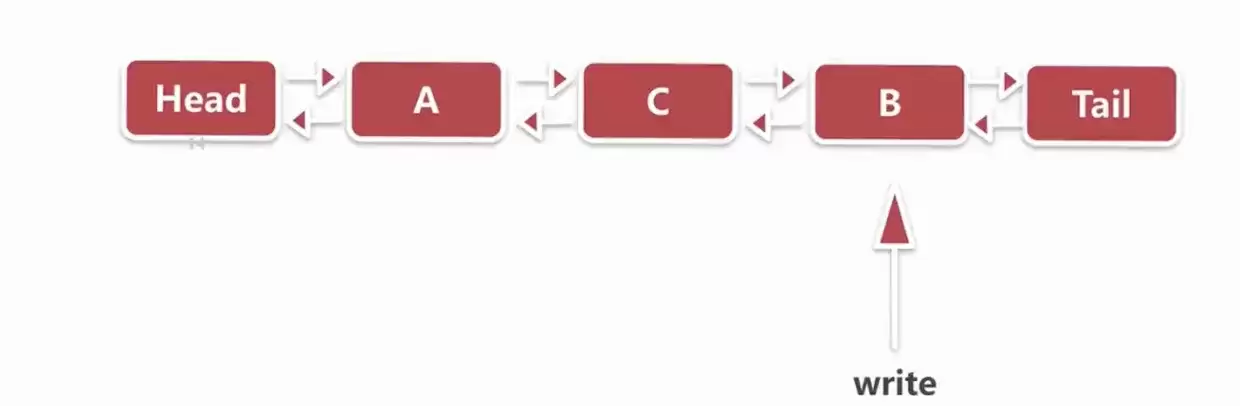

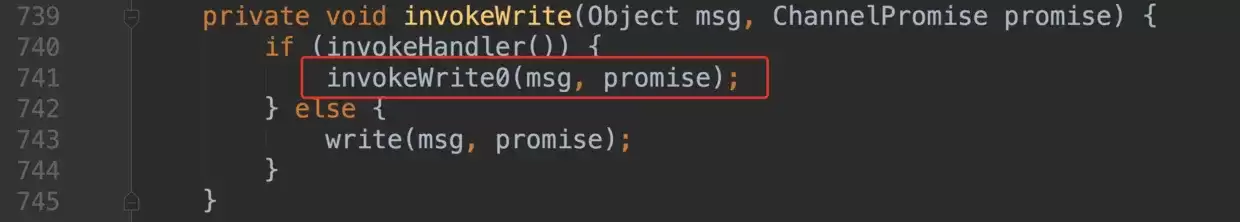
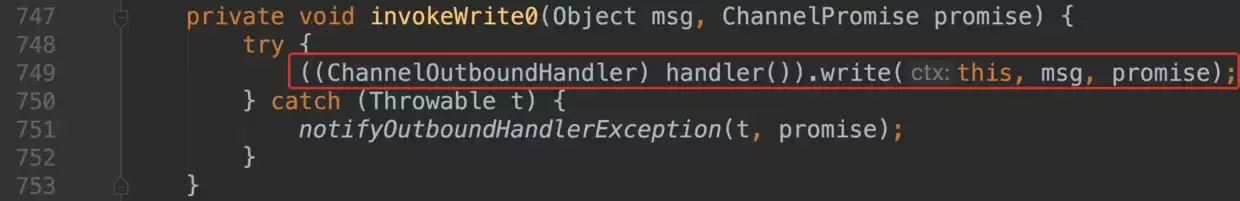

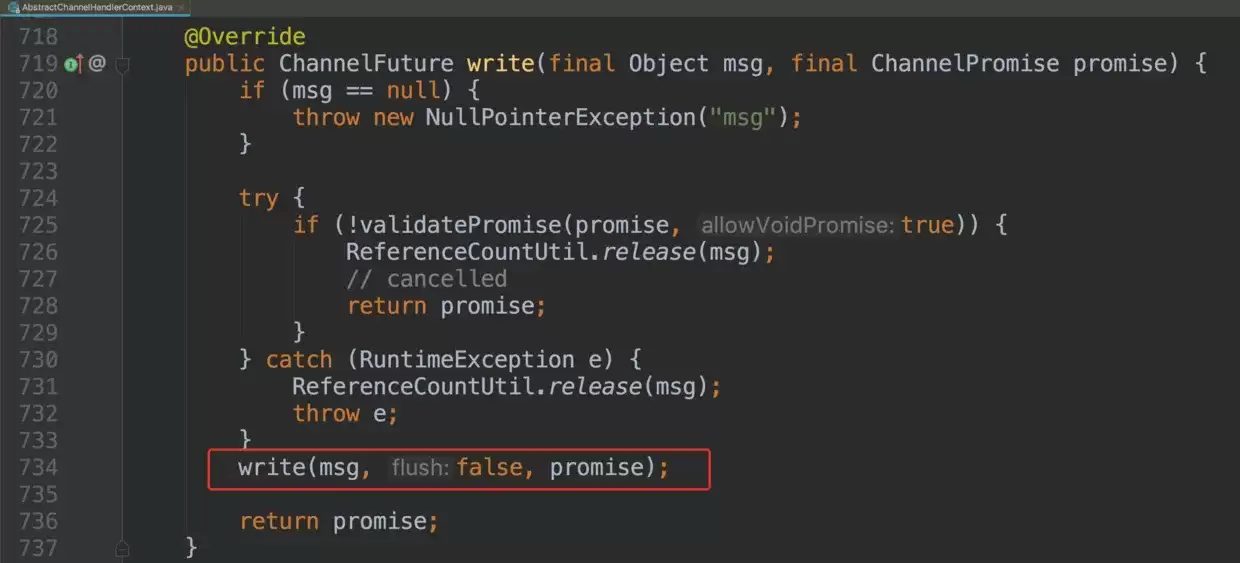

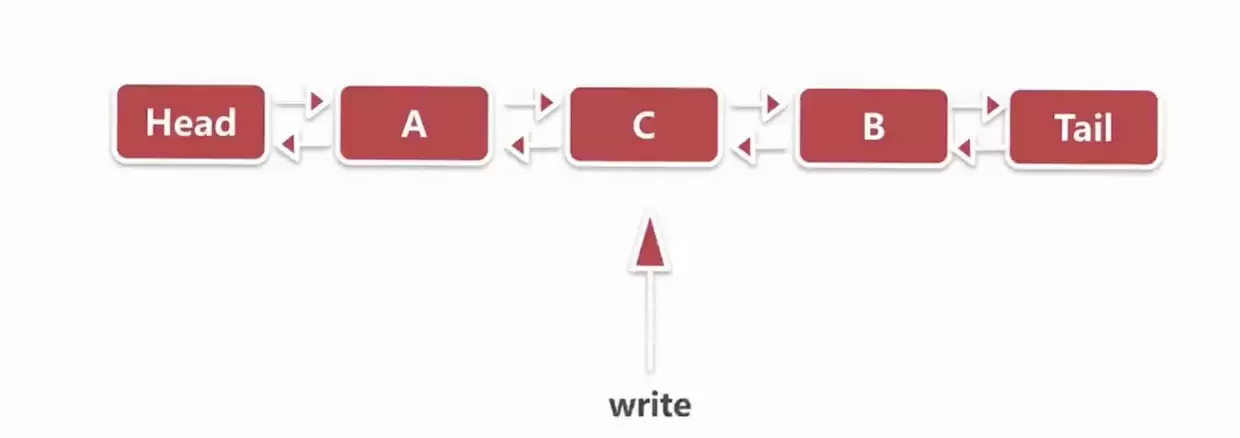 同理以后的过程

7 异常的传播
异常传播是一个特殊的场景。它不区分inbound还是outbound,而是沿着链表双向传播——既可以从head节点向tail方向走,也可以从tail节点向head方向走。具体从哪边开始,取决于异常是在哪个事件处理阶段被触发的。

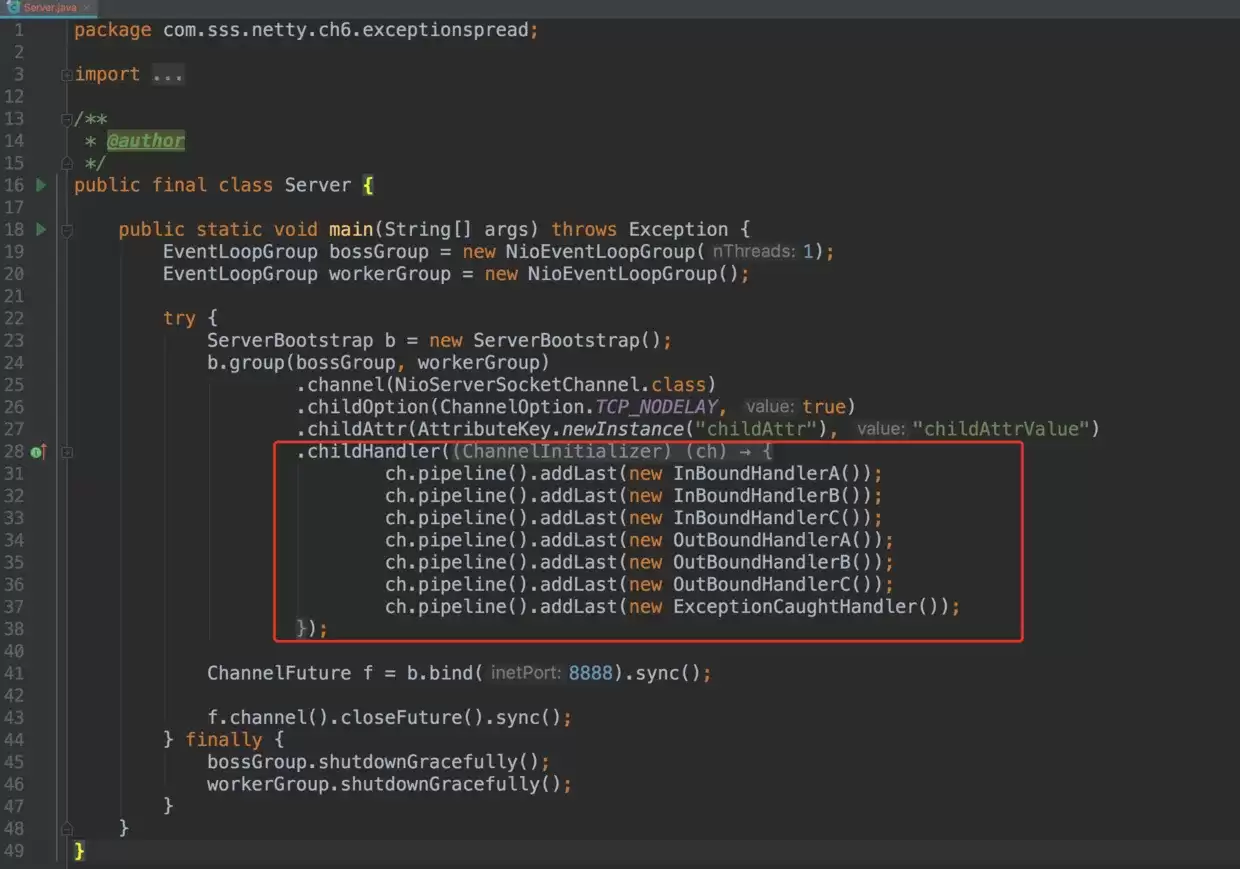


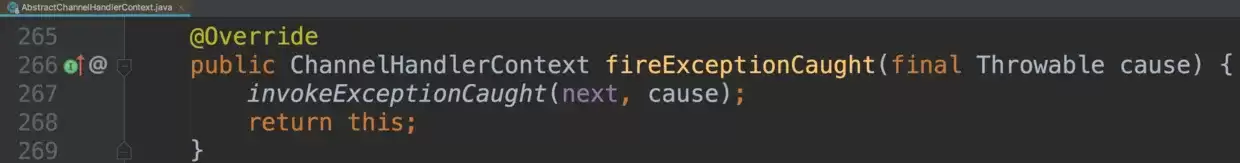
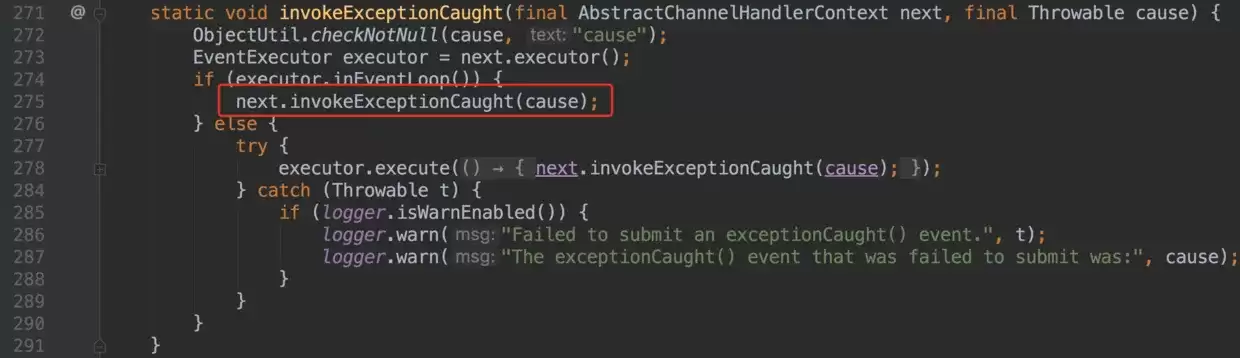
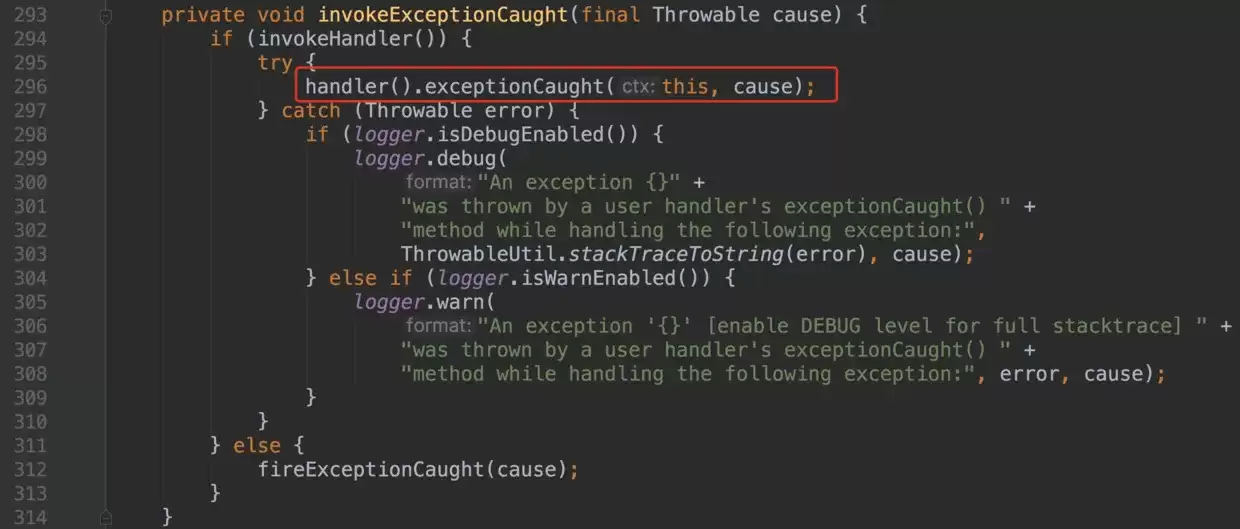


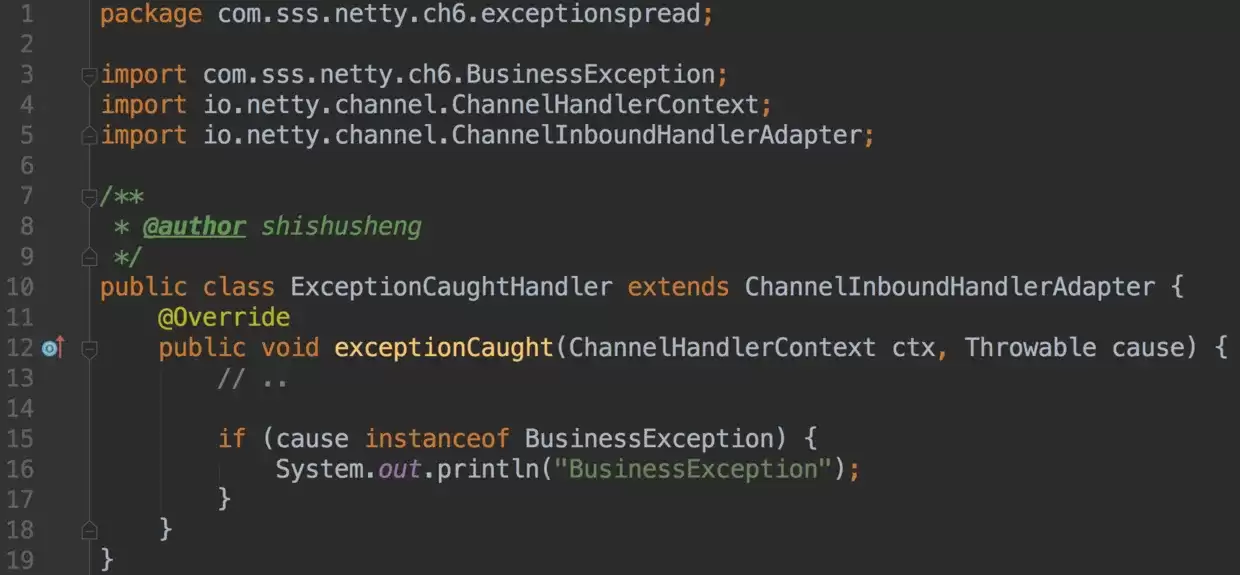
这里有个最佳实践需要特别注意:异常处理器一定要定义在管道的最后位置,否则默认会由tail节点打印一段警告信息就结束了。

所以,所有异常最终应该被一个专门的处理器兜底。
8 pipeline总结
最后,把pipeline的核心机制梳理一下。


调用 pipeline 添加节点时,Netty 会使用 instanceof 关键字判断当前节点是 inboound 还是 outbound 类型,分别用不同的 boolean 类型变量标识。

事件传播时的规则是这样的:inbound事件按照节点添加顺序,从head向tail方向依次传递;而outbound事件则相反,从tail向head方向逆序传播。

异常处理器要么从 head 或者 tail 节点开始传播。inbound事件则从当前节点开始传递到最后节点。outbound事件则从当前节点开始传递到第一个 outbound节点。


