
比赛背景
2019年6月,电子设计自动化顶级会议DAC在拉斯维加斯举办了低功耗目标检测系统设计挑战赛。西安交通大学人工智能与机器人研究所的XJTU-Tripler团队,凭借对算法和架构的深度优化,拿下了FPGA赛道的亚军——准确率IoU 61.5%,能耗9537J,帧率50.91Hz,功率9.248W。这也是国内唯一进入前三的队伍。目前,团队已计划开源比赛相关工具并提供后续支持。下面,我们就来拆解他们的设计方案。

DAC全称ACM/IEEE Design Automation Conference,是电子设计自动化和嵌入式系统领域的顶级会议。其系统设计大赛旨在为全球机器学习系统设计者提供交流平台,挖掘优秀方案和人才。赛制按FPGA和GPU两种硬件架构分别竞赛。FPGA赛道由Xilinx、大疆和英伟达赞助,使用无人机视角的训练数据集(9万张360x640图片,单目标标注),在5万张测试集上验证。最终,精度IoU高且能耗低的方案胜出。
任务部署
西安交大认知计算架构团队(XJTU-Tripler)由任鹏举副教授带领。硬件方面,他们使用了比赛方提供的Ultra96——Xilinx ZYNQ开发板,专为低功耗IoT环境设计,PS侧搭载四核ARM Cortex-A53 CPU(1.5GHz)。软件基于Python的PYNQ框架开发。团队成员分工明确:赵博然、赵文哲、夏天、陈飞、樊珑、宗鹏陈负责硬件开发;魏亚东、涂志俊、赵之旭、董志伟负责算法优化。
为了在检测精度与能耗之间找到平衡,团队选择了轻量级神经网络框架,并针对ZU3的资源限制,精简了之前设计的通用DNN翻跟斗HiPU,将其部署在ZU3的PL侧。主要工作分为算法优化和架构设计优化两块。
算法优化
- 选择ShuffleNet V2作为特征提取主框架
- 选择YOLO作为单目标位置回归框架
- 对神经网络进行8bit量化
HiPU优化
- 支持CONV、FC、Dep-wise CONV、Pooling、Ele-wise Add/Mul等操作,峰值算力268Gops,效率大于80%
- 支持Channel shuffle、divide、concat操作,且不消耗额外时间
- 提供C、RISC-V汇编接口的API,调度灵活
- HiPU完全由PL侧实现,不依赖PS侧。PS主要承担图片预处理和结果输出
相关技术详解
单目标检测网络选择
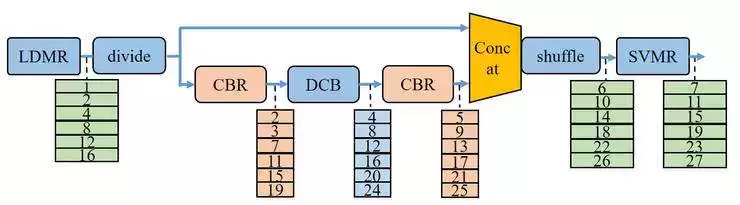
为了满足移动端实时性,团队最终选定YOLO作为基础检测框架,并自行定制了网络ShuffleDet——将特征提取网络替换为轻量级ShuffleNet V2(参数规模略大于1X)。下图是定制网络的示意图。

ShuffleDet的网络结构示意图
神经网络的训练与量化
团队先在ImageNet数据集上预训练了一个标准ShuffleNet V2分类网络。模型收敛后,将前三层特征提取部分的参数重载回ShuffleDet网络,再用比赛方的训练集进行全部层参数训练。为了适配FPGA的定点运算,训练完成后对所有参数进行量化:将网络参数和feature map均量化为8bit定点。量化过程分三步:1) 将BN层合并到参数中;2) 将合并后的参数对称量化;3) 离线量化后对参数进行fine tune。下图清晰展示了量化流程。

网络参数的量化流程
量化后,最终网络ShuffleDet的卷积层约74层,权重约1.94MB,Bias约78KB。量化前全精度准确率67.1%,量化后61.5%,精度损失5.6%。
关于HiPU
1) 整体概况
西安交大团队主要面向专用集成电路(ASIC)设计,FPGA上的实现主要是功能验证。针对赛方提供的计算平台,他们对HiPU进行了裁剪以适应ZU3资源。下图是裁剪后的HiPU设计框图及特性。HiPU工作在233MHz,峰值算力268Gops;采用C/RISC-V汇编作为编程接口,卷积效率平均80%以上。

HiPU的结构框图与特性
HiPU支持各种常见NN运算,包括CONV、FC、Dep-wise CONV、Pooling、Ele-wise Add/Mul等,其中FC可以接近100%计算效率。同时支持channel方向的shuffle、divide、concat操作,当这些操作紧跟在卷积运算之后时,可在硬件上合并,不消耗额外时间。HiPU可以工作在任何种类Xilinx FPGA上,不受Zynq架构限制。底层实现矩阵、向量、标量运算,在做好调度的情况下可支持任意类型并行计算。未来计划实现稀疏矩阵运算优化,以支持高效率的DeCONV运算和feature map稀疏优化。
2) HiPU优化点分析——通过层间级联减少所需DDR带宽
HiPU设计的性能瓶颈有两个:MAC运算单元利用率,以及数据传输网络能否匹配MAC所需数据。数据传输网络限制大多来自DDR接口,本设计专门针对DDR接口进行了优化。由于HiPU中SRAM大小有限,无法将一层feature map完全放进去。如果采用常规计算次序,每层feature map结果都要返回DDR,对DDR带宽需求极大,也额外消耗功耗。团队通过层间级联方式降低DDR带宽需求——以ShuffleNet的bottleneck为分界,从每个bottleneck的输入处从DDR读取一行feature map,依次计算完所有层后,输出的一行feature map才写回DDR,依次计算完所有行。下图展示了Module C的层间级联计算次序。
Module-C采用层间级联计算方式
3) HiPU优化点分析——输入图像格式转换提升处理效率
HiPU一次并行计算8个输入channel。但网络第一层输入图像只有RGB三个通道,导致计算效率仅为3/8。为此,团队设计了一个输入图像转换模块:如果Conv1的kernel宽度为3,则将输入图像通道从3扩展到9,最终使第一层处理效率从0.38提升到0.56。转换示意图如下。

输入图像在行方向上的转换
系统优化设计与分析
1) 图像解码与卷积神经网络计算并行化
HiPU仅依赖Zynq PL侧资源,PS侧可空出来做系统IO。团队在处理当前图片检测运算时,在PS侧预读并解码下一幅图片,提高并行度,使整体检测帧率从30.3Hz提升到50.9Hz。下图展示了并行化前后的流程对比。
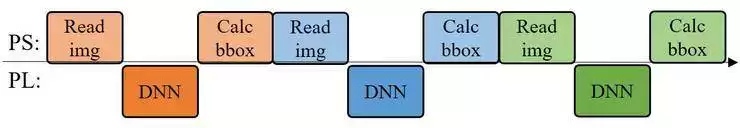
(a) 并行化之前的工作流程
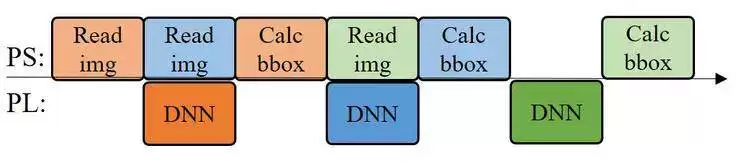
(b) 并行化之后的工作流程
图像解码与卷积神经网络并行化的示意图
2) 使用C代码加速PS侧原来的Python代码
团队用C代码重构了PS侧比较耗时的操作,并在Pynq框架中通过ctypes接口调用。具体包括:预先计算PL侧数据中置信度和bbox坐标的地址指针;找到最大置信度和对应BBox坐标,再根据相对坐标计算出绝对坐标。
3) 使用门控时钟降低PL侧能耗
为了降低系统能耗,团队设计了门控时钟策略:当HiPU计算完一张图片时自动关闭时钟,下一张图片开始计算时再激活。这个策略基于两个原因:首先,jpg图片解码时间不固定(SD卡型号不同,均值7-12ms,部分图片可达100ms);其次,系统功耗测量进程和其他开销会占用CPU时间,且PS和PL共享DDR带宽,导致HiPU在166MHz时帧率约50Hz,但升高到200MHz时帧率仍维持在50Hz左右。这两个原因导致HiPU处理时间和图片解码时间匹配变得不固定;当HiPU处理时间比解码时间短时,就会“空跑”浪费能量。另外,针对抢占DDR带宽的情况,还需要继续优化。
结果
全球共有58支队伍注册了FPGA比赛任务,仅11支队伍提交了设计(完赛率19%)。冠军是iSmart3(UIUC、IBM、Inspirit IoT联合组队),亚军是XJTU-Tripler(西安交通大学),季军是SystemsETHZ(ETH Zurich)。值得一提的是,XJTU-Tripler是唯一使用Verilog(而非HLS)进行设计的获奖队伍,其高性能DNN翻跟斗支持了参赛队伍中最大的神经网络规模。最终竞赛成绩如下:

DAC19系统设计竞赛排名

资源情况比较
同样的ShuffleDet算法也在TX2平台上进行了部署。下表是两者的对比分析:8bits量化造成了5.6%的IoU绝对损失(-8.3%),但带来了28.87帧率提升(131%)和8309J能耗减少(-46.56%)。

ShuffleDet在TX2和Ultra96 FPGA平台上的性能比较


