
这篇文章,会带你把冒泡排序从头到尾捋一遍——有些部分你肯定熟悉,有些细节可能还真不一定留意过。
1. 什么是冒泡排序
很多人接触的第一个排序算法,大概率就是冒泡排序。不少文章喜欢把它比作碳酸饮料里的气泡,或者鱼吐的泡泡,确实很形象。换个角度,把数组竖着放进一杯水里,值小的元素密度小,自然往上浮,值大的密度大,慢慢沉到底部。这个比喻,基本就把冒泡排序的核心逻辑说清楚了。
2. 排序过程展示
先不扯复杂度和理论,直接用一张动图来感受一下冒泡排序是怎么运作的。

动图里,不同“密度”的元素上浮下沉,过程一目了然。
3. 算法V1
3.1 代码实现
private void bubbleSort(int[] arr) {
    for (int i = 0; i < arr.length; i++) {
        for (int j = 0; j < arr.length - 1; j++) {
            if (arr[j] > arr[j + 1]) {
                exchange(arr, j, j + 1);
            }
        }
    }
}
private void exchange(int arr[], int i, int j) {
    int temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}
int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]
3.2 实现分析
看到这段代码,先别激动,这可能是很多人的第一个冒泡排序版本——包括很多初学者在内,写出来之后还觉得自己挺厉害的,觉得算法不过如此。
还是拿数组[5, 1, 3, 7, 6, 2, 4]来演示,动图如下。

思路其实很简单:两层循环,外层控制一共需要跑多少轮(数组长度减1),内层从左到右两两比较,把大的元素交换到右边。这就是V1版本的全部。
| 算法执行情况 | 结果 |
|---|---|
| 样本 | [0 - 100000] 的乱序数组 |
| 算法 V1 执行的总次数 | 99990000 次(9999万次) |
| 算法 V1 运行 100 次的平均时间 | 181 ms |
4. 算法V2
4.1 实现分析
仔细看动图会发现,每一轮冒泡都会把当前最大的数“顶”到最右边。也就是说,第一轮结束后,数组最大的元素已经归位了;第二轮结束后,第二大的元素也归位了……既然如此,后面的轮次就没必要再去比较已经排好序的尾部区域了。
以下图为例,第一轮冒泡后数组的状态如图。

第二轮排序后如下。

每轮都能确定一个最大值,所以内层循环的边界就可以逐步缩小——这正是V2要做的优化。
4.2 代码实现
private void bubbleSort(int[] arr) {
    for (int i = 0; i < arr.length - 1; i++) {
        for (int j = 0; j < arr.length - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                exchange(arr, j, j + 1);
            }
        }
    }
}
private void exchange(int arr[], int i, int j) {
    int temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}
int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]优化后的内层循环只跑到arr.length - 1 - i,避免了重复比较已经有序的部分。动图展示的就是这个版本。
| 算法执行情况 | 结果 |
|---|---|
| 样本 | [0 - 10000] 的乱序数组 |
| 算法 V2 执行的总次数 | 49995000 次(4999万次) |
| 算法 V2 运行 100 次的平均时间 | 144 ms |
| 运行时间与 V1 对比 | V2 运行时间减少 20.44 % |
| 执行次数与 V1 对比 | V2 运行次数减少 50.00 % |
执行次数直接砍半,时间也降了20%,性能提升明显。但,这就算完美了吗?
4.3 哪里可以优化
假设数组元素是这样的:
一步步执行V2,看看会怎样。
第一轮结束后:

继续推进,第一轮所有比较完成后:
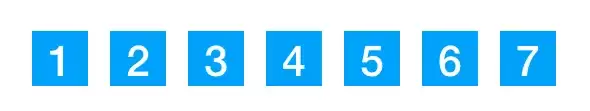
这时候数组已经有序了,但V2仍然会继续跑完剩下的5轮——如果数组长度是100000,浪费的计算量就非常可观了。
5. 算法V3
5.1 代码实现
private void bubbleSort(int[] arr) {
    for (int i = 0; i < arr.length - 1; i++) {
        boolean flag = true;
        for (int j = 0; j < arr.length - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                flag = false;
                exchange(arr, j, j + 1);
            }
        }
        if (flag) {
            break;
        }
    }
}
private void exchange(int arr[], int i, int j) {
    int temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}
int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]
5.2 实现分析
V3在V2的基础上加了一个布尔标志flag,每轮开始前设为true。如果这一轮中没有任何交换发生,说明数组已经有序,直接跳出外层循环,不再继续后面的轮次。
| 算法执行情况 | 结果 |
|---|---|
| 样本 | [0 - 10000] 的乱序数组 |
| 算法 V3 执行的总次数 | 49993775 次 |
| 算法 V3 运行 100 次的平均时间 | 142 ms |
| 运行时间与 V2 对比 | V3 运行时间减少 00.00 % |
| 执行次数与 V2 对比 | V3 运行次数减少 00.00 % |
5.3 数据分析
看到这个结果你可能有点懵:优化了个寂寞?执行次数和时间都没变。其实,V3的优化针对的是“数组已经部分有序”的场景。如果数据本身就是完全乱序的,V3自然发挥不出优势。但换一个样本,比如[9999, 1, 2, …, 9998],效果就完全不同了。
| 算法执行情况 | 结果 |
|---|---|
| 样本 | [0 - 10000] 的乱序数组 |
| 算法 V3 执行的总次数 | 19995 次 |
| 算法 V3 运行 100 次的平均时间 | 1 ms |
| 运行时间与 V3 乱序样例对比 | V3 运行时间减少 99.96 % |
| 执行次数与 V3 乱序样例对比 | V3 运行次数减少 99.29 % |
提升非常明显。
5.4 适用情况
当冒泡排序进行到后半段,数组已经有序时,V3可以提前终止,避免无谓的循环。
6. 算法V4
等等,还没结束。还有一种情况没有考虑到。
6.1 适用情况总结
- V1:正常乱序数组
- V2:正常乱序数组,但优化了执行次数
- V3:大部分元素已经有序的数组,可以提前结束
还有一种情况:冒泡轮数没跑完,甚至刚开始,但数组后半段已经有序了。比如下面这个数组:

这种情况下,V3的提前终止条件不会触发,因为每一轮都有交换发生(前半段还没排好)。但后半段已经有序了,其实没必要再比较。怎么处理?
6.2 实现分析
在V3的基础上,增加一个变量endIndex,记录每一轮最后一次发生交换的位置。下一轮的内循环只需要跑到这个位置就行了,因为后面的元素没有发生过交换,必定有序。
第一轮结束后,元素3被移动到了下标2的位置,之后就不再需要比较下标2之后的元素了。
6.3 代码实现
private void bubbleSort(int[] arr) {
    int endIndex = arr.length - 1;
    for (int i = 0; i < arr.length - 1; i++) {
        boolean flag = true;
        int endAt = 0;
        for (int j = 0; j < endIndex; j++) {
            if (arr[j] > arr[j + 1]) {
                flag = false;
                endAt = j;
                exchange(arr, j, j + 1);
            }
        }
        endIndex = endAt;
        if (flag) {
            break;
        }
    }
}
private void exchange(int arr[], int i, int j) {
    int temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}
int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]
7. 算法V5
这一节依然不是结束语……
7.1 算法优化
再来看这种情况:

对于这种数组,前面的算法都没法发挥优势——每一轮都有交换,而且直到排序完成前数组都不是有序的。但如果能直接从右向左冒泡,一轮就能搞定。这就是鸡尾酒排序(双向冒泡排序),它正是针对这种“大部分有序但最小元素在末尾”的场景。
7.2 代码实现
private void bubbleSort(int[] arr) {
    int leftBorder = 0;
    int rightBorder = arr.length - 1;
    int leftEndAt = 0;
    int rightEndAt = 0;
    for (int i = 0; i < arr.length / 2; i++) {
        boolean flag = true;
        // 从左到右
        for (int j = leftBorder; j < rightBorder; j++) {
            if (arr[j] > arr[j + 1]) {
                flag = false;
                exchange(arr, j, j + 1);
                rightEndAt = j;
            }
        }
        rightBorder = rightEndAt;
        if (flag) {
            break;
        }
        flag = true;
        // 从右到左
        for (int j = rightBorder; j > leftBorder; j--) {
            if (arr[j] < arr[j - 1]) {
                flag = false;
                exchange(arr, j, j - 1);
                leftEndAt = j;
            }
        }
        leftBorder = leftEndAt;
        if (flag) {
            break;
        }
    }
}
private void exchange(int arr[], int i, int j) {
    int temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}
int[] arr = new int[]{2, 3, 4, 5, 6, 7, 1};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]
7.3 实现分析
外层循环控制总轮数,每轮包含一次从左到右和一次从右到左的冒泡(总轮数为数组长度的一半)。同时结合了V4的优化,记录每一方向最后一次交换的位置。
| 算法执行情况 | 结果 |
|---|---|
| 样本 | [2,3,4…10000,1] 的数组 |
| 算法 V5 执行的总次数 | 19995 次 |
| 算法 V5 运行 100 次的平均时间 | 1 ms |
| 运行时间与 V4 对比 | V5 运行时间减少 99.97 % |
| 执行次数与 V4 对比 | V5 运行次数减少 99.34 % |
8. 总结
下表是对同一个乱序数组,各算法运行100次的平均时间和执行次数对比。
| [0 - 10000] 的乱序数组 | V1 | V2 | V3 | V4 | V5 |
|---|---|---|---|---|---|
| 执行时间(ms) | 184 | 142 | 143 | 140 | 103 |
| 执行次数(次) | 99990000 | 49995000 | 49971129 | 49943952 | 16664191 |
| 大部分有序的情况 | V1 | V2 | V3 | V4 | V5 |
|---|---|---|---|---|---|
| 执行时间(ms) | 181 | 141 | 146 | 145 | 107 |
| 执行次数(次) | 99990000 | 49995000 | 49993230 | 49923591 | 16675618 |
冒泡排序的时间复杂度,最好情况是O(n)——比如V5中提到的[2, 3, 4, 5, 6, 7, 1],用鸡尾酒排序只需一轮。最坏情况是O(n²)——比如V1、V2、V3、V4面对大部分乱序数据时的表现。


