
阿里云函数计算FC代码包超限解决方案:3大方案:依赖瘦身、层管理与OSS挂载
在部署阿里云函数计算 FC 时,代码包体积超限是一个应在架构设计阶段提前规避的典型问题。很多开发者往往是在控制台提示“包大小超出限制”后,才发现上传的压缩包已经膨胀到上百 MB。想要真正解决阿里云 FC 代码包过大、部署失败这类问题,不能只在报错出现时临时删文件,而是要回到函数打包方式、依赖组织结构以及资源存储策略本身,先弄清楚限制规则与超限原因,再制定长期可用的优化方案。
本文由 云国际服务商『 云老大 飞弟:@yunlaoda360 / YunLaoDa-云服务器•运维部门•撰写』如需转载请注明!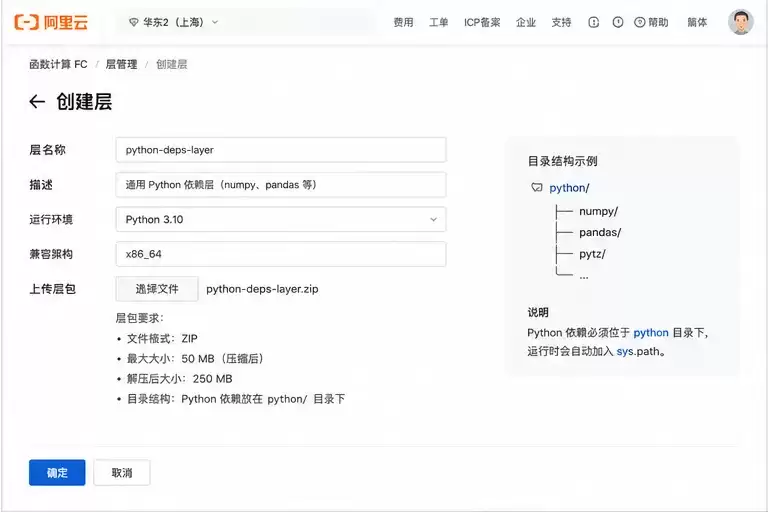
项目目标
本文旨在解决阿里云函数计算(FC)部署过程中常见的代码包体积超限问题。通过依赖瘦身、层管理以及 OSS 挂载三种可落地方案,确保函数代码包压缩后不超过 100 MB、解压后不超过 500 MB,同时保证函数服务能够稳定运行。
最终效果
- 代码包压缩后体积控制在 100 MB 以内,解压后的目录总大小不超过 500 MB。
- 函数冷启动时间基本不受明显影响,依赖加载正常,文件与资源读写保持稳定。
- 实现重型依赖与大体积资源的解耦存储,提升函数部署效率、运维灵活性和后续可维护性。
技术方案
针对阿里云函数计算 FC 代码包超限的不同成因,可以单独使用或组合使用以下三种方案:
- 依赖瘦身:删除无用依赖、调试文件、缓存文件和测试内容,尽可能压缩部署包体积。
- 层管理:把通用依赖拆分为自定义层,供多个函数共享,显著减小主代码包大小。
- OSS挂载:将大文件,如模型权重、静态资源、模板文件等存储到 OSS,函数运行时通过挂载路径读取,避免直接打包进代码。
环境与依赖
- 平台:阿里云函数计算(FC)
- 运行时:Python 3.8、Node.js 等(本文以Python为例)
- 本地工具:Python 3.x、pip、zip、docker(可选,用于模拟环境)
- 依赖管理:
requirements.txt - 存储服务:阿里云OSS、阿里云NAS(可选)
项目结构
下面以一个典型的 Python 函数项目为例,展示在使用层管理和 OSS 挂载之后的推荐目录结构:
my-function/
├── index.py          # 业务代码
├── requirements.txt  # 轻量依赖(如 requests)
├── .funcignore       # 忽略规则
└── vendor/           # 通过 --target 安装的依赖(可选,如不使用层)
层文件结构(制作层时):
my-layer/
└── python/           # 必须为 python 目录
    ├── numpy/
    ├── pandas/
    └── ...
OSS 挂载点方面,函数内部可通过挂载路径(例如 /mnt/oss)直接读取模型文件或其他大资源。
核心实现
方案一:依赖瘦身
移除无用依赖与调试文件
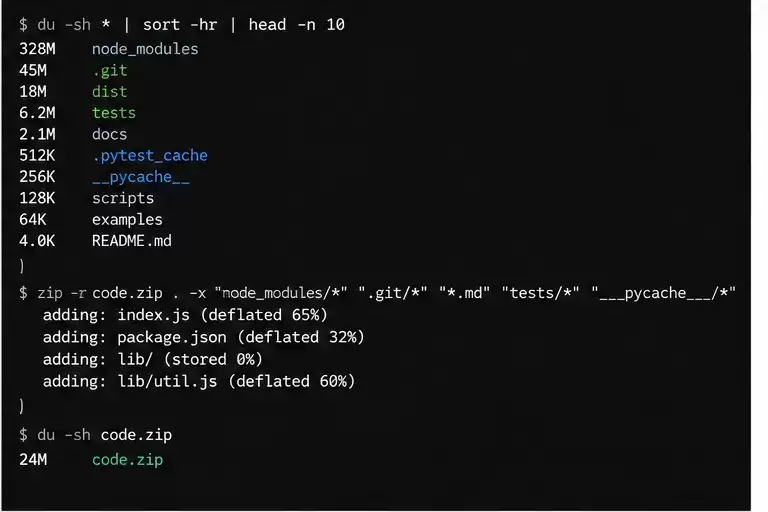
在打包前,应优先清理 __pycache__、.egg-info、测试目录、README、示例文件等非运行必需内容。可以通过 .funcignore 配置忽略规则,也可以结合自动化脚本批量清理,以减少无效文件被打入部署包。
使用 pip install --target 精简依赖
执行以下命令,将生产环境真正需要的依赖安装到指定目录,避免引入缓存文件与源码编译中间产物:
pip install -t ./vendor -r requirements.txt --no-cache-dir --only-binary=:all:
安装完成后,还可以进一步清理 .dist-info 目录中的 metadata 文件。虽然这一步并非必须,但在函数计算 FC 代码包接近上限时,往往能继续节省一部分空间。
压缩图片与静态资源
如果项目中包含图片、字体或前端静态资源,可使用 optipng、jpegoptim 等工具进行无损压缩,字体文件则可通过提取子集字符来缩小体积。若静态资源累计已超过数十 MB 甚至上百 MB,通常就不建议继续打包进函数代码,而应配合层管理或 OSS 挂载一起处理。
方案二:层管理
创建自定义层并上传依赖
- 先在本地执行以下命令,将依赖安装到
python目录:
pip install -t ./python -r requirements.txt --no-cache-dir
- 删除冗余文件:
find . -name "*.pyc" -o -name "__pycache__" -o -name ".egg-info" -o -name "tests" | xargs rm -rf
- 打包层:
zip -r my-layer.zip python
- 在阿里云 FC 控制台中创建层,上传
my-layer.zip,并选择匹配的运行时版本。
注意:Python 依赖必须放在 python 文件夹下,否则运行时在执行 import 时会找不到模块。建议在本地使用 Docker 模拟线上环境进行验证,以避免层结构正确但运行仍报错的情况:
docker run --rm -v "$PWD":/var/task lambci/lambda:python3.8
在函数中引用层
- 进入函数配置界面,添加层并选择已创建的自定义层及其对应版本。
- 保存配置后,层内容会自动挂载到
/opt目录,Python 运行时会自动将/opt/python加入sys.path,因此业务代码中可直接import numpy使用相关依赖。 - 在版本管理上,层更新之后,函数需要显式切换到新版本才会生效,这种机制也便于做灰度验证和回滚控制。
方案三:OSS挂载
配置NAS文件系统挂载(可选)
在函数配置页面的“存储”选项中,可以启用 NAS 挂载,选择已创建的 NAS 文件系统并设置挂载路径。NAS 属于持久化文件存储,比较适合跨函数共享状态、共享资源文件,或者大量静态文件需要频繁读取的业务场景。
通过OSS挂载实现动态文件读写
- 先将模型文件、模板资源、素材文件等上传到 OSS Bucket。
- 然后在函数中配置 OSS 挂载点(例如
/mnt/oss),业务代码通过挂载路径直接读取文件,代码包内部只保留必要的轻量 SDK 逻辑与主程序代码。 - 需要注意的是,OSS 挂载在写入延迟方面通常高于本地 SSD。如果是高并发写入场景,建议先写入
/tmp临时目录,再统一上传回 OSS,以提升稳定性和吞吐表现。

配置说明
- 依赖瘦身:建议在构建脚本或 CI 流程中自动执行清理命令,并通过
.funcignore忽略__pycache__、.git、node_modules/.cache等无关目录。 - 层管理:在 FC 控制台创建层时,需要明确指定兼容的运行时版本(如 Python 3.8)和架构(amd64/arm64)。
- OSS挂载:在函数配置中开启 OSS 挂载后,选择对应的 Bucket 和挂载路径即可。需要额外注意,OSS 挂载的写入一致性相对较弱,若业务对强一致性要求较高,建议优先考虑 NAS。
运行方法
- 根据业务体积与依赖特点,选择一种方案,或将多种方案组合使用。
- 代码包中可使用
vendor目录保存精简依赖(瘦身方案),也可以通过层加载依赖,或通过 OSS 挂载方式读取大文件资源。 - 在本地使用
zip打包函数代码时,务必排除不必要文件,并在压缩完成后检查体积是否小于 100 MB。 - 通过阿里云函数计算 FC 控制台或 CLI 部署函数,上传代码包,同时配置层和挂载点等附加能力。
- 触发函数执行,验证依赖导入、资源访问和读写流程是否全部正常。
结果验证
可以通过以下检查清单,确认阿里云 FC 代码包超限问题是否已经被成功解决:
- 部署时未再出现
CodeSizeLimitExceeded错误。 - 函数冷启动正常,没有出现依赖缺失、模块找不到或路径错误问题。
- 层或 OSS 挂载中的资源能够被正确读取,且没有超时、异常或权限报错。
- CI/CD 流程中已加入体积检测机制,并设置解压后目录大小不超过 450 MB 的校验阈值,未触发告警。
常见问题
代码包超限后部署失败怎么办
第一步,可使用 du -sh 和 ncdu 快速定位大目录和大文件,重点清理 .git、node_modules/.cache、__pycache__ 等常见冗余内容。第二步,使用 pip install --no-cache-dir -t 仅安装运行时真正需要的 .so 和 .py 文件,同时删除测试目录、文档文件以及 .dist-info。如果这样仍然超限,就应把重型依赖库,如 numpy、pandas 等拆分到自定义层中,通常可将核心代码包压缩到 20 MB 以内。为了提前预警,建议在 CI 中设置 80 MB 告警阈值。

层无法加载依赖如何解决
首先检查目录结构是否正确:Python 依赖必须位于层的 /python 目录下,而 Node.js 依赖则应放在 /nodejs/node_modules。制作层时建议使用 zip -r layer.zip python/,确保压缩包中的路径层级完全正确。其次还要关注架构一致性,例如 amd64 编译得到的 .so 文件不能直接用于 arm64 函数。制作层时应声明兼容架构,或者统一本地与线上运行环境。还要注意层本身是只读的,某些依赖若启动时需要写入配置文件,可能会静默失败,因此应提前在本地模拟环境中验证。最后,建议通过 pip freeze 固定版本,并在层的 requirements.txt 中显式排除主代码包已包含的依赖,以避免重复加载和体积浪费。
OSS挂载后文件同步延迟如何处理
需要明确的是,OSS 挂载并不是标准的 POSIX 文件系统,因此在写入后立刻读取时,可能会读到旧数据。实际场景中,小文件写入后即刻在同一实例内通过 open() 读取,偶尔会出现 300~800ms 的不可见窗口。如果业务对强一致性要求不高,可以直接使用 oss2 SDK 的 get_object 读取对象;如果必须保证“写完立即可读”,则更推荐改用 NAS 挂载,因为 NAS 提供文件锁以及 close-to-open 一致性。若仍坚持使用 OSS,可自行增加重试逻辑,例如写入后通过 head_object 轮询确认 ETag 已落盘,或者使用消息队列将读写过程解耦。
后续优化
- 在 CI/CD 流程中加入体积检测,设置解压后目录大小 450MB 告警阈值,并自动输出 TOP 20 大文件路径,便于持续排查。
- 定期清理历史版本,仅保留最近 3 个可回滚版本,以控制总占用空间和部署资源消耗。
- 结合业务迭代节奏持续评估依赖增长率:如果每月新增依赖体积增长超过 15%,建议尽早把重型库迁移到层管理中。
- 对于跨地域部署场景,可考虑将层在各 region 进行同步上传,或借助服务商提供的跨 region 资源评估与迁移支持能力。


