TextIn xParse与WorkBuddy实战:零门槛打造财报解析助手
时间:2026-08-15 14:01
当我把一份年报交给 WorkBuddy最近我在关注家电行业的年度报告。整理公开资料时,我想快速回答几个很具体的问题:哪家公司的收入增长更有质量?利润增长有没有现金流支撑?应收账款和存货的变化是否值得关注?不同业务板块到底是谁在贡献增长?于是,我打开了 WorkBuddy。我的第一反应很直接:把
## 当我把一份年报交给 WorkBuddy
最近我在关注家电行业的年度报告。整理公开资料时,我想快速回答几个很具体的问题:哪家公司的收入增长更有质量?利润增长有没有现金流支撑?应收账款和存货的变化是否值得关注?不同业务板块到底是谁在贡献增长?于是,我打开了 WorkBuddy。
我的第一反应很直接:把年报交给 WorkBuddy,让它帮我整理一份财务分析。这个思路看起来很顺——上传 PDF,提出问题,然后等待答案。
我先选了美的集团 2025 年年度报告。这份报告有 276 页,除了三大财务报表,还有分产品、分地区、分业务板块的数据和大量财务附注。它足够典型,也足够复杂,我想看看 AI 到底能不能处理一份真实年报。

一、第一次尝试:直接分析原始 PDF
我把原始年报上传到 WorkBuddy,输入了下面这段提示词:
请仅依据上传的 2025 年年度报告,分析公司的收入、净利润、毛利率、经营活动现金流、应收账款、存货和主要业务板块变化。先列出关键数据及同比变化,再解释变化原因,最后总结经营亮点、潜在风险和需要进一步核验的问题。所有数字注明原文页码、表名和单位;报告中没有明确依据的内容请标注“无法确认”。

【图 1:WorkBuddy 直接处理原始 PDF任务】

【图 2:WorkBuddy 直接处理原始 PDF 的过程与结果】
等待 22 分 47 秒后,我得到了第一版回答。它已经能够抓住提示词要求的主要指标,但我仍然需要频繁回到原 PDF,确认数字来自哪张表、对应哪个年度和单位,以及同比口径是否一致。回答并非不能用,只是对于一份需要认真核验的财报分析来说,这部分人工检查仍然很重。
## 二、问题不一定出在分析,而可能出在解析
继续检查后,我意识到,年报和普通文章并不是同一种文档。它有数百页内容,表格中还包含多级表头、合并单元格、跨页延续的项目、单位说明和脚注。
普通文本提取也许能够找到“营业收入”几个字,却未必能同时保留这个数字属于哪一列、对应哪个年度、采用什么单位,以及是否受到脚注条件限制。一旦这些关系在解析阶段被打散,后面的分析再流畅,也可能建立在不够完整的输入上。
这让我改变了思路。**我需要寻找的不是另一个更会写总结的模型,而是一个能先把财报结构整理清楚的解析工具。**
三、在 WorkBuddy 里找到 TextIn xParse
回到 WorkBuddy 的应用入口后,我注意到了 TextIn xParse。点开后可以看到,它不仅能处理 PDF,也面向 Word、Excel、PPT 等文档,甚至图片,解析结果还能继续导出为 Markdown 或 JSON。
这正好对应我刚才遇到的问题:WorkBuddy 继续承担提问、组织任务和生成分析的工作,而 TextIn xParse 先把年报中的文字、表格与版面关系整理成更适合后续使用的结构化内容。

【图 3:WorkBuddy 中 TextIn xParse 的入口】

【图 4:同一 PDF、同一提示词下启用 TextIn xParse】
我没有立刻换一套问题,而是决定建立一个尽量简单的对照:仍然使用同一份美的集团年报、同一个 WorkBuddy 任务和同一段提示词,只在第二次运行时启用 TextIn xParse 连接器。这样,后续观察到的差异不会来自文件和提问方式的变化。

【图 4B:接入TextIn xParse WorkBuddy 重新处理原始 财报PDF任务】
这次对照只改变了解析环节,后面还要分别检查结构和耗时,不能把“回答更快”直接等同于“内容更准确”。
## 四、TextIn xParse 处理的如何
解析过程中,TextIn xParse 生成了按原文顺序组织的 Markdown。我下载了其中包含关键财务表格的 `01_美的集团_2025年年度报告.md`。本次实际保存的解析正文格式是 Markdown,因此下文只依据这一真实产物展开。

这里的 Markdown 不是所有表格都转换成简单的 `|` 分隔文本;复杂表格会在 Markdown 正文中嵌入 HTML `
`,并用 `rowspan`、`colspan` 表示跨行和跨列。对年报这种有合并表头的文档来说,这是一种保留结构的结果,不是格式出错。后面的对照图会同时保留原表和解析后的结构化表格,避免只展示脱离行列关系的纯文字。
为了观察解析阶段到底保留了什么,我没有先看最终总结,而是直接打开原始 PDF 和这份 Markdown,选择两张结构较复杂、同时又与后续分析直接相关的表格进行核对。
第一张是年报第 49 页的“营业成本构成”。这张表同时包含“行业分类”和“项目”两个行维度,以及 2025 年、2024 年各自对应的金额和占比,最右侧还有同比增减。原材料、人工工资、折旧和能源又共同隶属于“家用电器行业”。在 xParse 生成的 Markdown 中,年份表头、金额与占比的从属关系被保留下来,合并单元格则通过 `rowspan` 和 `colspan` 表达。

【图 5:原始年报第 49 页“营业成本构成”与 xParse Markdown 对照】第二张是年报第 53 页的“资产构成重大变动情况”。它在同一行里同时放置期末金额、占总资产比例、期初金额、占比变化和重大变动说明。应收账款与存货也出现在这张表中,后续可以直接检查 WorkBuddy 是否把账面价值、占比和同比变化混为一谈。 【图 6:原始年报第 53 页“资产构成重大变动情况”与 xParse Markdown 对照】
这张对照图里,其实还留着两个很容易被忽视、但在核验时非常关键的定位线索:一是 PDF 阅读器显示,报告正文的印刷页码是 53;二是 Markdown 里也出现了 `` 这样的页码标记。与此同时,表格中的“2025 年末/2025 年初”两级表头、金额、占总资产比例以及变动说明,依然都准确落在各自对应的列里。对后续核验而言,这一点很重要——不仅能把数字对上,还能迅速确认这些数字究竟出自报告的哪一页、采用的是哪一种口径。
这两组对照说明,文档解析的价值不只是“把 PDF 变成文字”。金额本身被识别出来只是第一步,更重要的是年份、单位、占比和项目名称之间的关系仍然存在。只有这些关系先被保存下来,WorkBuddy 后续才有条件继续提取和比较。
五、同一任务下的处理时间对照
完成表格核验后,我再回看同一任务的运行记录。第一次直接分析原始 PDF 用时 22 分 47 秒,并且只给出了简单的文本结果,后续核验只能自己去原文中找;启用 TextIn xParse 后,本次运行用时 2 分 59 秒,且中间产出了完整的Markdown解析结果,之后才是财报分析结果。 【图 7:两次运行的处理时间对照】
| 对比项目 | 直接分析原始 PDF | 启用 TextIn xParse |
| --- | --- | --- || 本次处理耗时 | 22 分 47 秒 | 2 分 59 秒 |
| 对照条件 | 同一份年报、同一套提示词 | 同一份年报、同一套提示词,增加 xParse 连接器 |六、从一家公司扩展到一个行业
前面我们检查了一份年报的表格结构,记录了同一任务的处理时间。现在继续回答另一个问题:同一套字段和提示词,能不能同时处理多家公司,并把结果放进同一个可核验的比较框架?为此,我又准备了海尔智家和格力电器的 2025 年完整年报。### 先固定输入和比较口径三家公司报告年份一致,但规模、业务结构和披露习惯并不完全相同。我先把金额统一换算为亿元,再将比较字段分成三组:
增长:营业收入、归母净利润及扣非归母净利润同比增速;
质量:毛利率、归母净利率、经营活动现金流净额,以及经营现金流/归母净利润; 资产:应收账款、存货,以及应收账款和存货相对营业收入的变化。
我给 WorkBuddy 的横向比较提示词是:
请仅依据已上传的美的集团、海尔智家和格力电器 2025 年年度报告,建立一张可核验的横向比较表。金额统一为亿元;每个指标同时列出 2025 年数值、2024 年数值、同比变化、单位、公司、报告印刷页码和表名。请把报告直接披露的同比与根据两个年度数值计算的同比分开标注。分别回答:哪家公司的利润增长更快、哪家的经营现金流相对利润更充足、哪家的应收账款或存货变化最值得关注。无法从原文确认的原因请明确标注,不要补写原文没有的解释。
### 第一层:同一任务如何复用
三份年报都通过相同的 TextIn xParse 连接器处理,并使用同一套字段和单位要求。这里的重点不是结果有多长,而是让我看清楚输入范围没有被悄悄改变。 【图 8:三份年报与 TextIn xParse 的统一处理任务】
### 第二层:把结果做成可检查的横向表
这次实际生成了 Excel 文件《白色家电三巨头 2025 年报横向比较表》。它具备所需的骨架:标题、统一单位、按主题分组的指标、同比列,以及表格下方的来源和页码说明。相较于只展示一段自然语言结论,表格更适合检查“同一行是不是同一口径”。 【图 9A:三份年报横向分析完成并生成 Excel】
这次三份年报横向任务的界面记录显示耗时 9 分 49 秒。这个时间可以作为多文件实操的过程记录,但不和前面单份美的年报的 2 分 59 秒直接计算倍数:文件数量、总页数和输出任务都已经发生变化,二者并不是严格的同一组对照实验。
为了让表格内容更容易阅读,我又单独打开生成的 Excel。它把三家公司的核心利润、现金流、盈利能力和资产质量放在一张表里,并在下方保留来源和计算口径说明。

【图 9B:三家公司 2025 年报横向比较表】### 第三层:从复杂表格扩展到图片和跨页内容前面美的集团案例已经展示了多级表头和合并单元格,因此这里不再重复放置同一张“资产构成重大变动情况”。我把抽查范围扩展到海尔和格力,并刻意选择三种不同难点:数值与比率混排、图文混排,以及跨页长表格。这样更能看出 xParse 面对不同年报版式时究竟保留了哪些内容。
第一张来自海尔智家报告印刷第 113 页的“截至报告期末公司近 2 年的会计数据和财务指标”。这张表既有净利润这样的绝对金额,也有流动比率、资产负债率和利息保障倍数等不同类型指标,最右侧还包含同比增减。解析后的 Markdown 保留了 2025 年、2024 年和同比三列之间的对应关系,百分比、倍数和金额没有因为版式转换而串行。
 【图 10:海尔智家近两年财务指标原文与 Markdown 对照】
第二张来自格力电器报告中的产品介绍页。它让我看到,xParse 处理的并不只有文字和表格:原 PDF 中的产品图片在输出文件里被保存为 Markdown 图片引用,当前打开 Markdown 时仍可继续渲染显示;图片前后的产品说明、章节标题和出现顺序也被保留下来。对于包含产品图、流程图或示意图的企业报告,这比只提取一段 OCR 文本更完整。
【图 11:格力电器图文混排页面在 Markdown 中的保留效果】
第三张是这一组里最能体现结构处理能力的例子。格力“证券投资情况”原表横跨报告第 32、33 页,包含证券品种、代码、计量模式、公允价值变动、本期买卖金额、报告期损益和期末账面价值等十余列。原 PDF 受分页限制被拆成上下两段,而 xParse 输出把两页内容衔接为一张连续表格,表头只出现一次后半页记录和最后的“合计”行仍然落在原来的列关系中。
【图 12:格力电器跨页证券投资表在 Markdown 中合并为连续表格】
从这三组新增对照,再回看前面的美的复杂表格,可以把解析效果归纳为四点:多级表头没有被打散,金额与比率仍在正确列中,原文图片可以继续显示,跨页表格也能恢复为连续结构。它们分别对应年报处理中最常见的几类难点,比继续增加相似的普通表格更有展示价值。
### 这一轮比较说明了什么
从一家公司财报分析扩展到三家公司财报综合后,**TextIn xParse 的作用不再只是把 PDF 变成文字,而是把不同版式、不同单位的表格、图片及跨页内容整理成可继续使用的结构,WorkBuddy 再按统一字段生成比较表。人的工作从逐页搬运数字,转向统一口径、抽查结果和解释差异。**## 结语:真正重要的是让结构先被保留下来这次体验让我重新理解了财报分析中的“自动化”。真正的效率不是把一份 PDF 更快地变成一段文字,而是让文档中的表格结构、图片、跨页关系和上下文在后续分析中继续有效。
WorkBuddy 提供的是一个可用于提问、梳理任务和产出结果的平台;而 TextIn xParse 补上的,其实是更底层、也最容易被忽视的一环:**把复杂的企业文档解析成后续还能直接利用的结构化资料。**像多级表头不会被打乱、原文图片在 Markdown 里还能正常呈现、被 PDF 分页截断的长表也能重新接起来,这些看似是细枝末节,实际上恰恰决定了后续分析能不能建立在完整、可靠的输入之上。
当我把同一份年报用同一套提示词做前后对照,再把流程扩展到海尔智家和格力电器时,**xParse 的价值就不再只是一个入口或一个转换按钮,而是成为财报分析链路中负责“把文档读准确”的基础能力。**
当然,财报分析仍然需要人工判断,尤其是会计口径、一次性损益、关联交易和风险事项。我的结论不是让 AI 代替财务人员,而是先把整理、提取和交叉比较这些高重复工作交给工具,把时间留给真正需要判断的地方。
如果你也在处理财报、研报或其他复杂文档,可以直接进入 WorkBuddy,在连接器入口找到并启用 TextIn xParse
再上传文档开始解析

说实话 ,我还是第一次体验如此高精度的解析能力,如果你也对此感兴趣,不妨在WorkBuddy中打开 TextIn xParse连接器体验一下,相信你也会像我一样眼前一亮的注:本文数据来自上市公司公开披露的 2025 年年度报告,相关分析仅用于展示文档解析与信息整理过程,不构成任何投资建议。","createTime":1786581895,"ext":{"closeTextLink":0,"comment_ban":0,"description":"","focusRead":0},"fa vNum":1,"html":"","isOriginal":0,"likeNum":1,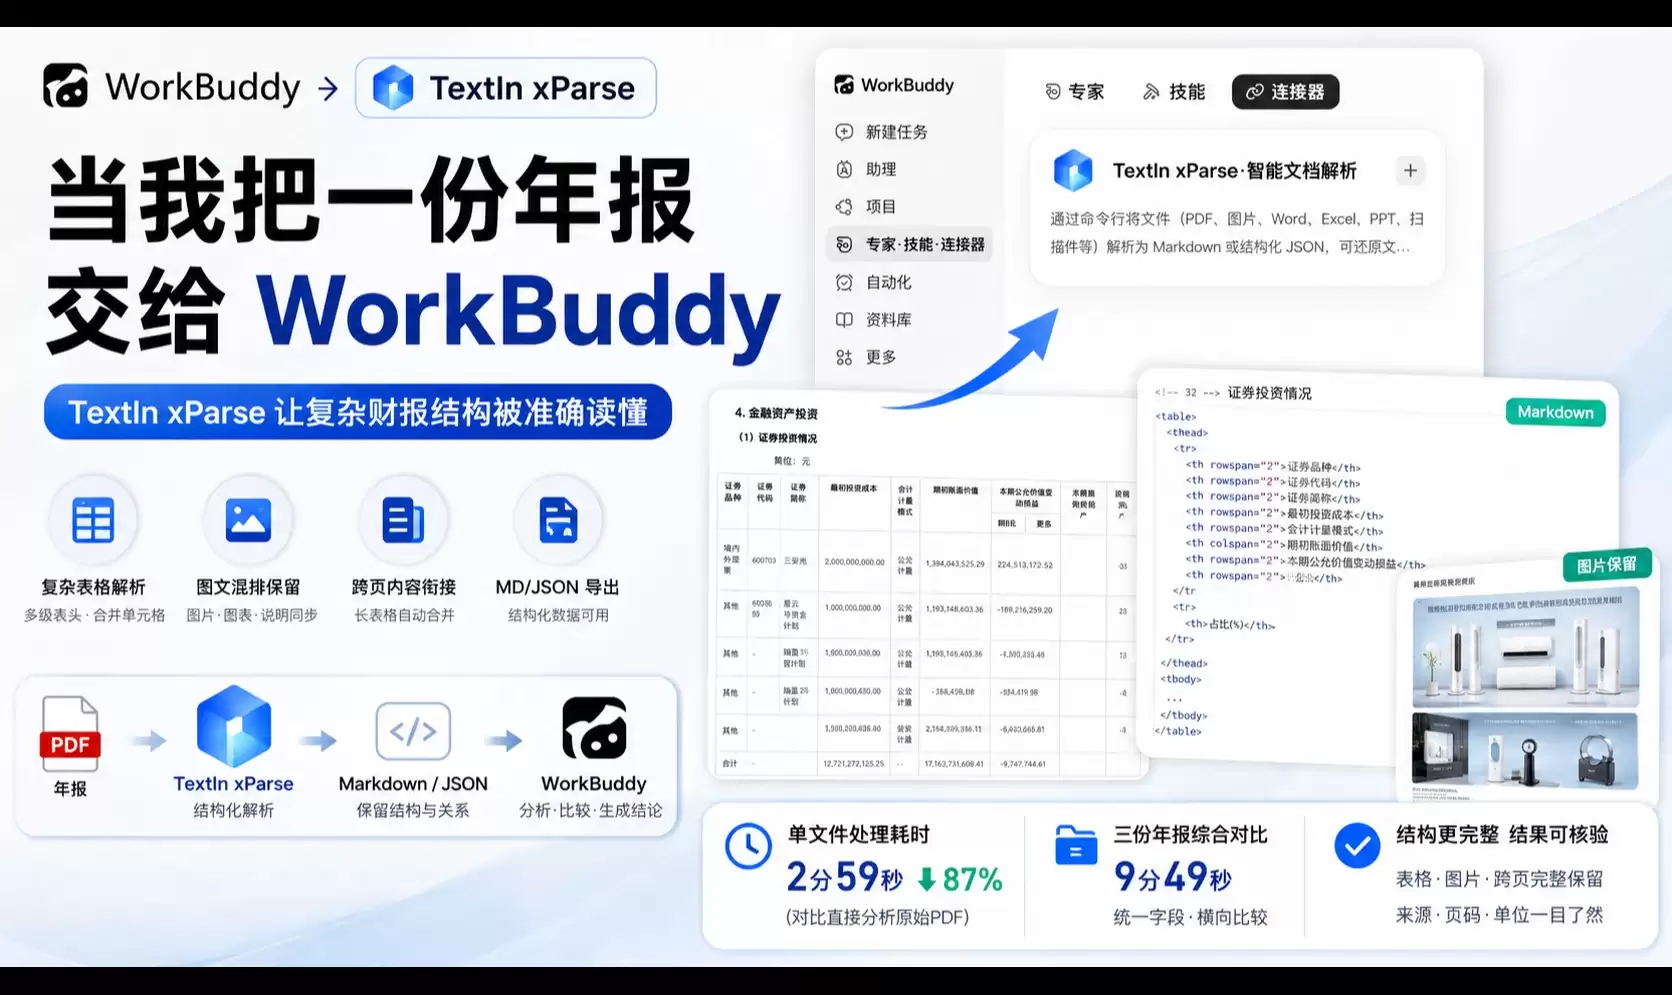
来源:https://cloud.tencent.com.cn/developer/article/2725248
Buddy
本站内容用于信息整理与展示,如有侵权或内容问题请及时联系处理。
相关推荐
补充同频道和同主题内容,方便继续浏览更多相关内容。



