
目录
1. 什么叫模型
2. 什么是大语言模型
2.1 神经网络
2.2 自监督学习
2.3 半监督学习
2.4 语言模型
3. 大语言模型的能力
1. 什么叫模型
简单来说,模型就是专门用于处理某一类任务的系统,你也可以把它理解为一个单独的工作流。当多个模型能力被整合并协同运作时,就逐步形成了更复杂的大语言模型能力体系。

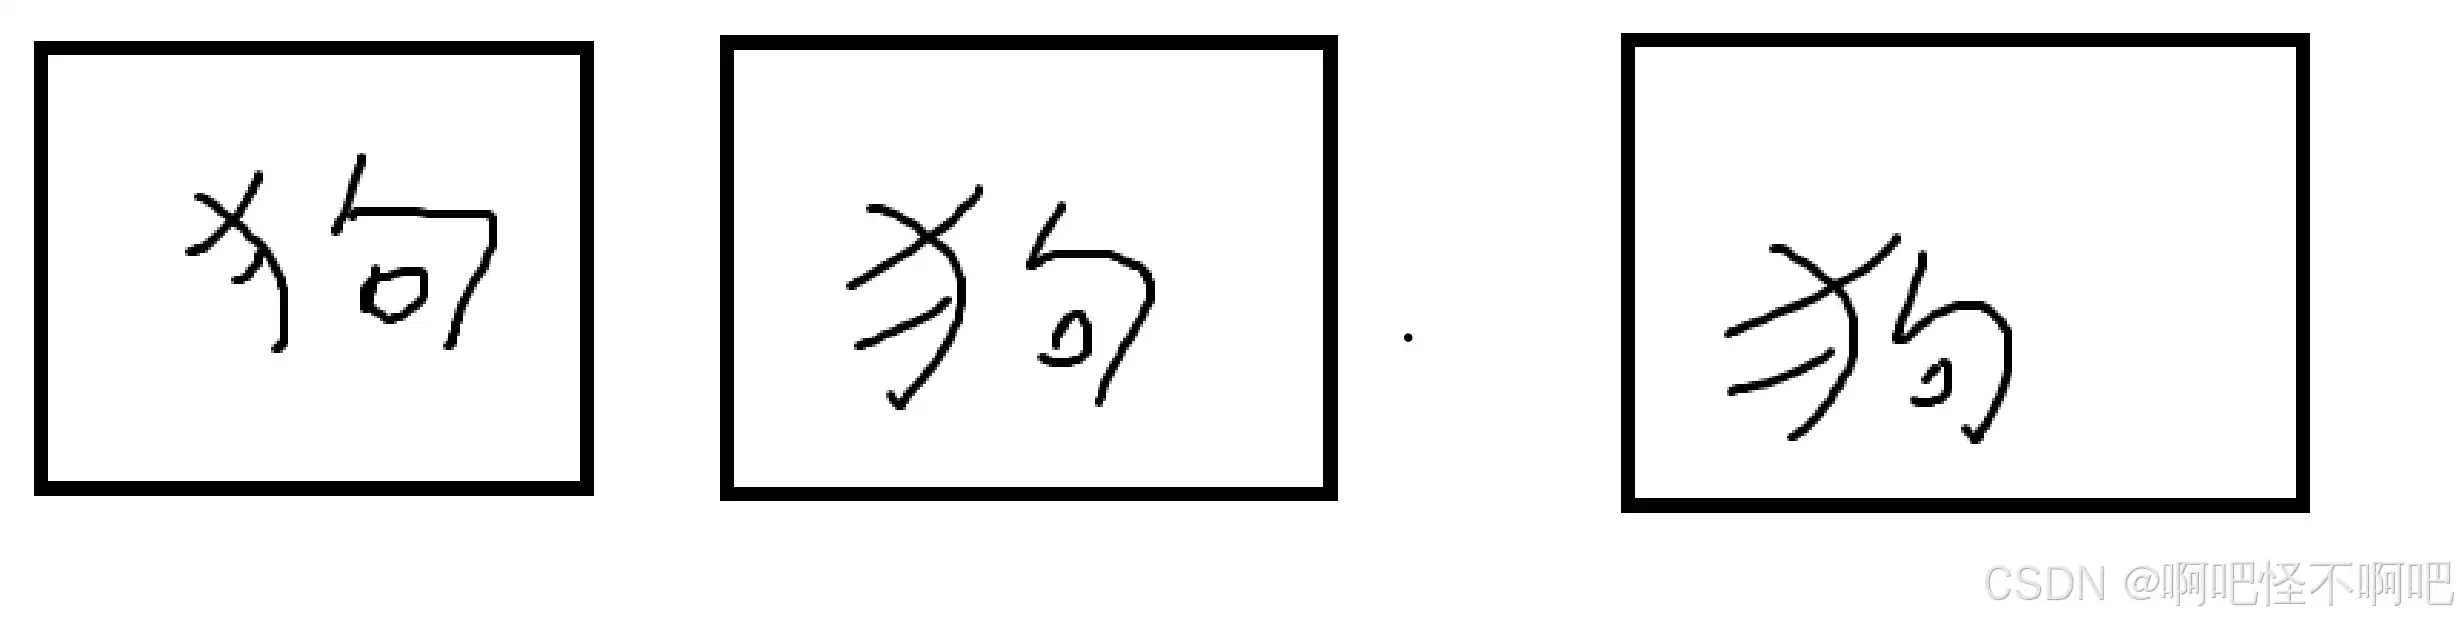
它和普通工作流的核心区别在于需要提前完成模型训练。以下图为例,我们需要先将大量狗狗图片输入模型,并为每一张图片标注“狗”这个标签。通过让 AI 持续学习这些已标注数据,模型就能逐渐掌握识别狗的能力。
不过,这类模型通常只擅长已经训练过的任务。比如它只学过“什么是狗”,如果你再问它“什么是猫”,那么这个模型往往就无法准确回答,因为它并没有接受过对应的训练数据。
2. 什么是大语言模型
2.1 神经网络
神经网络可以理解为由大量计算单元组合而成的智能处理结构,也可以类比为许多个彼此连接的小型工作流。每一部分只负责处理问题中的一小块信息,最终通过相互配合,实现对用户输入内容的识别、分析与处理。
2.2 自监督学习
自监督学习是一种无监督学习的进阶方式,核心在于让模型自己从原始数据中构造监督信号(标签),不依赖大量人工标注,也能完成特征提取、规律学习和模型训练。
如果用更通俗的话来理解,它有点像“自学”,模型一边学习数据,一边不断校正自己的理解方向,因此在大语言模型训练中非常关键。
2.3 半监督学习
半监督学习就是“少量人工指导+大量自主学习”的结合模式。
例如先给部分照片添加标签和备注,再提供更多未完整标注的数据让模型继续识别和归纳,这种结合少量标注样本与大量未标注样本的训练过程,就叫做半监督学习。
2.4 语言模型
语言模型的基础机制是自回归预测,也就是根据当前已有的上下文内容,推断下一个词最有可能是什么。通过不断重复这一过程,模型可以逐步生成语义通顺、逻辑连贯的长文本内容。。
比如我们平时打字时看到的自动补全、输入法联想,实际上就是语言模型在实际场景中的典型应用。
3. 大语言模型的能力
大语言模型和传统语言模型并不能完全画等号。简单来说,所有大语言模型都属于语言模型,但并不是所有语言模型都能称为大语言模型,这两者在规模、能力和应用范围上都有明显差异。

核心定义与关键特征
核心定位:以“预测下一个词”为基础任务,通过海量文本数据学习语言规律、知识结构与逻辑关系,从而涌现出对话、内容生成、推理分析、文本创作等通用 AI 能力,而不是只服务于某一个单一任务。
三大关键特征
架构:通常采用 Transformer 架构(多为纯 Decoder),借助自注意力机制高效捕捉长距离语义依赖关系,并且在并行计算效率上明显优于 RNN/LSTM。
规模:参数量通常达到数十亿到万亿级别(如 GPT-3 为 1750 亿参数、GPT-4 达到万亿级量级表述),训练数据则来自 TB 级通用语料,包括书籍、网页、代码等多种内容来源。
能力:支持零样本 / 少样本学习,具备较强的跨任务泛化能力,同时拥有上下文理解、复杂推理以及多模态(文本 + 图像 / 音频)处理能力。
主要挑战与局限
幻觉:模型可能生成看起来合理、但实际上并不符合事实的信息,因此通常需要结合外部知识库或检索增强生成(RAG)来降低错误率。
算力与成本:无论是大模型训练还是推理部署,都高度依赖大规模 GPU 集群,整体成本高,能耗也较大。
安全与伦理:大语言模型还可能带来偏见输出、隐私泄露、内容滥用等风险,因此需要持续进行模型对齐、安全治理和合规管控。
上下文窗口限制:虽然上下文长度在持续扩大(如 GPT-4 128k、Gemini 1.5 Pro 10M),但面对超长文本理解、长链路记忆和复杂信息整合时,仍然存在一定瓶颈。


