
Sam Altman那个著名的梗,这次应验在所有人身上了
去年宣传GPT-5时,OpenAI CEO Sam Altman那句“感觉就像看到原子弹爆炸,整个人眩晕瘫坐”的形容,后来成了科技圈的一个经典梗。每逢有AI新品发布配上夸张文案,这句话总会被拉出来调侃一番。
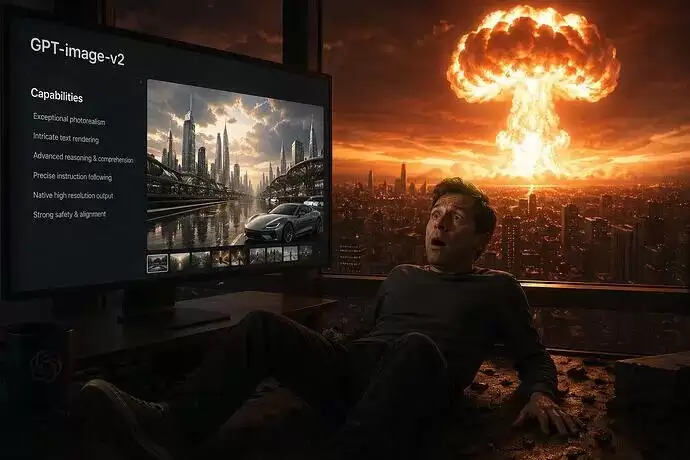
但这一次,深夜盯着屏幕等待OpenAI出招而“眩晕瘫坐”的,恐怕是全世界所有用户。奥特曼照例在社交媒体上卖了个关子,只发了一句:“我们准备了一些有趣的东西。”
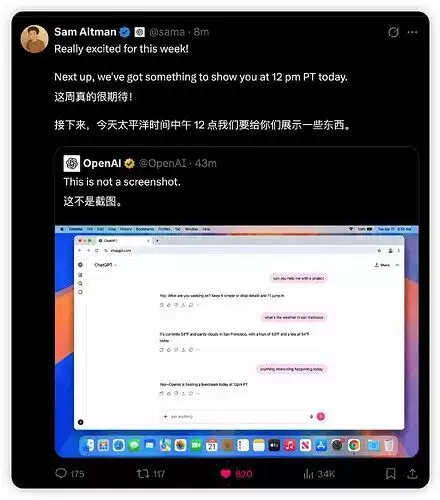
凌晨三点,答案揭晓:GPT-Image 2正式发布。全球AI社区瞬间被点燃。
发布页的第一句话就定下了基调:“Images are a language, not decoration.” 翻译过来,核心意思很明确:图像从此不再是装饰品,它本身就是一种语言。这无异于对整个计算机视觉行业发出了一份代际跃迁的宣言。
过去一整年,AI绘图似乎还困在“画得像不像”的审美竞赛里。GPT-Image 2的出现,直接按下了切换键——AI生图正式进入了“逻辑对不对”的智力考场。
这款模型的精度,用“恐怖”来形容并不过分。在Artificial Analysis的文生图和图像编辑排行榜上,它实现了双榜登顶,实战表现更是碾压级的。那种感觉,就像视频生成领域迎来Sora时一样:它早已超越了辅助工具的范畴,开始定义新的行业标准。
注:本文的图片全部由GPT-Image 2生成,图片内容纯属虚构。
思维引擎的觉醒
过去评判一个图像模型好坏,首要标准往往是“像不像真人”或“像不像参照物”。但在GPT-Image 2这个“怪物”面前,这套标准彻底过时了。
新模型最核心的突破点在于:它是一个支持思考模式的图像模型。这意味着什么?用户输入提示词后,模型不再简单地执行去噪、拼接像素的操作。它会在后台先完成一次思维建模,然后再动笔“作画”。
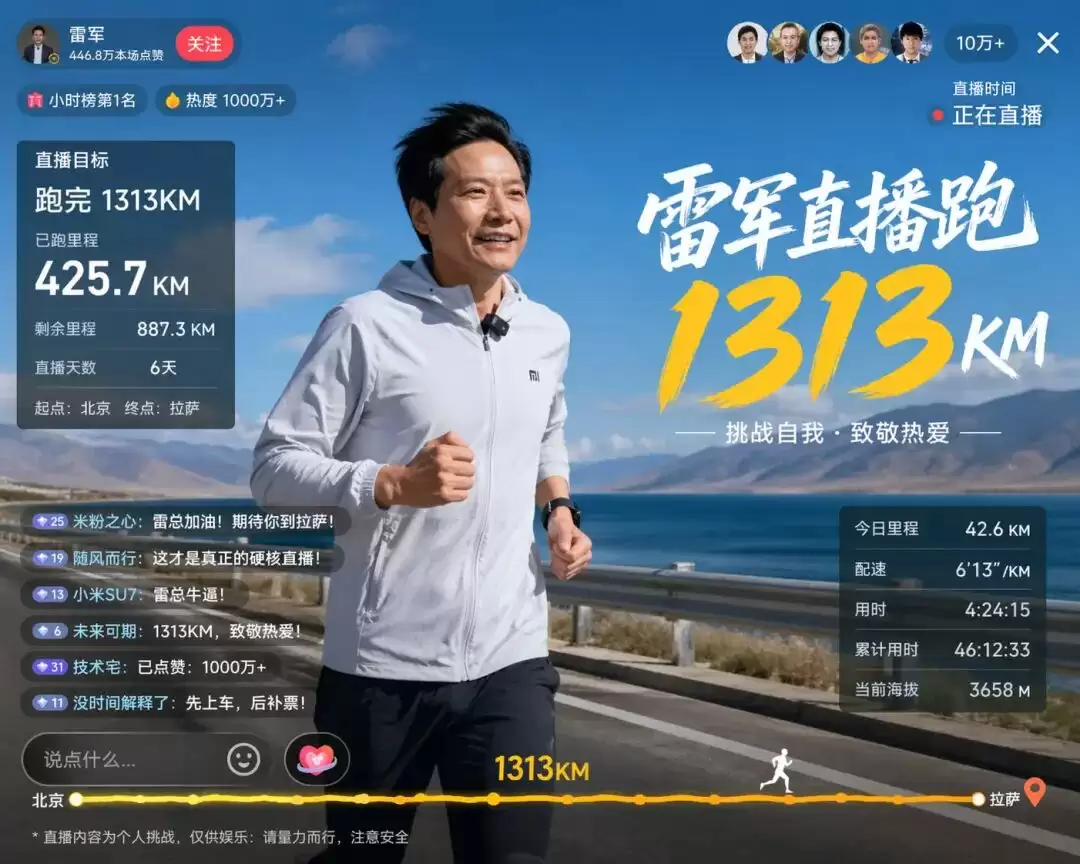
Linux.do社区流出的一张实测图最能说明问题。模型生成了雷军直播跑步的画面:
图源:https://cdn3.linux.do/original/4X/0/f/3/0f37c8bc968e3d563cc6100d8e7f80ee305661ff.jpeg
这张图让不少开发者倒吸一口凉气。雷军的面部特征被精准还原,画面中清晰地显示着:直播目标1313km、已跑里程425.7km、剩余里程887.3km。更绝的是,当前海拔标着3658m。
3658米是什么概念?从北京前往拉萨,进入藏区的典型海拔,恰好就是这个数字。在人类看来,这不过是简单的数学+减法和基础地理常识。但请想一想:对于一个图像模型而言,实现数学逻辑、地理常识与UI规范的三重统一,意味着什么?
结论很直接:在生成第一个像素之前,GPT-Image 2已经完成了一轮推理。它理解了“里程”的含义,掌握了加减法的逻辑关系,也知晓了高海拔地区的视觉特征。这哪里是在画画,这分明是在思考。
从玩具到生产力
面对这种能力,所有人对图像模型的定位,是时候更新了。它早已不再是画头像、做壁纸的玩具,而是一脚迈过“可用”门槛,直接冲进了“好用”区间——一个能扔进商业场景直接创造价值的工具。
以海报设计为例。GPT-Image 2在构图审美、光影处理、品牌调性拿捏上的表现,无疑达到了绝大多数普通人类设计师难以企及的高度。

图源:https://cdn3.linux.do/original/4X/7/a/1/7a12ccd6b745be5ad8828eb0ac225d218fb43cbc.jpeg
在现实商业社会中,聘请一位高级美工设计一张商业级海报,其沟通成本、时间成本和动辄上千元的设计费用,对中小企业而言往往是不小的负担。然而,使用GPT-Image 2,即便效果不满意调整几十次,成本也不过是几美元级别。
在海报设计、营销素材、插画配图这些领域,用户在乎的根本不是“真不真”,而是“好不好看、准不准”。正因如此,AI在此展现的替代效率是碘伏性的。
同步更新的开发者文档中,还隐藏着一个令人兴奋的细节:示例代码里频繁出现了model:“gpt-5.4”的字段。思考模式加上旗舰大语言模型的组合,强烈暗示了一件事:GPT-Image 2绝非孤立产品,它是为下一代大语言模型而生的视觉终端。
通过新的Responses API,生图过程会像和大语言模型聊天一样自然交互。模型新增了多轮对话修改功能,第一版生成后,用户可以提出各种让乙方设计师血压飙升的指令:“背景再暗一点。”“Logo往旁边挪几个像素。”这些交互式、实时性的修改需求,恰恰是设计师日常工作中最繁琐、最消耗耐心的部分。如今,迎刃而解。
中文渲染的巅峰
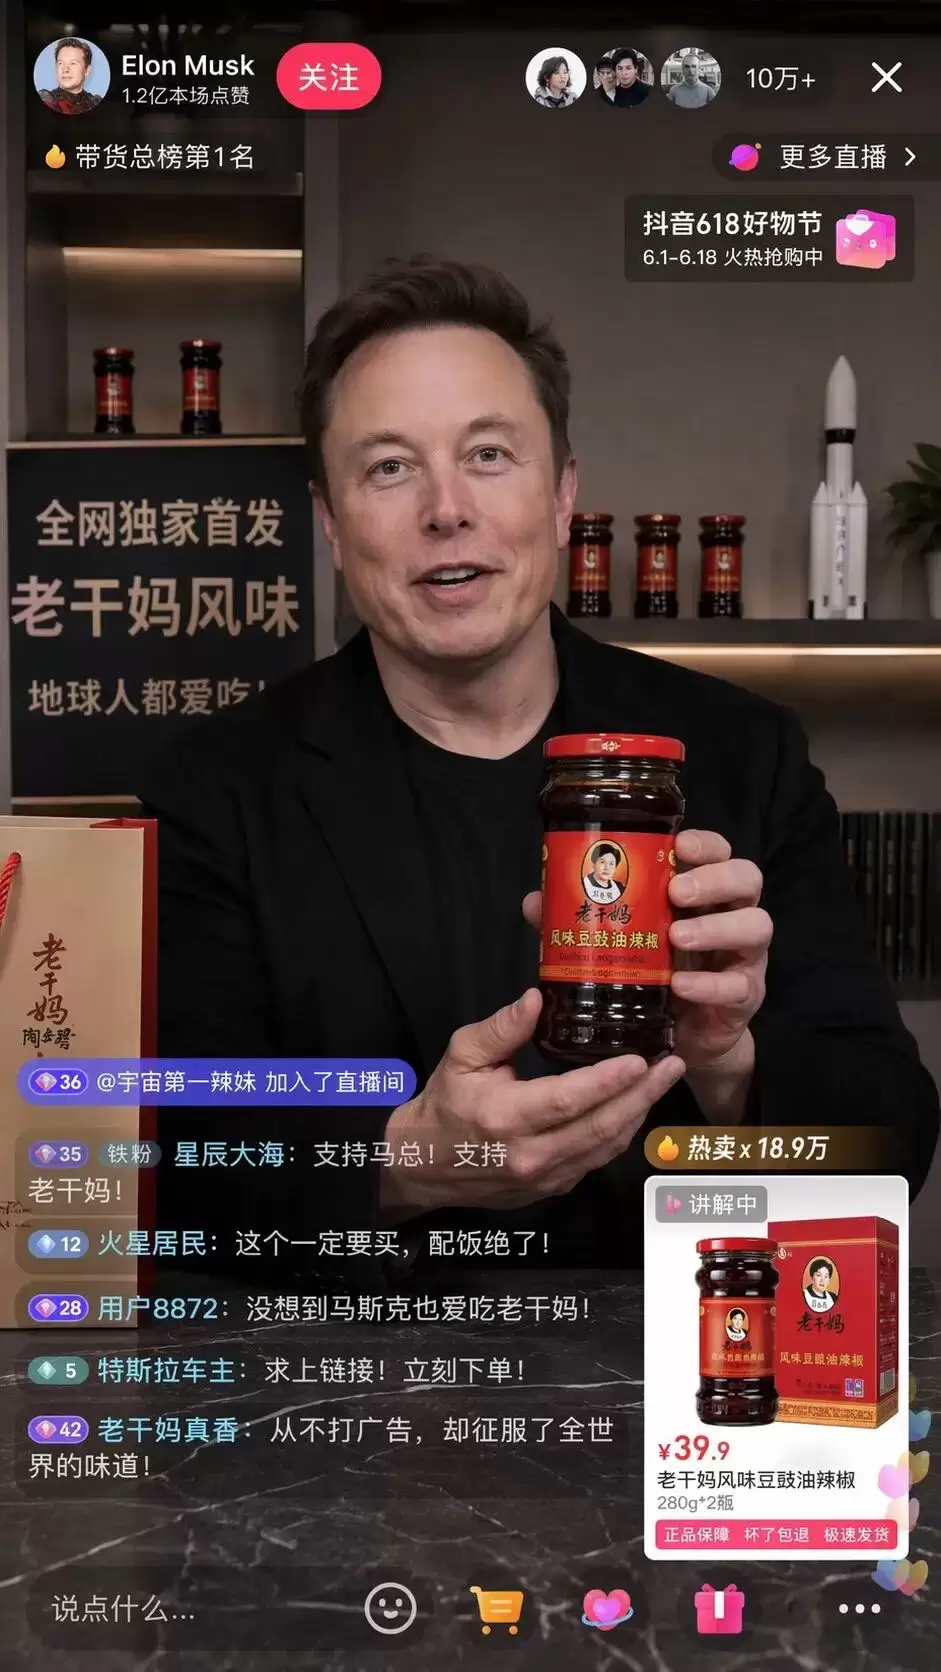
GPT-Image 2虽是海外模型,却在国内用户中收获了一边倒的叫好。原因只有一个:它对汉字的支持,堪称完美。
在社区的实测返图中,你能看到罗永浩与王自如那场名场面的辩论:

图源:https://cdn3.linux.do/original/4X/0/9/7/097ed46991d2464442aebc6b1076a292cc839fec.jpeg
能看到马斯克直播带货老干妈:
图源:https://cdn3.linux.do/original/4X/2/f/a/2fa77cf040e6337643829df4ec5ca6467d2866b2.jpeg
甚至能看到笔迹清晰的医生药方:

图源:https://cdn3.linux.do/original/4X/9/f/f/9ffeab83675648b43116cd0763f6c8b560611ae6.jpeg
这些图片中的文字,早已告别了歪七扭八、胡乱拼凑的“伪汉字”阶段,呈现出具备书法韵味、字体层次感和排版艺术的成熟设计感。显然,OpenAI在训练集中灌入了海量中文语料图像,并进行了针对性的强化训练。
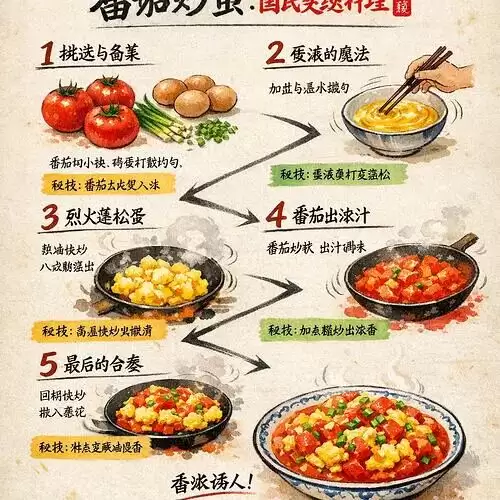
与前代模型对比,GPT-Image 2的强大得以更加淋漓尽致地体现。在对比测试中,前代1.5版本虽然能画出像菜谱的东西,但仔细一看,文字几乎全是乱码。
图源:https://cdn3.linux.do/optimized/4X/2/b/3/2b38f3c1a134515d564f07f81661c0bd9578c6b9_2_750x750.jpeg
而GPT-Image 2生成的相同菜谱,在文字清晰度和整体审美上,则实现了里程碑式的突破。

图源:https://cdn3.linux.do/original/4X/0/2/5/02513b10135d824ccb1c22bd0c7eb441f1e34455.jpeg
对于包含上百个中文字符的复杂提示词,“五个步骤”仍然清晰可见,图文一致性令人满意。这不再只是一张图,更是一套可复现的实操方案。
不过,这也引出一个有趣的技术问题:图像模型真的彻底解决了文字乱码问题吗?行业共识是:恐怕没有。
大语言模型生成token,依赖的是深层的语义逻辑。在强化学习阶段,它以概率为依据,高质量语料越多,逻辑就越合理。但图像模型的本质,终究是像素生成。像素之间的空间关系,与文字之间的语义逻辑,根本不是一回事。
换句话说,强大如GPT-Image 2,也并未真正“理解”文字的构成规律。它更像是通过海量数据,死记硬背了文字在像素层面上的“长相”。一张与奥特曼谈生意的图片暴露了这一点:两箱饮料包装上大大的“蒙牛”和“王老吉”写得极其完美,但底下的小字却依然是模糊的色块。

图源:https://cdn3.linux.do/original/4X/d/7/c/d7c4fb063202bcbf56b9ca0623aa0ce6fc26e542.jpeg
在现有技术范式下,其生成逻辑依然是“按像素排布”,距离真正的“按字符渲染”还差着本质的一步。极细微处的乱码,可能永远无法被彻底根除。但话说回来,对于90%以上的商业应用场景而言,目前的精度已经绰绰有余。
尚未封神的缺陷与边界
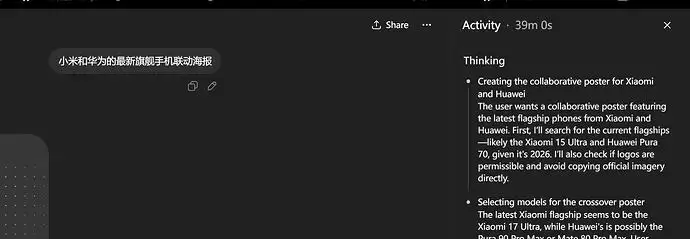
即便已经坐上世界第一的宝座,GPT-Image 2也有其笨拙的一面。实测中发现,由于思考模式会调用联网搜索并进行逻辑推演,在处理极其复杂或虚构的任务时,模型偶尔会陷入逻辑怪圈——思考接近40分钟,仍然无法给出答案。
与此同时,API宣称的支持2K甚至4K分辨率,意味着极高的token消耗和生成延迟。对于普通用户而言,未来如何在极致画质与响应速度之间取得平衡,是一门必修课。
在技术领域,强大的能力永远是一把双刃剑。无论是图像模型还是视频模型,都不可避免地要面对深度伪造带来的伦理挑战。目前的大部分实测案例中,AI生成的都是知名人物,但若将对象换成社交媒体上发布过照片的普通人,在不认识本人的情况下,已经极难分辨真假。除了背景中偶尔出现的乱码可能让AI露馅,人体本身几乎已无破绽。因此,那些曾经必须由真人出镜或参与的领域,正面临着前所未有的信任危机。
GPT-Image 2的发布,标志着生图模型正式从玩具走向了生产力工具。过去,人们用AI寻找灵感;如今,AI开始尝试接管从构思、计算、排版到成品的全流程。对于设计从业者来说,这是一个充满FOMO(错失恐惧)的时代。但对于那些善于利用工具、具备产品审美和逻辑思维的人来说,这又是一个最好的时代。
图像开始学会思考,文字不再是像素的杂音。人们距离那个“所思即所得”的视觉奇点,可能真的只有一步之遥了。


