
AI驱动的智能合约漏洞检测:从静态模式匹配到图神经网络的深度审计
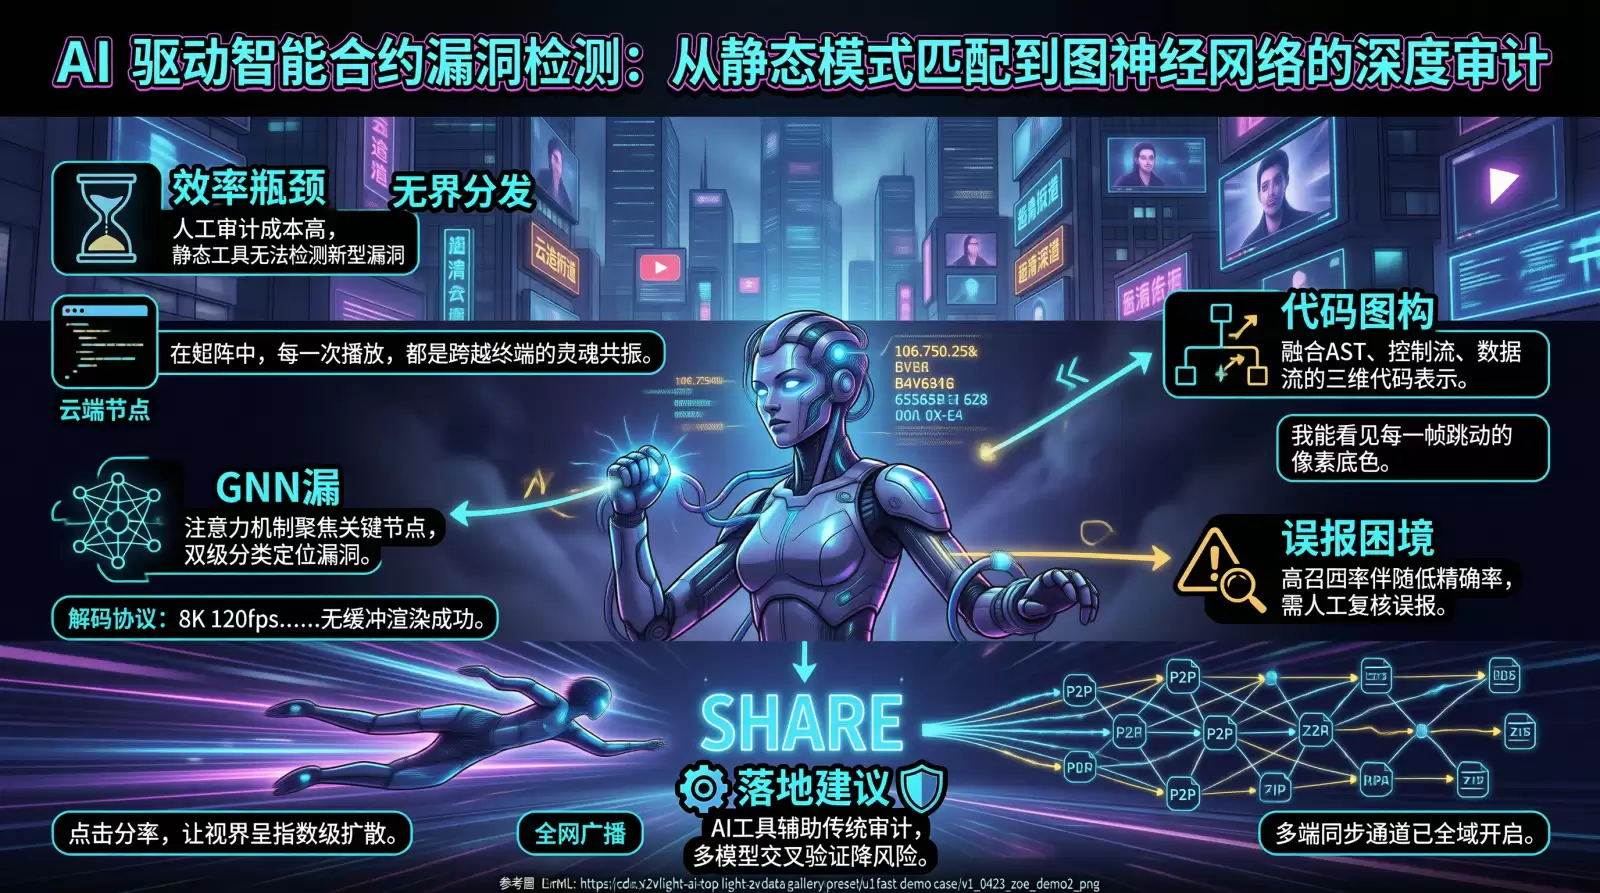
当前智能合约安全审计面临一个现实困境:主要依赖人工代码审查和规则驱动的静态分析工具(如Slither、Mythril)。人工审计虽然精度高,但效率较低。一份中等复杂度的DeFi合约审计周期通常需要2-5个工作日,费用在2-10万美元之间。静态分析工具速度快,但能力有限——仅能检测已知漏洞模式,面对新型攻击手法几乎无能为力。
2024年发生的多起零日漏洞攻击事件(如Curve重入漏洞变种、Vyper编译器缺陷)充分暴露了规则驱动检测的根本局限:规则永远滞后于攻击。AI驱动的漏洞检测,核心思路是从“匹配已知模式”转向“理解代码语义”,通过学习大量合约代码中的正常与异常模式,识别规则库中尚未定义的新型漏洞。然而,AI检测的误报率、可解释性和对抗鲁棒性,仍是工程落地的核心挑战。
二、AI漏洞检测技术架构:从代码表示到模型推理的多层管线
AI漏洞检测面临的首要挑战,是如何将Solidity源代码转化为模型可处理的数值表示。代码不同于自然语言,具有严格的语法结构和控制流语义。
flowchart TBA[Solidity 源代码] --> B[AST 解析
语法树提取]B --> C[代码图构建
控制流 + 数据流]C --> D[节点特征编码
操作符/类型/变量]D --> E[图神经网络
消息传递与聚合]E --> F[漏洞分类头
多标签分类]F --> G[漏洞报告
类型/位置/置信度]A --> H[字节码提取
编译后 EVM Opcode]H --> I[操作码序列编码
Embedding 层]I --> J[Transformer 编码器
序列语义建模]J --> Fstyle A fill:#1a1a2e,stroke:#e94560,color:#fffstyle E fill:#0f3460,stroke:#00d2ff,color:#fffstyle G fill:#16213e,stroke:#e94560,color:#fff
目前主要有两个技术路径:
源代码路径:Solidity代码先解析为抽象语法树(AST),再构建代码属性图(CPG),融合控制流图(CFG)和数据流图(DFG)。图神经网络(GNN)在代码图上进行消息传递,聚合邻居节点特征,最终输出每个节点的漏洞概率。
字节码路径:编译后的EVM字节码作为补充输入。某些漏洞(如编译器缺陷)在源代码层面不可见,只能通过字节码分析发现。操作码序列通过Transformer编码器建模,捕获长距离语义依赖。
双路径融合:源代码路径擅长检测逻辑漏洞(重入、权限缺失),字节码路径擅长检测编译器缺陷和底层操作异常。两条路径的特征在分类层前拼接,实现互补检测。
三、生产级代码实现:AI智能合约漏洞检测管线
3.1 代码图构建与特征编码
# code_graph_builder.py
# 从 Solidity AST 构建代码属性图(CPG)

import networkx as nx
from dataclasses import dataclass, field
from typing import Optional

@dataclass
class NodeFeatures:
    """代码图节点特征"""
    node_type: str          # 节点类型:FunctionDef, IfStmt, Assignment, etc.
    op: str                 # 操作符:call, send, +, -, etc.
    data_type: str          # 数据类型:uint256, address, mapping, etc.
    is_external: bool       # 是否涉及外部调用
    is_state_write: bool    # 是否写入状态变量
    is_condition: bool      # 是否为条件判断
    variable_name: str = "" # 变量名(用于数据流追踪)

# 节点类型到数值的映射(模型输入需要数值特征)
NODE_TYPE_MAP = {
    "FunctionDef": 1, "IfStmt": 2, "ForStmt": 3,
    "Assignment": 4, "Return": 5, "EmitStmt": 6,
    "FunctionCall": 7, "MemberAccess": 8, "IndexAccess": 9,
    "VariableDecl": 10, "StateVariableDecl": 11,
}
OP_MAP = {
    "call": 1, "send": 2, "transfer": 3, "delegatecall": 4,
    "staticcall": 5, "+": 6, "-": 7, "*": 8, "/": 9,
    "=": 10, "+=": 11, "-=": 12, "==": 13, "!=": 14,
}

class CodeGraphBuilder:
    """从 Solidity AST 构建代码属性图"""
    def __init__(self):
        self.graph = nx.DiGraph()
        self._node_counter = 0

    def build_from_ast(self, ast_root: dict) -> nx.DiGraph:
        """从 AST 根节点构建完整的代码属性图"""
        self._process_node(ast_root, parent_id=None)
        return self.graph

    def _process_node(self, node: dict, parent_id: Optional[int]) -> int:
        """递归处理 AST 节点,构建图结构"""
        current_id = self._node_counter
        self._node_counter += 1

        # 提取节点特征
        features = self._extract_features(node)
        # 编码为数值向量(供 GNN 使用)
        feature_vector = self._encode_features(features)

        self.graph.add_node(current_id,
                            features=features,
                            feature_vector=feature_vector,
                            raw_text=node.get("name", ""),
                            )

        # 添加 AST 边(父子关系)
        if parent_id is not None:
            self.graph.add_edge(parent_id, current_id, edge_type="ast")

        # 添加控制流边
        if node.get("type") == "IfStatement":
            self._add_control_flow_edges(current_id, node)

        # 添加数据流边
        if features.is_state_write:
            self._add_data_flow_edges(current_id, features)

        # 递归处理子节点
        for child in node.get("children", []):
            child_id = self._process_node(child, current_id)

        # 外部调用节点标记:潜在重入风险点
        if features.is_external:
            self.graph.add_edge(current_id, child_id, edge_type="external_call")

        return current_id

    def _extract_features(self, node: dict) -> NodeFeatures:
        """从 AST 节点提取特征"""
        node_type = node.get("type", "Unknown")
        name = node.get("name", "")

        # 判断是否为外部调用
        is_external = name in ("call", "send", "transfer", "delegatecall")
        # 判断是否写入状态变量
        is_state_write = (node_type == "Assignment"
                          and node.get("left", {}).get("type") == "StateVariableAccess")

        return NodeFeatures(
            node_type=node_type,
            op=name,
            data_type=node.get("type_name", ""),
            is_external=is_external,
            is_state_write=is_state_write,
            is_condition=node_type in ("IfStatement", "RequireStatement"),
            variable_name=name,
        )

    def _encode_features(self, features: NodeFeatures) -> list[float]:
        """将离散特征编码为数值向量"""
        return [
            float(NODE_TYPE_MAP.get(features.node_type, 0)),
            float(OP_MAP.get(features.op, 0)),
            float(hash(features.data_type) % 100),  # 哈希编码类型
            float(features.is_external),
            float(features.is_state_write),
            float(features.is_condition),
        ]

    def _add_control_flow_edges(self, node_id: int, node: dict):
        """添加控制流边:条件分支"""
        # 简化实现:标记条件节点的分支关系
        true_branch = node.get("trueBody")
        false_branch = node.get("falseBody")
        if true_branch:
            child_id = self._node_counter
            self.graph.add_edge(node_id, child_id, edge_type="cfg_true")
        if false_branch:
            child_id = self._node_counter + 1
            self.graph.add_edge(node_id, child_id, edge_type="cfg_false")

    def _add_data_flow_edges(self, node_id: int, features: NodeFeatures):
        """添加数据流边:状态变量读写依赖"""
        # 标记状态写入节点,后续分析时追踪读取同一变量的节点
        self.graph.nodes[node_id]["state_var"] = features.variable_name
代码属性图的核心价值在于融合了三种代码关系:AST结构(语法层次)、控制流(执行路径)和数据流(变量依赖)。以重入漏洞检测为例,如果“状态变量写入”节点与“外部调用”节点之间存在特定数据流路径(先调用后写入),系统将标记为潜在重入风险。
3.2 图神经网络漏洞检测模型
# vulnerability_detector.py
# 基于 GNN 的智能合约漏洞检测模型

import torch
import torch.nn.functional as F
from torch_geometric.nn import GATConv, global_mean_pool
from torch_geometric.data import Data

# 漏洞类型标签
VULNERABILITY_TYPES = [
    "reentrancy",           # 重入攻击
    "access_control",       # 权限控制缺陷
    "integer_overflow",     # 整数溢出
    "unhandled_exception",  # 未处理异常
    "tx_origin",            # tx.origin 误用
    "dos",                  # 拒绝服务
    "bad_randomness",       # 可预测随机数
    "front_running",        # 交易前置攻击
]

class ContractVulnDetector(torch.nn.Module):
    """合约漏洞检测模型:基于图注意力网络(GAT)
    使用多头注意力机制聚焦关键代码节点"""
    def __init__(self,
                 input_dim: int = 6,          # 节点特征维度
                 hidden_dim: int = 128,
                 num_heads: int = 4,          # 注意力头数
                 num_classes: int = len(VULNERABILITY_TYPES),
                 dropout: float = 0.3,
                 ):
        super().__init__()
        # 输入投影层:将原始特征映射到隐藏空间
        self.input_proj = torch.nn.Linear(input_dim, hidden_dim)
        # 三层 GAT:逐层扩大感受野
        self.gat1 = GATConv(hidden_dim, hidden_dim // num_heads, heads=num_heads, dropout=dropout)
        self.gat2 = GATConv(hidden_dim, hidden_dim // num_heads, heads=num_heads, dropout=dropout)
        self.gat3 = GATConv(hidden_dim, hidden_dim // num_heads, heads=num_heads, dropout=dropout)

        # 批归一化:稳定训练过程
        self.bn1 = torch.nn.BatchNorm1d(hidden_dim)
        self.bn2 = torch.nn.BatchNorm1d(hidden_dim)
        self.bn3 = torch.nn.BatchNorm1d(hidden_dim)

        # 分类头:图级分类(整个合约是否有某类漏洞)
        self.classifier = torch.nn.Sequential(
            torch.nn.Linear(hidden_dim, hidden_dim // 2),
            torch.nn.ReLU(),
            torch.nn.Dropout(dropout),
            torch.nn.Linear(hidden_dim // 2, num_classes),
        )

        # 节点级分类:定位漏洞的具体代码位置
        self.node_classifier = torch.nn.Sequential(
            torch.nn.Linear(hidden_dim, hidden_dim // 2),
            torch.nn.ReLU(),
            torch.nn.Dropout(dropout),
            torch.nn.Linear(hidden_dim // 2, num_classes),
        )

    def forward(self, data: Data) -> dict[str, torch.Tensor]:
        """前向传播:返回图级和节点级的漏洞预测
        - 图级:整个合约是否存在某类漏洞
        - 节点级:哪些代码行存在漏洞"""
        x, edge_index, batch = data.x, data.edge_index, data.batch

        # 输入投影
        x = self.input_proj(x)
        x = F.relu(x)

        # GAT 层:消息传递与注意力聚合
        x1 = self.gat1(x, edge_index)
        x1 = self.bn1(x1)
        x1 = F.elu(x1)

        x2 = self.gat2(x1, edge_index)
        x2 = self.bn2(x2)
        x2 = F.elu(x2)

        x3 = self.gat3(x2, edge_index)
        x3 = self.bn3(x3)
        x3 = F.elu(x3)

        # 残差连接:防止深层网络梯度消失
        x_out = x1 + x2 + x3

        # 图级分类:全局平均池化
        graph_embedding = global_mean_pool(x_out, batch)
        graph_logits = self.classifier(graph_embedding)

        # 节点级分类:定位漏洞行
        node_logits = self.node_classifier(x_out)

        return {
            "graph_logits": graph_logits,     # [batch_size, num_classes]
            "node_logits": node_logits,       # [num_nodes, num_classes]
        }

    def predict_vulnerabilities(model: ContractVulnDetector,
                                 graph_data: Data,
                                 threshold: float = 0.5,
                                 ) -> list[dict]:
        """使用训练好的模型预测合约漏洞"""
        model.eval()
        with torch.no_grad():
            outputs = model(graph_data)

        # 图级预测:Sigmoid 输出概率
        graph_probs = torch.sigmoid(outputs["graph_logits"]).squeeze(0)
        node_probs = torch.sigmoid(outputs["node_logits"])

        results = []
        for idx, vuln_type in enumerate(VULNERABILITY_TYPES):
            prob = graph_probs[idx].item()
            if prob > threshold:
                # 找到该漏洞类型概率最高的节点(定位漏洞行)
                node_scores = node_probs[:, idx]
                top_node = node_scores.argmax().item()
                results.append({
                    "vulnerability": vuln_type,
                    "confidence": round(prob, 3),
                    "risk_level": "high" if prob > 0.8 else "medium",
                    "suspected_node": top_node,
                    "node_confidence": round(node_scores[top_node].item(), 3),
                })

        # 按置信度降序排列
        return sorted(results, key=lambda x: x["confidence"], reverse=True)
GAT(图注意力网络)相比普通GCN的优势在于注意力机制。并非所有代码节点对漏洞检测的贡献相同——外部调用节点、状态写入节点、条件判断节点才是关键,注意力机制会自动学习为这些节点赋予更高权重。双级分类(图级+节点级)的设计,既回答了“是否存在漏洞”,也回答了“漏洞位于何处”。
四、AI漏洞检测的误报困境与对抗风险分析
误报率是AI检测落地面临的最大障碍。在基准测试中,当GNN模型召回率(检出率)达到85%时,精确率(准确率)通常仅为40%-60%。这意味着每发现一个真实漏洞,需要人工审查1-2个误报。对于审计团队,高误报率的工具反而增加了工作量,得不偿失。
对抗样本是更深层的安全风险。攻击者可在合约中插入不影响逻辑的“噪声代码”(如无用变量声明、冗余条件判断),这些代码会改变代码图结构,使GNN模型注意力偏离真正的漏洞节点。此类对抗攻击在图像识别领域已被广泛验证,在代码分析领域同样可行。
训练数据偏差同样是模型泛化能力的瓶颈。公开漏洞数据集(如SmartBugs Wild)中,重入攻击和权限控制缺陷样本占比超过60%,而拒绝服务与前置攻击样本不足5%。数据不平衡导致模型对高频漏洞过度敏感,对低频漏洞几乎无检测能力。
五、总结
AI驱动智能合约漏洞检测的技术架构可概括为“代码图构建 + GNN语义建模 + 双级分类”。代码属性图融合了AST、控制流和数据流三种关系,GAT注意力机制聚焦关键代码节点,图级分类判断漏洞存在性,节点级分类定位漏洞位置。然而,误报率、对抗鲁棒性和数据偏差仍是当前技术的三大瓶颈。
关于落地路径,建议将AI检测定位为传统工具的补充而非替代,与Slither/Mythril的结果交叉验证以降低误报;生产环境设置置信度阈值过滤低质量告警;核心合约仍需人工审计兜底;对抗风险可通过集成多模型投票缓解;长期来看,需建设平衡的漏洞数据集,以提升模型泛化能力。


