
昨天晚上 1 点,OpenAI 的直播如约而至,其实预告阶段,答案已经基本写在脸上了。
没有废话,发布的就是 o3 和 o4-mini。
但奥特曼之前在预告里明明说过,o3 不打算单独发布,要融到 GPT-5 里一起发,结果今天又掏出来了,这操作也是让人有点猝不及防。
ChatGPT Plus、Pro 和 Team 用户从今天开始,就能在模型选择器中看到 o3、o4-mini 和 o4-mini-high,它们直接取代了 o1、o3-mini 和 o3-mini-high。
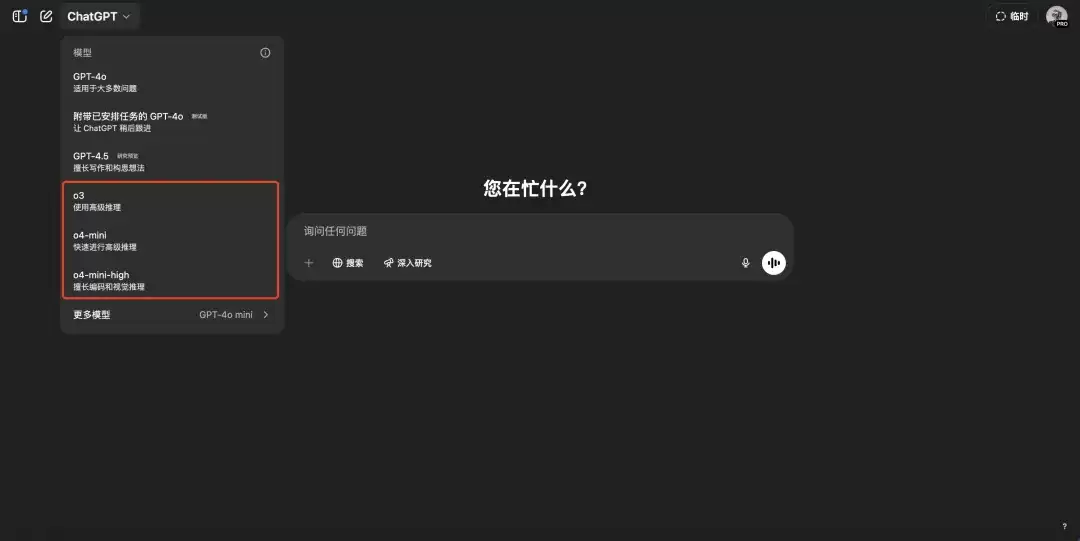
我的已经变了,但最想要的 o3 pro 还要等几周才能上线,有点可惜。现在 o1 pro 被折叠到了“更多模型”里。
说实话,单纯的模型参数进步,现在已经没什么可说的了。这次最让人兴奋的进步点,其实就两个:
- 满血版的 o3 终于可以用工具了。
- o3 和 o4-mini 是 o 系列中首个支持视觉推理的模型,第一次能够在思维链中思考图像。
照例,一个一个来说,争取给大家一个全面完整的总结。
一、o3 和 o4-mini 性能
其实没有太多意外,跟现在数码圈一样,就是刷新了各种分数。但惯例还是得放。
先看模型知识这块,一起放出来。
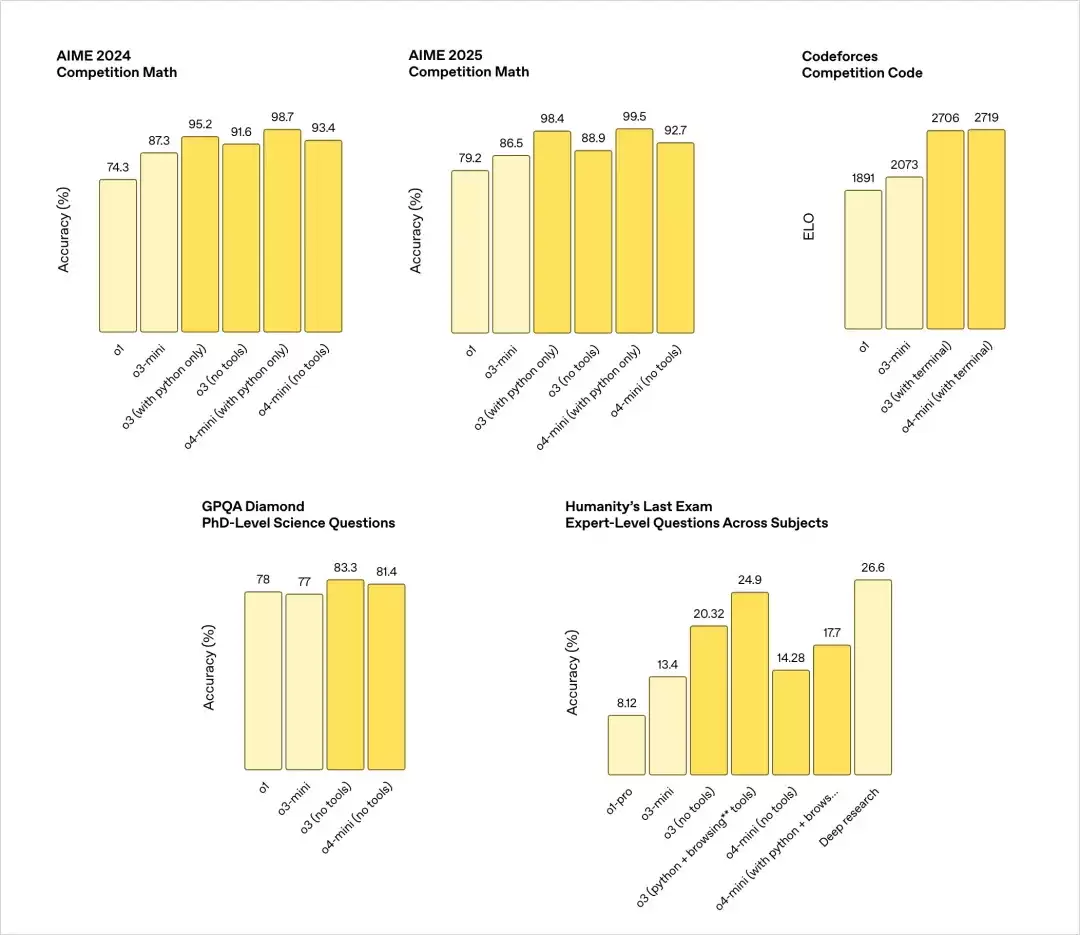
这里简单解释一下,别看底下模型那么多,变体也很杂,但从最早的 o1 到如今的 o3 和 o4‑mini,核心差别就在于模型规模、推理能力和插件工具的接入。
最开始的 o1 只是一个基础的推理大模型,它在 2024 年 AIME 数学赛上只有 74.3% 的准确率,在代码竞赛上的表现也相对平平。紧接着推出的 o3‑mini,虽然参数量更小,但经过架构优化,在同一场 AIME 上就跑出了 87.3% 的分数,Codeforces 的 ELO 也从 1891 提升到 2073。
而完整版的 o3,其实是比 o3‑mini 更大一号的“大兄弟”,o3 最明显的变化就是能接入工具了。比如在 AIME2024 里,o3 跑裸模(没接工具)时能达到 91.6%,一旦允许它调用 Python,准确率就飙升到 95.2%。同理,o4‑mini 相当于小一号的 o4,经过更先进的架构优化,在不开工具的情况下就能拿到 93.4%,接入 Python 后则冲到 98.7%,已经快干到满分了。
如果把视野放宽到跨学科的 PhD 级科学题(GPQA Diamond)和专家级综合测试(Humanity’s Last Exam),无需额外工具时,o3 在科学题上能以 83.3% 稍微领先于 o4‑mini 的 81.4%。而面对专家综合考题,不带插件的 o3 准确率约为 20.3%,添上 Python、网络浏览甚至调用多种工具后,能推到 24.9%。相比之下,o4‑mini 从 14.3% 起步,借助插件也只能涨到 17.7%,仍不及 o3。
最有趣的是,DeepResearch 在这个专家综合测试上力压群雄,但也能理解,毕竟它本身就是一个基于 o3 微调、专门干这活的模型。
多模态能力
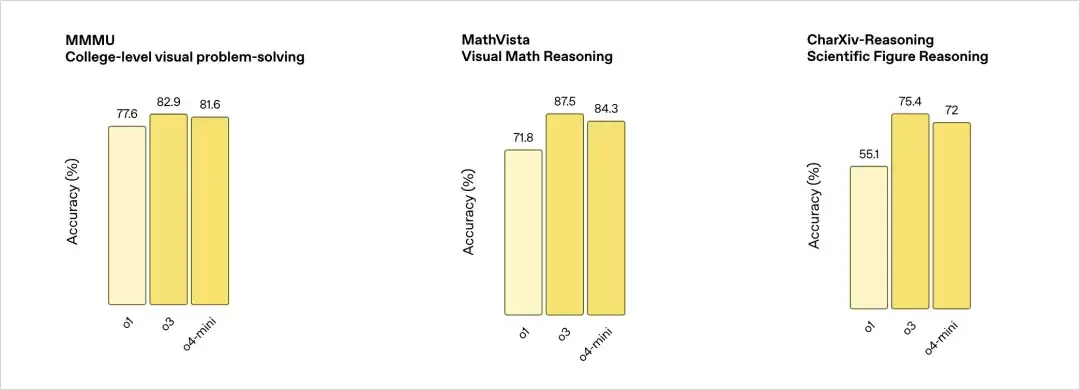
三个数据集:
- MMMU:大学水平的视觉数学题库,题目里既有公式也有图形,考察模型把图像和数学符号结合起来解题的能力。
- MathVista:专注视觉数学推理,题目多来源于几何图形、函数曲线、矩阵变换等图像,让模型从画面里看出数学规律。
- CharXiv‑Reasoning:从科学论文(ArXiv)里抽取图表、流程图和示意图,要求模型根据科研图形回答问题,考验它的专业图表理解能力。
o1 在大学级别的 MMMU 数据集上只能拿到 77.6%,面对直观的 MathVista 只有 71.8%,CharXiv-Reasoning 更是跪在 55.1% 的及格边缘。o3 一上来就把 MMMU 拉到 82.9%,MathVista 直接冲到 87.5%,CharXiv-Reasoning 也飙到 75.4%。这次是正儿八经地把视觉推理任务推到了一个新高度。
代码能力
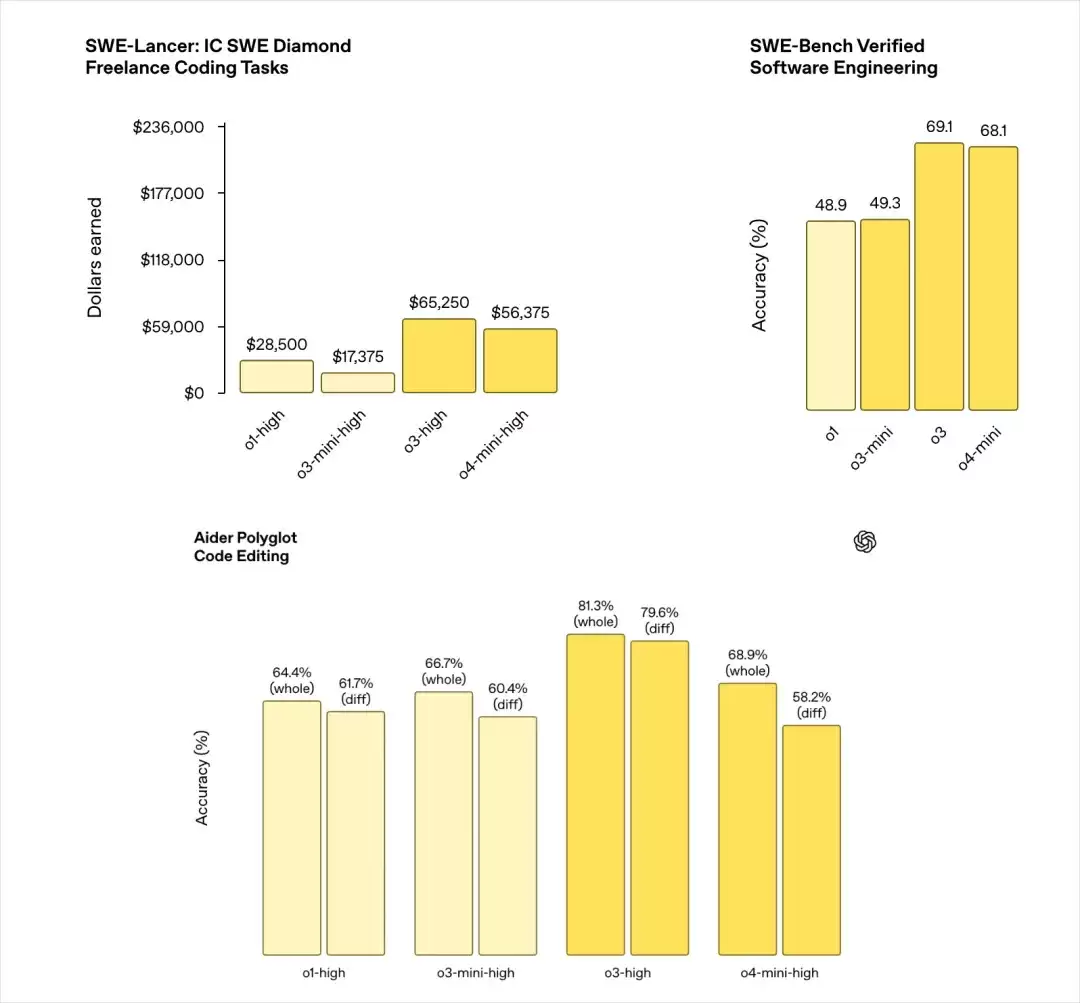
SWE‑Lancer: IC SWE Diamond 上,是真实的自由职业软件工程任务,模型以“高奖励”模式接单,看看最后能拿到的收益是多少钱。所有模型都直接上了 high 模式,o3 直接起飞了。
SWE‑Bench Verified:一个经人工标注验证的软件工程题库,包括常见算法、系统设计、API 调用等,o3 和 o4-mini 同样遥遥领先。
Aider Polyglot Code Editing:多语言代码编辑基准,分“whole”(整体重写)和“diff”(补丁式修改)两类。o3 还是强的,o4-mini 反而比 o3-mini 还差了一点。
工具使用
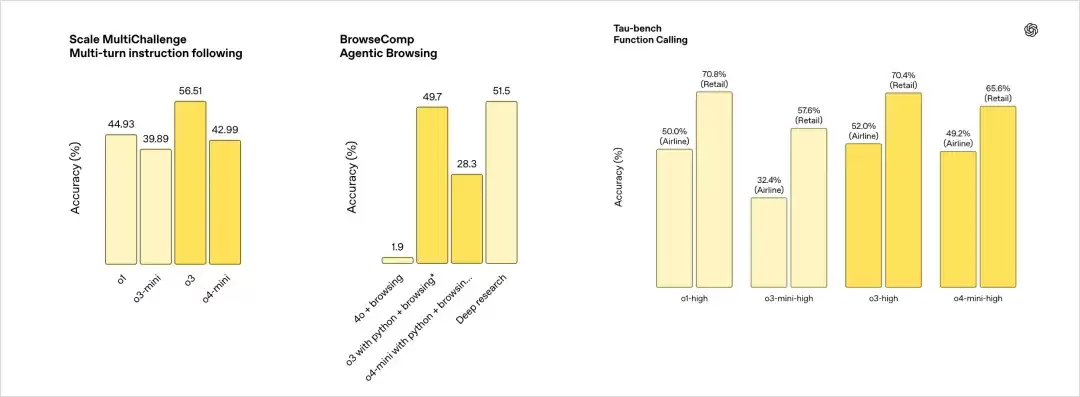
左边那个 Scale MultiChallenge,多轮指令跟随,是一套用来测记性加执行力的题。评测流程一般是:系统给模型一段设定,随后用户分好几轮追加、修改、插入条件,最后再要求一次性产出答案,模型既要把之前的上下文全部保住,又得正确理解最新指令,才能拿高分。o3 突出一些。
中间那个 BrowseComp Agentic Browsing,就是浏览器里干活的能力。题目会给模型接入一个虚拟浏览器,要求它自己去搜索、点击、翻页、在网页里抓信息,再整合成回答。常规的 AI 搜索就是 4o+联网的能力,低的有点可怜,o3 加了 Python 和联网之后,居然快能追上 DeepResearch,这确实有点出乎意料。
最右边那个叫 Tau‑bench 函数调用。它把模型放进有外部 API 可调用的场景里,看模型能否判断何时该把自然语言请求转成结构化函数调用,并把参数拼得毫无差错。常见两条赛道:Airline(根据乘客需求生成航班预订 JSON)和 Retail(根据购物指令调用商品查询或下单接口)。如果模型选错函数、漏填参数,或者格式写歪,都会直接扣分,所以这项测验主要检验模型从意图解析到结构化输出的链路是否稳固。这块,o3 相比 o1,几乎没有任何提升。
在翻看 System 卡时,还发现了一个有趣的数据。
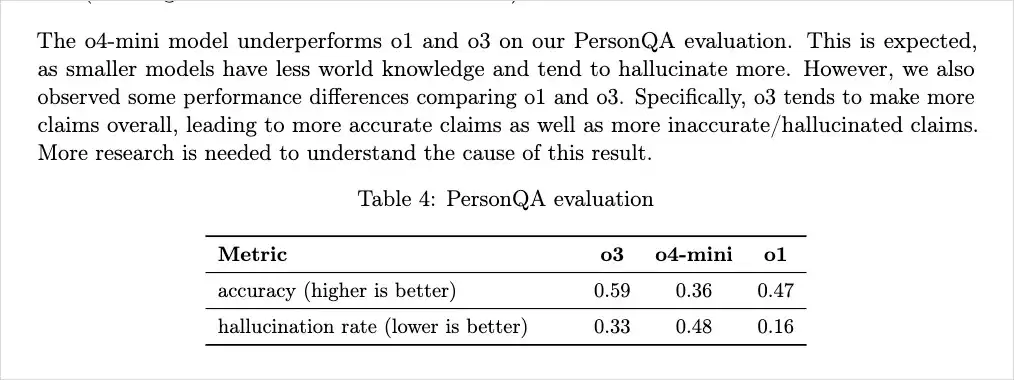
第一个指标是准确率,越高越好;第二个是幻觉率,越低越好。o3 因为整体上更敢下定论了,所以不会含糊其辞,准确率更高了,但幻觉率也飙升,直接干到了 o1 的两倍。
以上,就是 o3 和 o4-mini 的性能参数。
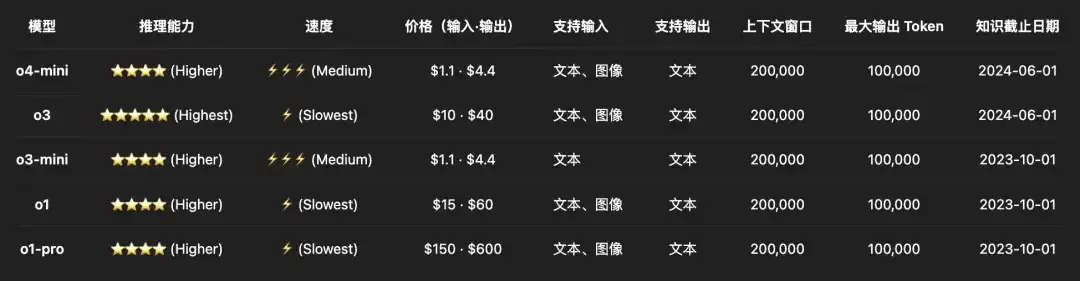
定价上,o3 比 o1 的定价便宜了三分之一,o4-mini 相比 o3-mini 没涨价。OpenAI 终于干了回人事。
二、使用工具以及视觉推理
o1 和 o1 pro 之前有个巨大的痛点,就是不能使用工具,联网、代码解释器啥的,一个都不行。而且只支持识图,连 PDF 文件都传不上去,太傻了。而这一次,o3 和 o4-mini 直接拉满,不仅支持了 OpenAI 的所有工具,甚至还有一个超级牛的新特性:视觉推理。
单听这个很难理解,直接看两个例子。
第一个,是一个经典的游戏——看图猜地点。但不是那种没难度的城市题,说实话,有建筑的话太好猜了。我们直接进一个专门玩这个的网站,叫图寻,参加每日挑战。第一题,就是这个。
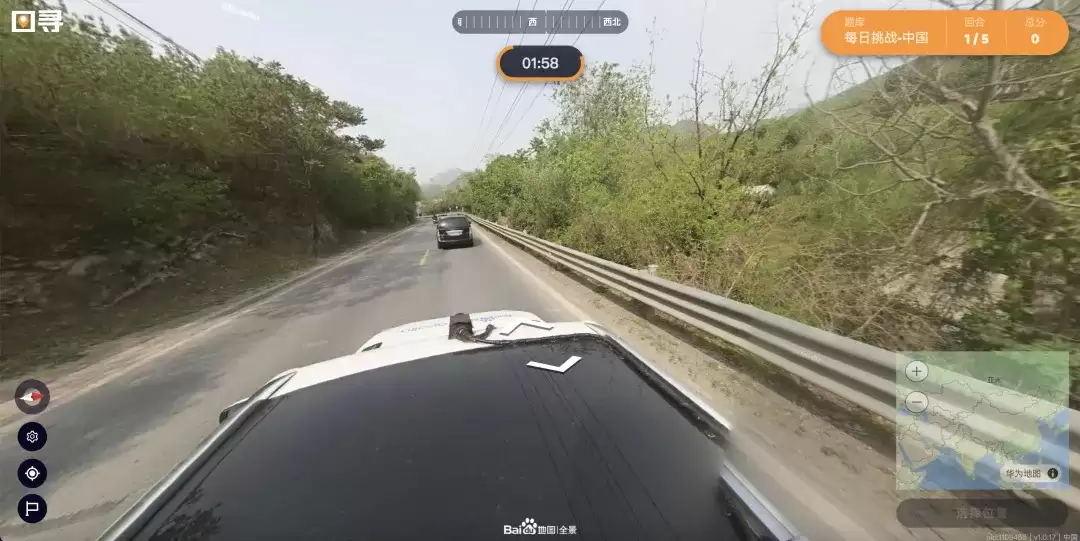
对,就这么个东西,让你猜这是中国的哪,在右下角的地图上打标,离终点越近,分越高。直接把这个扔给了 o3,来看看它的思考过程。
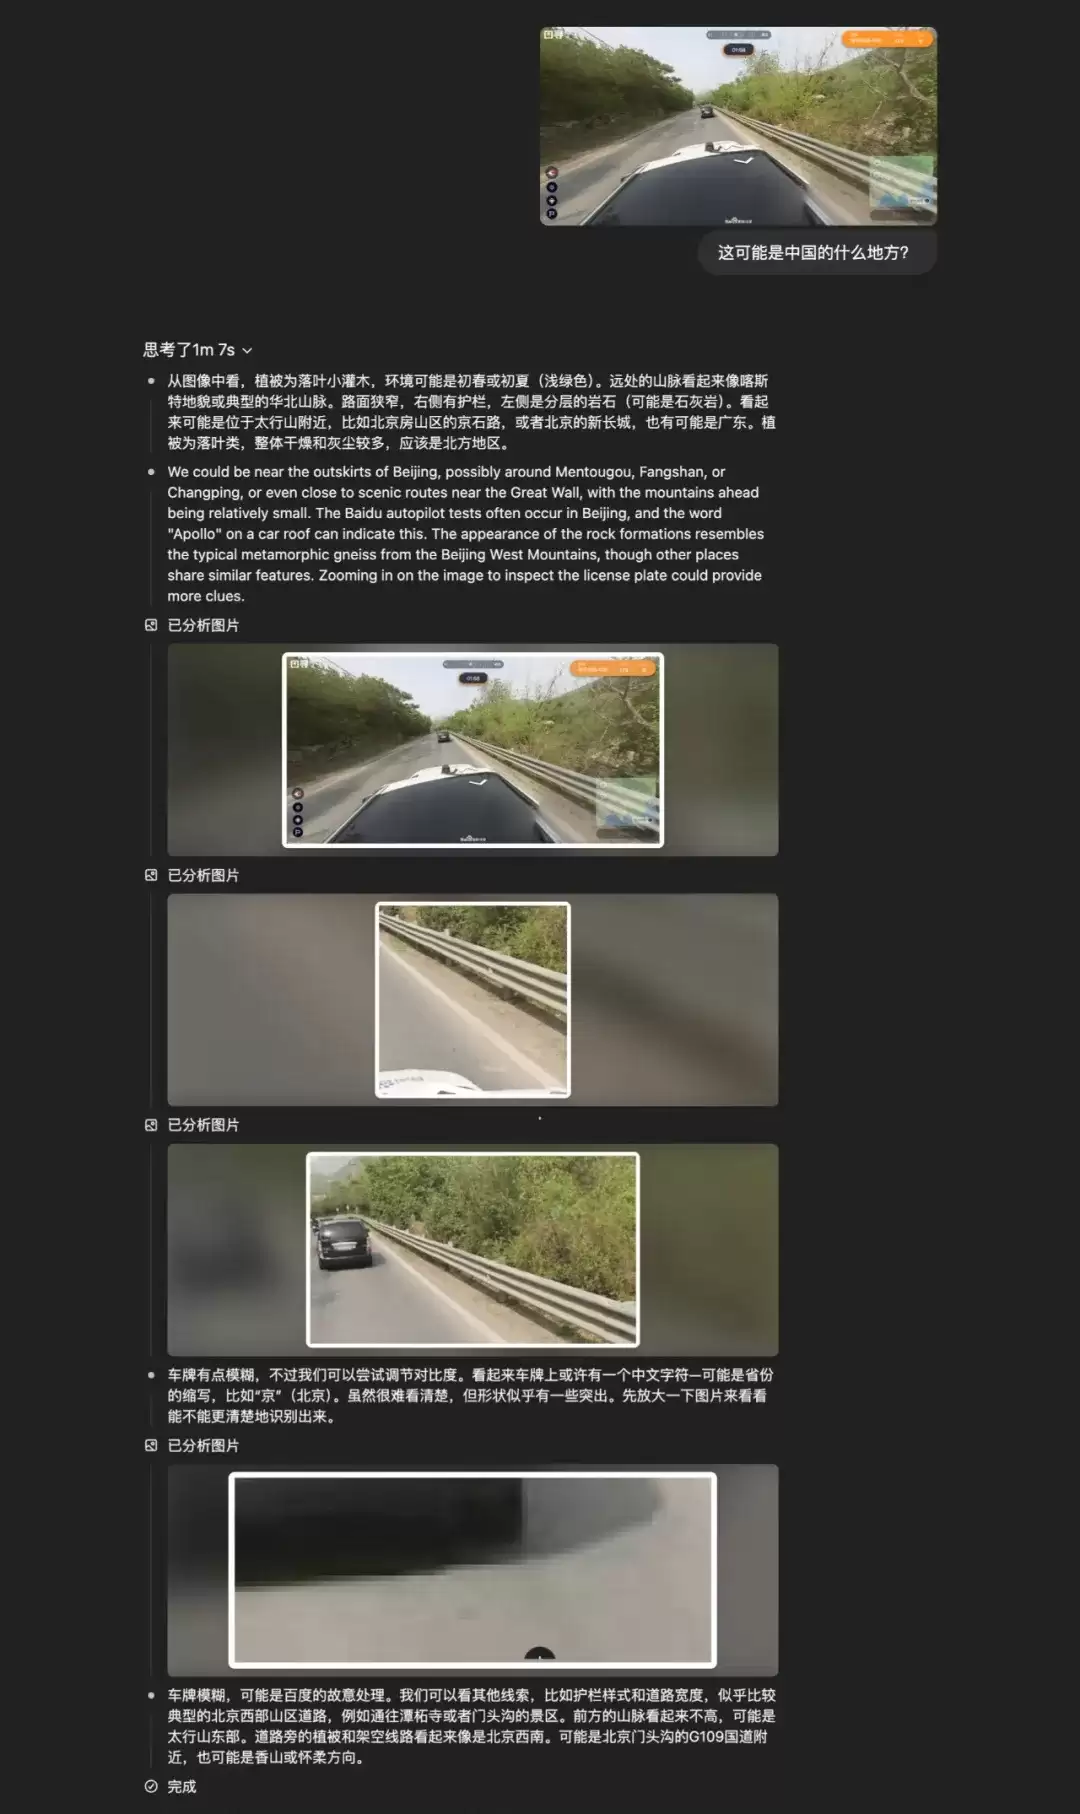
非常离谱,它自己去看图,把图片放大,一点一点思考:这个地方不对,换个地方再放大看看。以前模型的思维链,只有文字,而这次,是大模型第一次真正把图片也融入到了推理中。
回过头来看看刚才那道猜地题,它给出的答案。
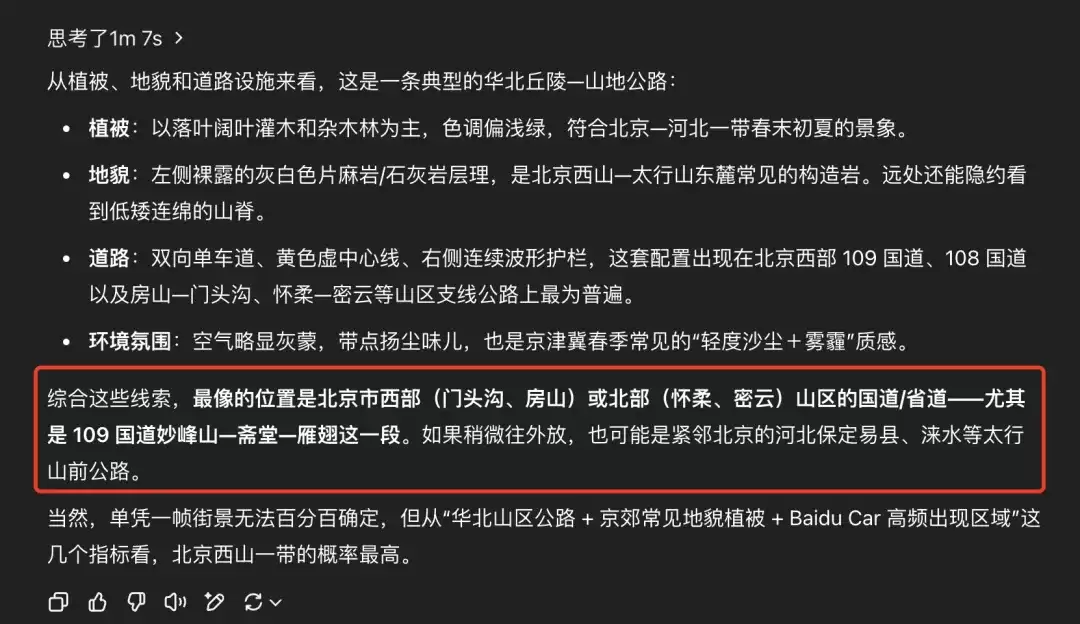
虽然没有那么肯定,但也给出了答案:北京门头沟、房山,109 国道,妙峰山那一段。揭晓答案。
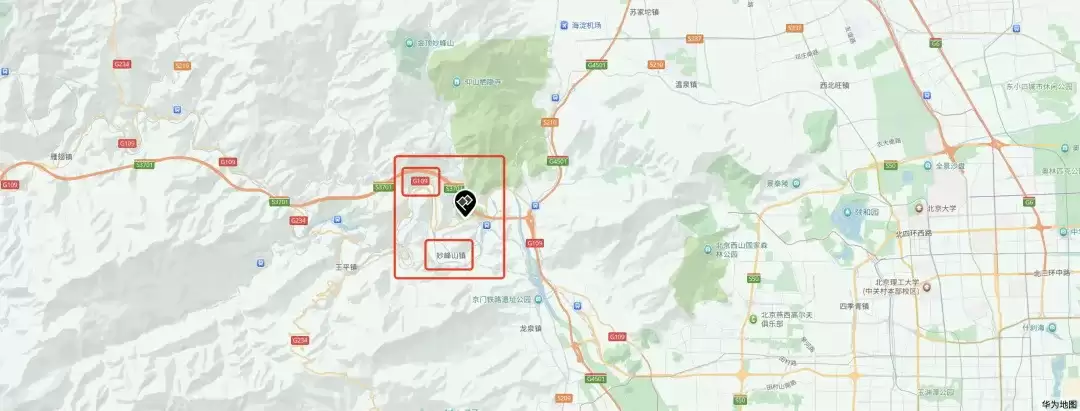
可能有些人对这个地点不熟悉,这个地方叫北京,门头沟,109 国道,妙峰山。那一刻,真的有点起鸡皮疙瘩了。因为你会发现,AI 开始像人一样去看图、像人一样去思考了。以前你说 AI 懂图,懂什么?懂像素?懂特征?是的,它会提特征、会分类、会打标签,但它并不看图思考。它是一个图像识别器,但不是一个图像思考者。而今天,o3 是第一次让模型学会了看图思考,学会了视觉推理。这个变化,堪称范式级别的跃迁。
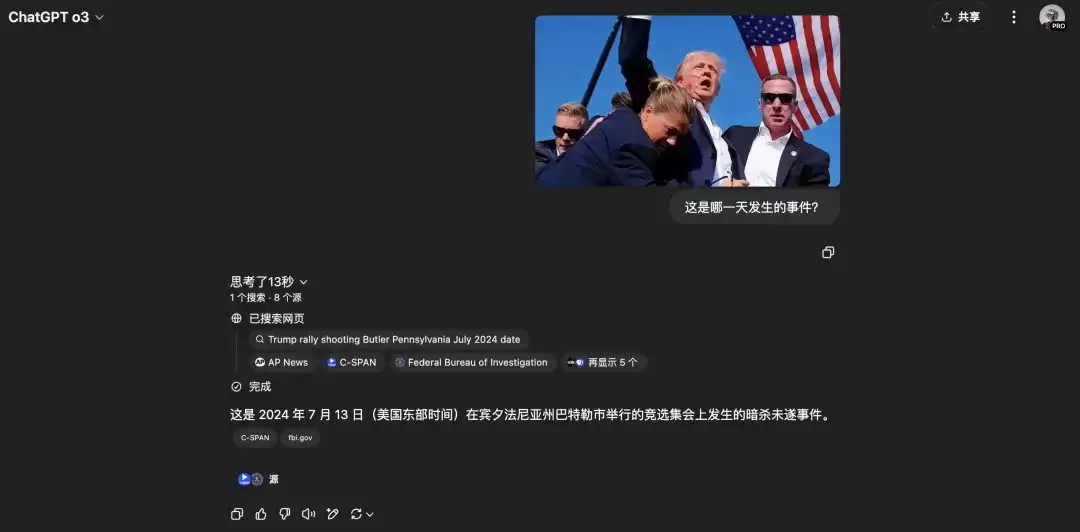
我们甚至可以,把一个事件的图片发给他,让他来寻找这是哪一天发生的事件。
还有一个有趣的例子,虽然不算成功,但还是很想分享给你看。前天,《流浪地球 3》正式开机了,官方也发了一张大合照,官宣了沈腾的加入。然后,尝试让 o3 在里面找到吴京。第一次,失败了。
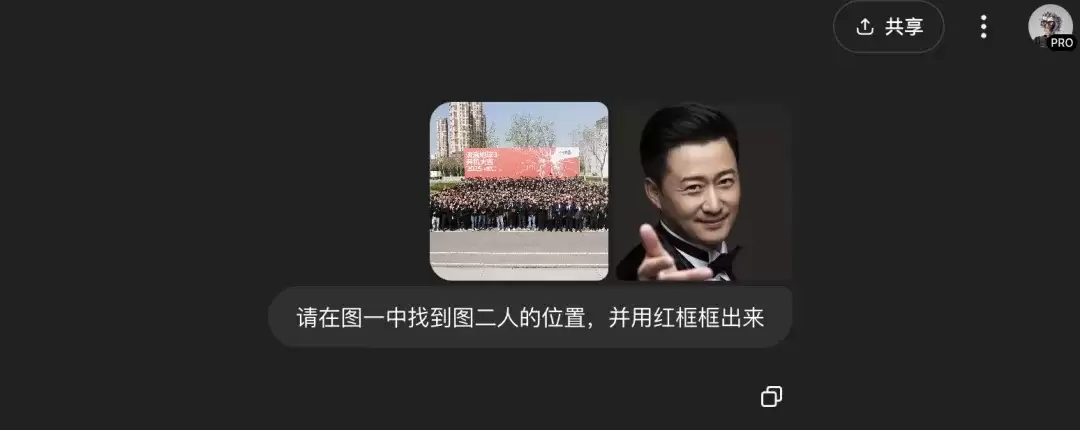
因为那天太晒,吴京和沈腾都带了帽子,几乎无法靠脸识别了。于是,又去找了一张图。
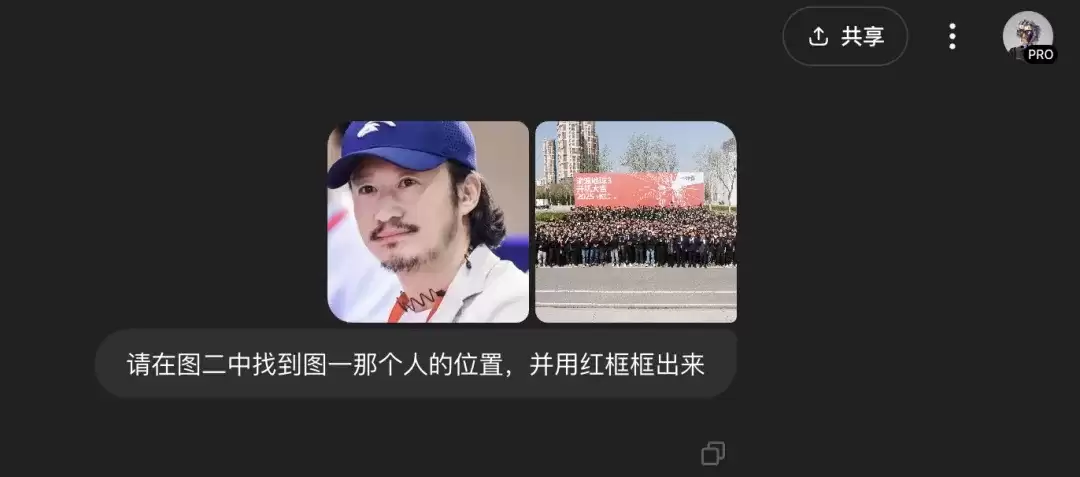
这一次,它成功了,当然,靠的是找帽子。
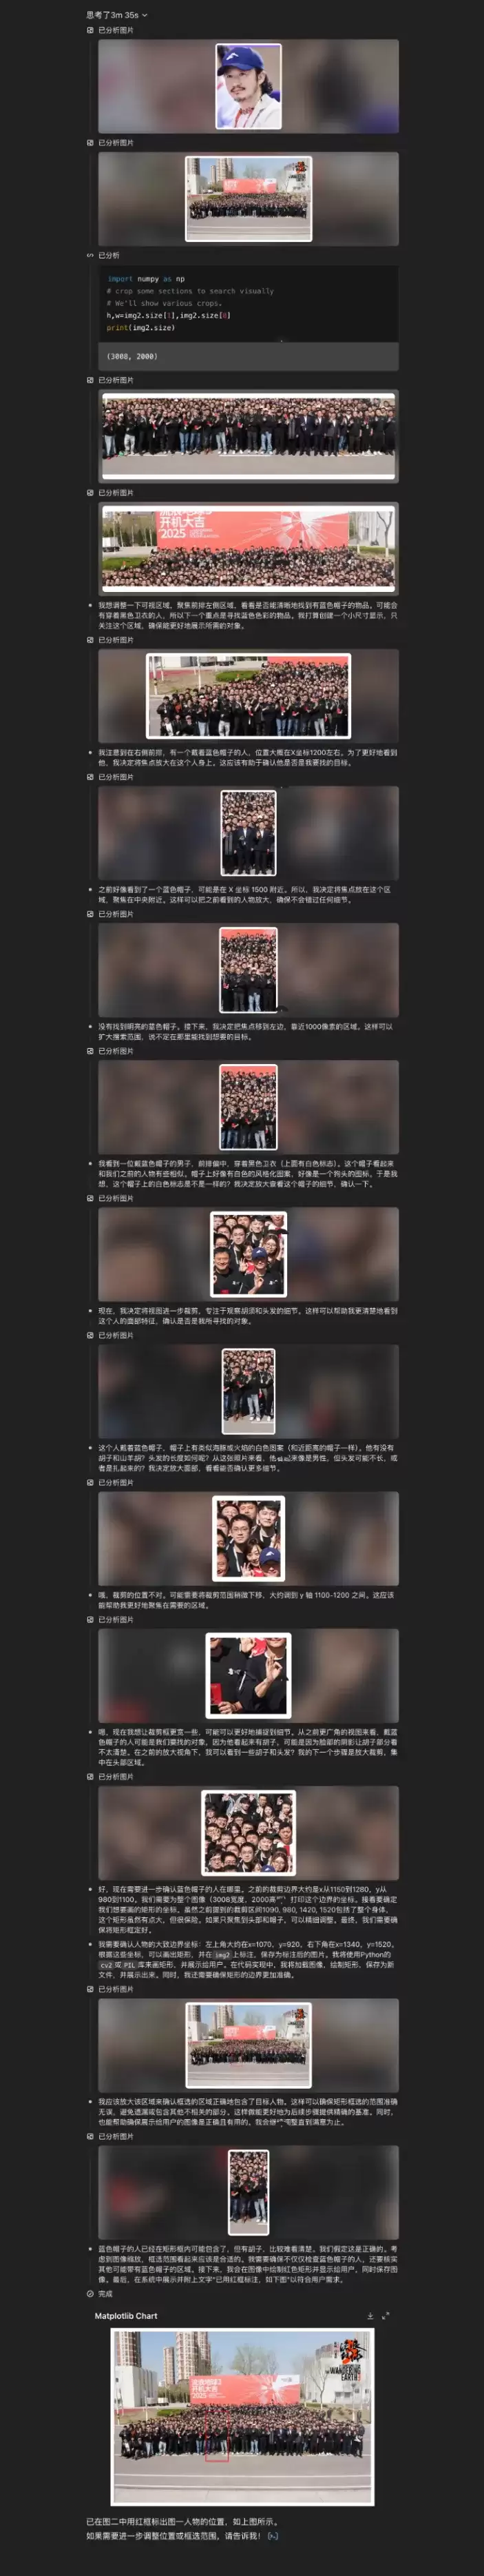
这个 case 完整地展现了 o3 的能力,包括在中间各种放大查看细节、跟 Python 结合进行分析以及加红框等等。视觉推理让 AI 具备了第一种专业场景下的观察力。而视觉推理这个能力的普及,意味着很多原本需要人眼判断的岗位,会被彻底改写。安全监控不再是看到异常才报警,而是看到将要发生异常就提前预判;设计审稿不再是人力盯图,而是 AI 先过一遍排版,再交给人来最后决策;医生看片子,也不再只是看片,而是由 AI 先提出几个可能的诊断路径和可能遗漏点,再辅助手术或治疗。这就像,当年推理模型对非推理模型的冲击,而现在,又一次上演。
写在最后
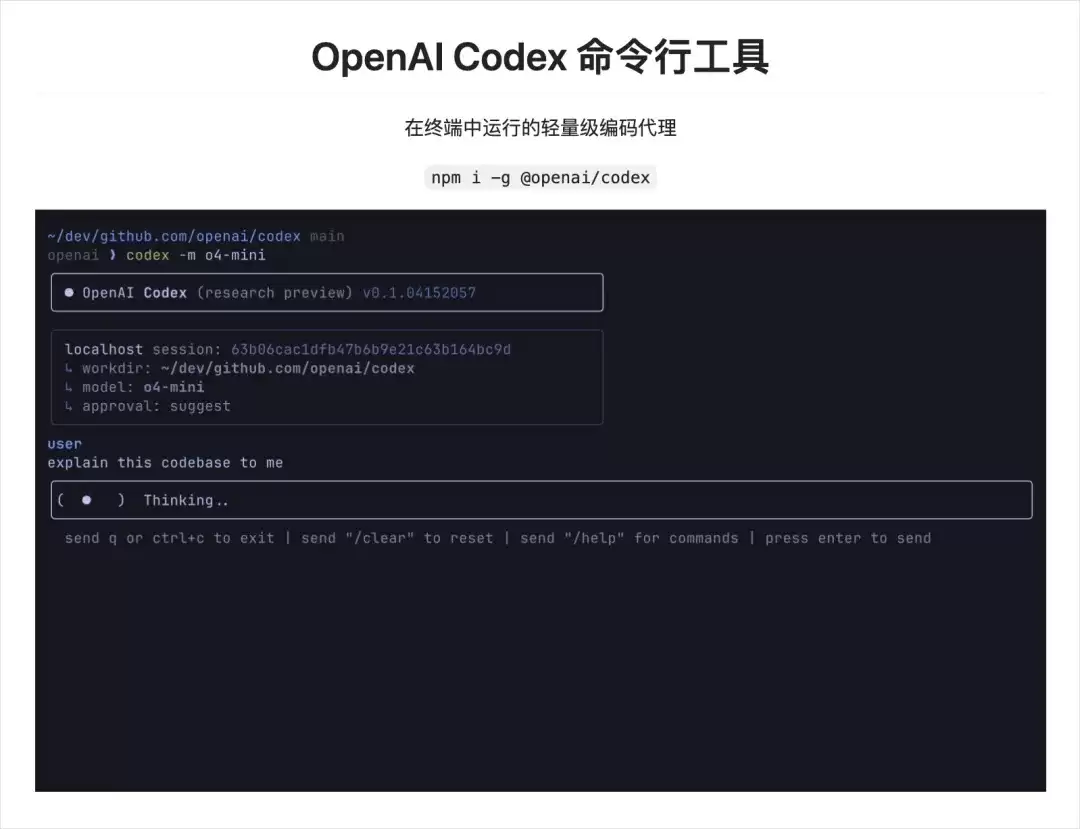
除了 o3 和 o4-mini 之外,OpenAI 这次还开源了一个 AI 编程工具。
这一次,看到 OpenAI 掏出来的模型,忽然想起很多年前,人类第一次拍到地球全貌时的震撼。一颗蓝色的球,悬在黑色的宇宙中。那张图,改变了很多人的世界观。而今天,当 AI 第一次看懂图、思考图、把图当做世界的一部分去推理,我们或许也站在了某种第一次的起点。它会改变什么?现在还不知道。但可以确定的是,一定会有所改变。


