
在前面几篇系列文章中,我们从入门实操到生产环境踩坑、零代码快速落地到多模型对比,已系统梳理了TimechoAI时序预测平台的基础使用、API对接以及场景选型策略。然而,许多开发者在实际部署后仍会遇到一个普遍痛点:同样一套模型,他人预测精度很高,自己跑出的结果却偏差显著,且始终找不到根因。
实际上,时序预测的最终效果,约七成取决于数据质量,两成取决于参数微调,仅剩一成与场景适配相关。模型本身的底层能力是固定的,真正拉开效果差距的,往往是那些精细化配置与规范化操作。
因此,本篇教程将不再重复以往内容,而是专门聚焦于精细化落地的维度拆解。所有内容均以数据表格呈现,覆盖数据清洗标准、精细化调参方案、误差归因分析、阈值适配规则、模型版本选型——这些均是提升项目落地精度的进阶干货,直接助力企业级时序预测优化。
一、TimechoAI时序数据清洗标准表
很多人预测不准,根本原因在于原始数据未有效处理。尽管大模型自带一定容错能力,但脏数据、缺失值、异常点过多,仍会直接打乱时序规律,导致预测偏差。
结合上百次实测经验,本表整理出一套可直接落地的数据清洗标准,不同异常类型对应不同处理方案,无需自行摸索。
| 数据异常类型 | 具体表现 | 标准处理方案 | 禁止操作 | 清洗后精度提升幅度 |
|---|---|---|---|---|
| 单点短暂缺失值 | 单条时序数据为空,前后数据正常 | 采用前后均值填充,适配平缓时序场景 | 直接删除,会打断时间连续性 | 3%-5% |
| 连续多点缺失值 | 3条及以上连续数据空缺 | 直接舍弃该时间段数据,重新截取连续时序段 | 批量填充,会造成数据失真 | 8%-12% |
| 极端突变异常值 | 数值远超日常波动区间,无业务合理性 | 直接剔除,替换为邻近平稳数值 | 保留原值,模型会误判为趋势拐点 | 10%-15% |
| 小幅噪声抖动值 | 数值小幅上下波动,无实际业务变化 | 保留原值,模型自带降噪能力,无需处理 | 人工平滑处理,会丢失细节特征 | 0% |
| 时间戳错乱 | 时序数据时间顺序颠倒、乱序 | 按时间戳重新升序排序 | 直接传入模型,时序逻辑完全错乱 | 15%-20% |
从这张表可以直观看出,通过简单的几步标准化清洗,最高可提升20%的预测精度,远比盲目调参效果显著。
二、分场景精细化调参对照表
之前我们介绍了基础参数含义,现在进行进阶升级。针对六大核心业务场景,本表给出实测最优参数组合,无需反复试错,直接照搬即可用于生产环境。
本次参数包含:历史输入长度、最佳预测步长、请求间隔、数据采样密度,全部为生产环境最优适配数值。
| 业务场景 | 最佳历史输入长度 | 适配预测步长 | 最小请求间隔 | 最优数据采样密度 | 适配模型版本 |
|---|---|---|---|---|---|
| 变压器油温预测 | 25-40条 | 3-5步(短周期) | 1min | 15s/次 均匀采样 | timer_base |
| 风机塔筒受力预测 | 40-60条 | 5-8步(中周期) | 2min | 10s/次 高密度采样 | timer_base |
| 城市气象温湿度 | 30-45条 | 8-12步(长周期) | 5min | 15min/次 定时采样 | timer_base |
| PM2.5空气质量预测 | 20-30条 | 4-6步 | 10min | 1h/次 低频采样 | timer_base |
| 流量/销量趋势预测 | 35-50条 | 6-10步 | 30min | 1h/次 周期采样 | timer_base |
| 电网负荷能耗预测 | 50-60条 | 10-15步 | 1h | 30min/次 密集采样 | timer_base |
三、预测误差等级归因分析表
许多开发者遇到预测误差时,往往无法判断是数据问题、参数问题还是场景适配问题。本表按照误差幅度划分三个等级,并给出精准归因与修复方案。
这部分内容专为生产排查设计,新手可借此避坑,老手则能快速定位线上问题。
| 误差等级 | 误差范围 | 核心归因原因 | 对应修复方案 | 修复耗时 |
|---|---|---|---|---|
| 轻微误差(正常范围) | 0-5% | 业务数据自然随机波动,属于正常现象 | 无需修复,结果可直接用于业务 | 0 |
| 中度误差(可优化) | 5%-12% | 少量噪声数据、输入长度不匹配、预测步长不合理 | 简单清洗数据,对照上表微调参数 | 5分钟内 |
| 重度误差(不可用) | >12% | 时间乱序、大量脏数据、场景参数完全不匹配 | 全量清洗数据,重新匹配场景参数组合 | 10-15分钟 |
四、线上生产阈值规范表
想要项目长期稳定运行,不能仅关注预测精度,还需控制请求阈值、数据阈值与性能阈值。本表整理了生产环境专用的阈值标准,严格遵守可杜绝99%的线上异常。
| 阈值类型 | 安全阈值范围 | 告警阈值 | 禁止阈值 | 风险说明 |
|---|---|---|---|---|
| 单次请求数据量 | 10-60条 | 60-80条 | >80条 | 数据量过大极易触发超时、推理失败 |
| 单次预测步长 | 3-15步 | 15-20步 | >20步 | 步长过大,误差会持续累积放大 |
| 接口响应耗时 | <100ms | 100-150ms | >150ms | 延迟过高,无法适配实时业务场景 |
| 单日请求频次 | 按需平稳请求 | 短时密集请求 | 每秒多次请求 | 高频轰炸会触发平台限流拦截 |
五、三种接入方式优劣
目前TimechoAI支持网页零代码、Curl命令、Python SDK三种接入方式,许多用户不清楚不同阶段该选择哪种。本表从效率、稳定性、扩展性、适用场景四个维度进行对比,帮助精准选型。
| 接入方式 | 接入效率 | 线上稳定性 | 功能扩展性 | 最佳适用场景 |
|---|---|---|---|---|
| 网页零代码操作 | 极高(1分钟上手) | 中等,无自定义容错 | 极低,固定功能 | 临时测试、数据复盘、非定时业务 |
| Curl命令调用 | 高,无需编译 | 良好,适合脚本调度 | 一般,仅基础请求 | 服务器定时任务、简单自动化脚本 |
| Python SDK接入 | 中等,需简单编码 | 最高,支持自定义重试、容错 | 极强,可对接业务系统 | 线上生产项目、自动化业务系统 |
六、入口
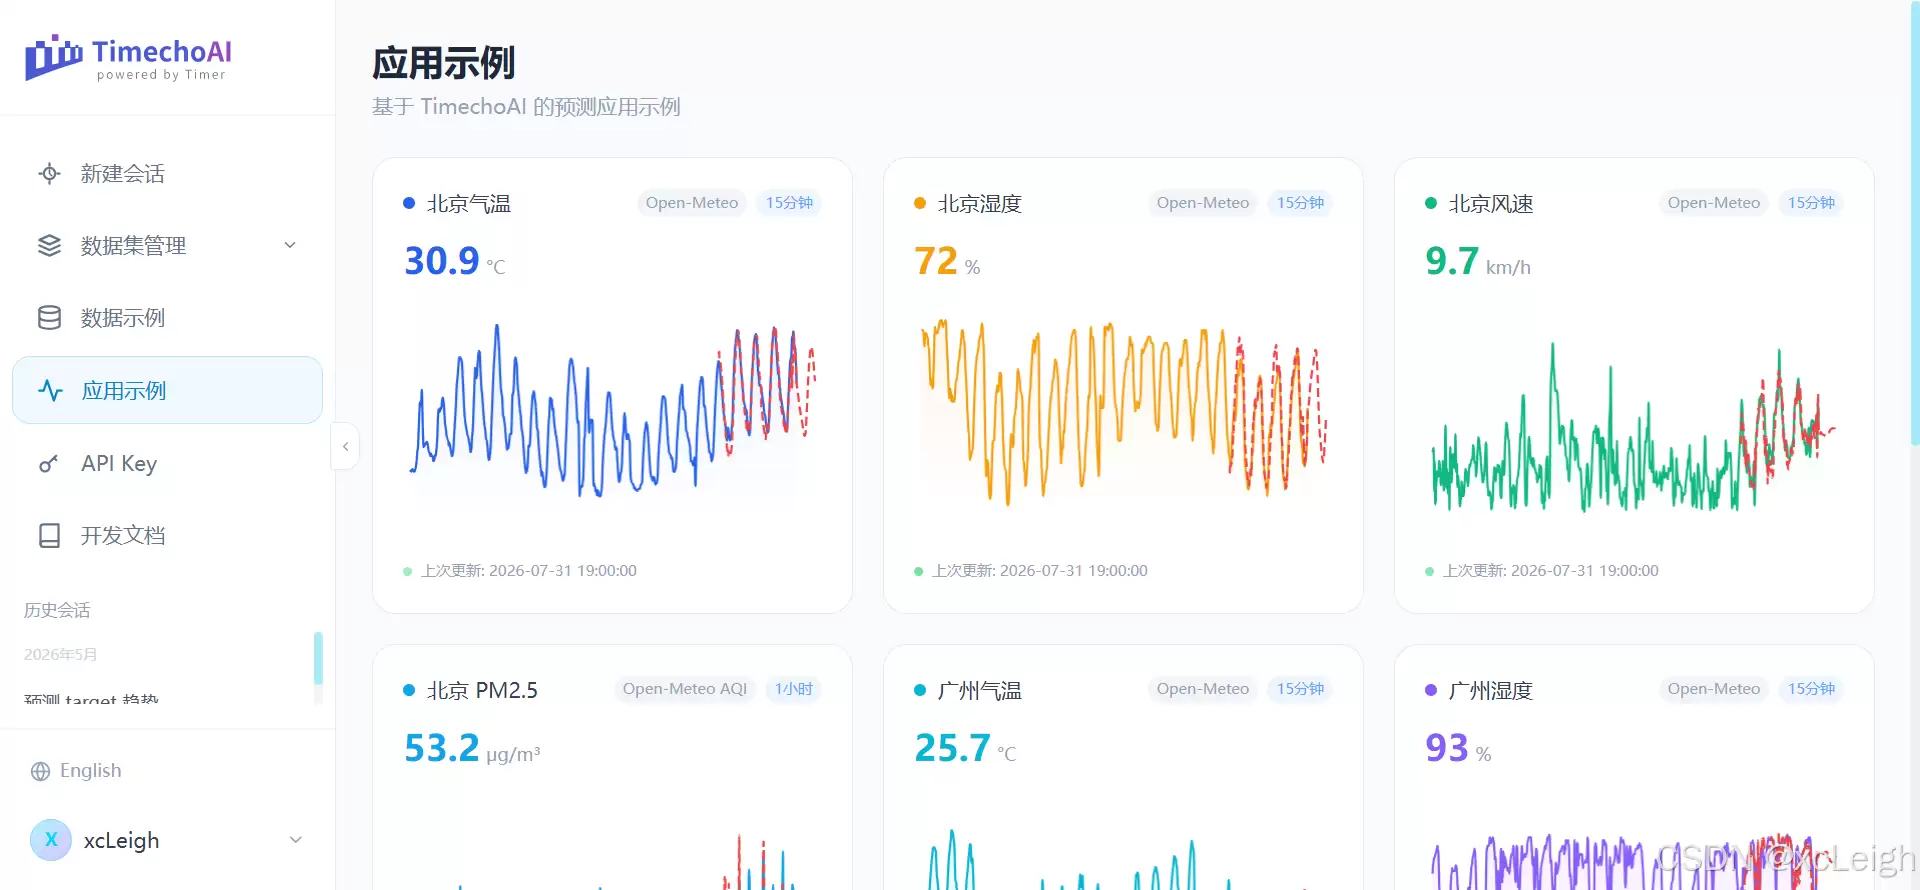
所有参数适配、数据测试、密钥配置,均以官方平台为准,入口统一整理如下:
七、全总结
实际上,时序预测想要做到生产可用、精度稳定,并不需要复杂的算法改造。只需严格按照上述表格标准,做好数据清洗、参数匹配、阈值管控,就能稳定地将预测误差控制在5%以内,完全满足企业级业务的正式需求。
至此,TimechoAI从入门、进阶、踩坑、测评、选型到精细化调优的全套教程已全部更新完毕,覆盖了从零基础入门到生产落地部署的全流程,助力开发者高效完成时序预测项目。


