
在教育培训领域,高品质视频内容的高昂制作成本始终是行业痛点。真人录制不仅需要讲师、场地、设备等资源,后期制作周期漫长,而且一旦内容需要更新,几乎等同于重新拍摄。更棘手的是,由于优秀讲师资源稀缺,规模化复制几乎不可能。而数字人视频技术的出现,为这些问题提供了全新思路——只需输入文本即可生成视频,内容可随时修改,一次制作便能无限复制。本次,我们基于魔珐星云的参数流API,从零搭建了一个AI数字人视频生成平台,仅耗时2小时。该平台支持纯文本输入,系统自动将其转换为SSML格式,服务端响应仅需约500毫秒,3分钟即可生成一段1分30秒的高清视频,成本极低,具备规模化应用潜力。这项技术本质上是具身交互智能在教育场景的落地实践,让AI数字人真正成为智能教学助手,有效降低教育视频制作门槛。
一、项目背景与目标
1.1 为什么选择数字人视频?
教育培训领域中,优质内容的生产成本始终是核心痛点:
- 真人录制成本高昂:讲师时间、场地、设备、后期制作,每一项都是不小的开支
- 内容更新困难:视频制作完成后,修改成本极高,甚至需要重新拍摄
- 规模化复制困难:优质讲师资源有限,无法满足大量课程的制作需求
而数字人视频解决方案,能有效化解这些难题:
- 输入文本即可生成视频,无需真人出镜
- 随时修改文本内容,实时更新视频,无需重拍
- 一次制作,无限复制,轻松实现规模化生产
1.2 为什么选择魔珐星云?
市面上数字人方案众多,选择魔珐星云主要基于以下几点:
- 参数流技术:服务端下发驱动参数,客户端渲染解算,端到端响应约500ms,延迟极低
- 高质量形象:3D超写实数字人,表情、口型、微动作都十分自然,不同于早期僵硬效果
- API开放:提供完整的RESTful API,易于集成,无需从零开发底层能力
- 成本可控:按量计费,适合中小团队,避免初期投入过高
二、前提准备:5步完成环境配置
步骤1:注册魔珐星云账号
访问魔珐星云官网,点击“注册”,填写手机号和验证码,完成注册后登录控制台。这一步比较简单,按常规操作即可。
步骤2:创建视频应用
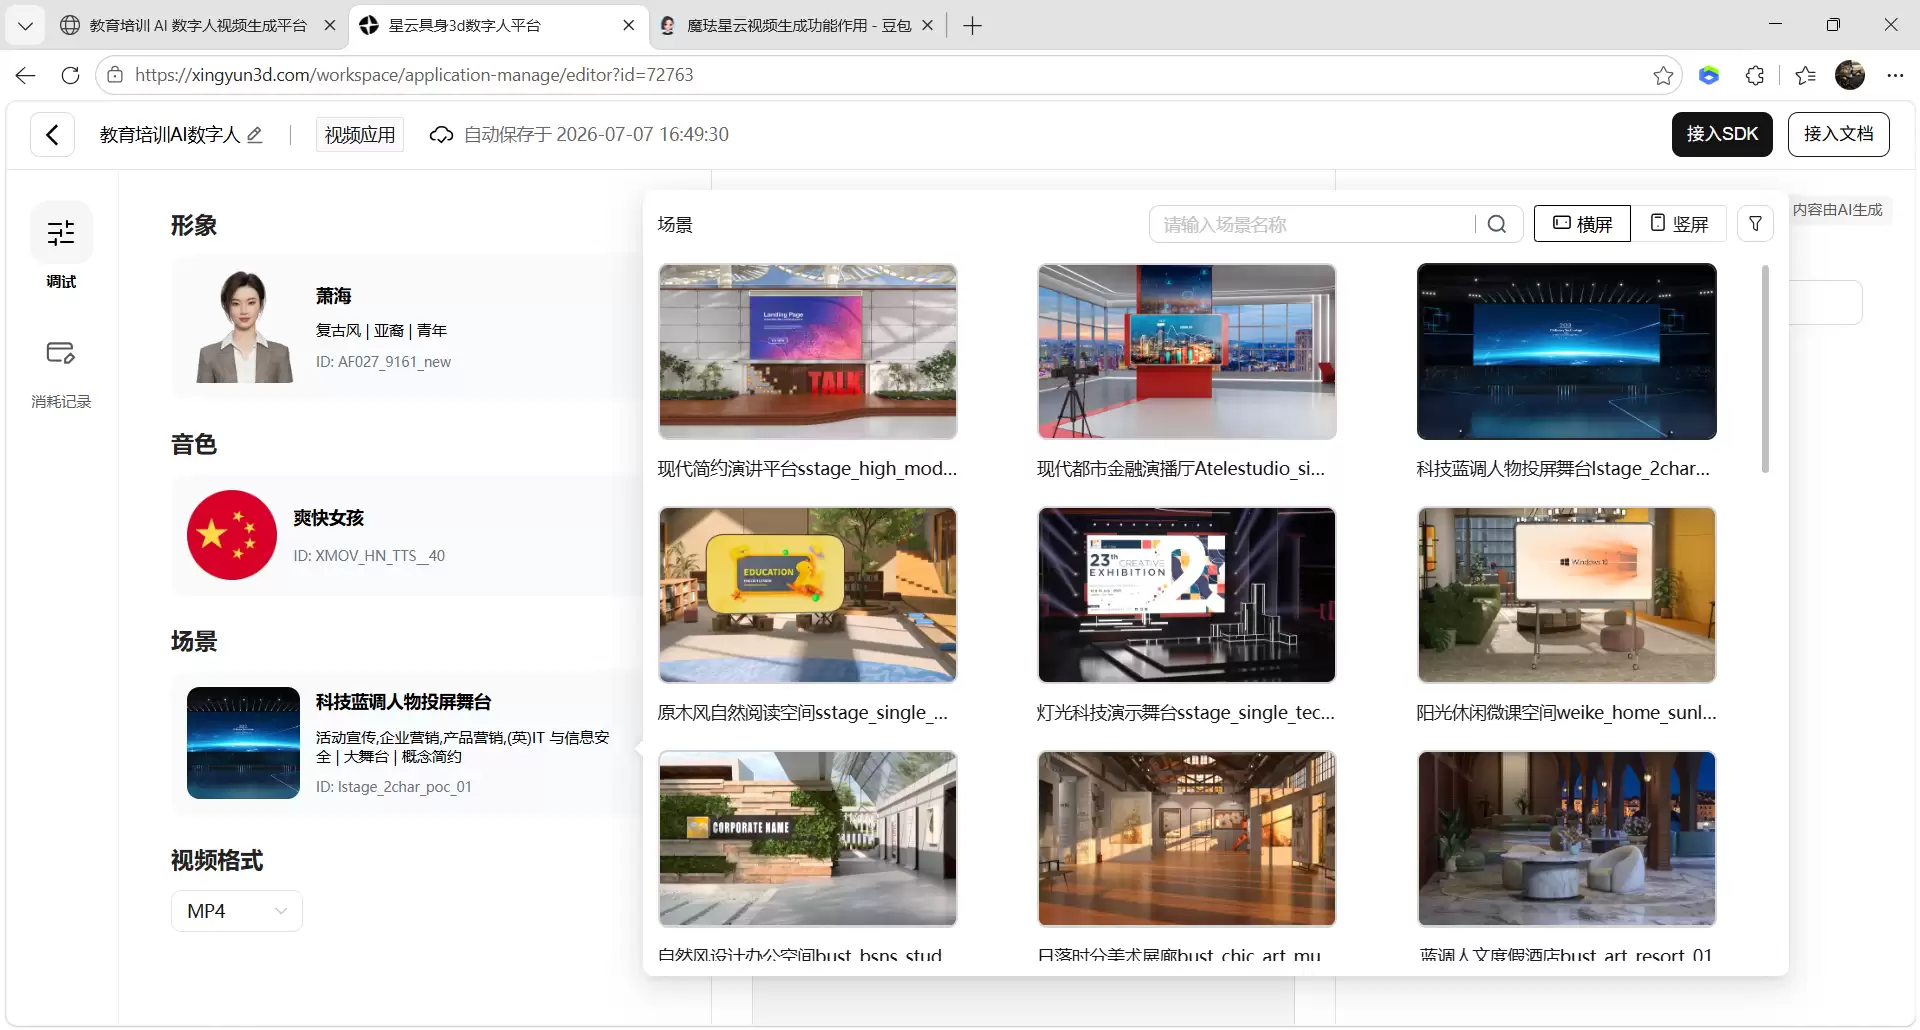
进入控制台后,点击“创建应用”,选择“视频生成”应用类型,填写应用名称(例如“教育培训数字人”),完成创建后进入应用详情页。界面清晰直观,按提示操作即可。

步骤3:配置人物形象
在应用详情页点击“形象管理”,选择或上传自定义人物形象,配置发型、服装、背景等参数,然后保存形象ID(例如 N_Wuliping_12298_new)。这个ID后续会用到。

步骤4:配置音色
点击“音色管理”,试听并选择合适的音色,保存音色ID(例如 XMOV_HN_TTS__40)。声音种类丰富,可根据课程风格挑选合适的音色。

步骤5:配置场景并获取密钥
点击“场景管理”,选择演播室背景,保存场景ID(例如 sstage_single_tech_black_01)。然后点击“接入SDK”,复制APP_ID和APP_SECRET,这两个是后续调用的重要凭证。

三、技术架构与核心原理
2.1 整体架构
整个平台分为前端、后端和魔珐星云API三层。前端负责用户交互(左右分栏布局,包含文本输入和任务列表),后端使用Flask处理业务逻辑,魔珐星云API负责实际的数字人视频生成。数据流如下:
┌─────────────────────────────────────────────────────────┐
│前端(Web)                                                 │
│- 左右分栏布局                                            │
│- 纯文本输入 → 自动转换SSML                               │
│- 任务列表展示(视频点击展开)                               │
└─────────────────────────────────────────────────────────┘
↓
┌─────────────────────────────────────────────────────────┐
│后端(Flask)                                               │
│- 任务创建API                                             │
│- 任务状态查询API                                         │
│- 任务数据持久化(JSON)                                    │
└─────────────────────────────────────────────────────────┘
↓
┌─────────────────────────────────────────────────────────┐
│魔珐星云API                                               │
│- 鉴权(X-APP-ID + X-TOKEN)                                │
│- 创建任务                                                │
│- 查询状态                                                │
│- 参数流技术(AI端渲 + 端侧解算)                           │
└─────────────────────────────────────────────────────────┘
2.2 参数流技术:为什么能实现约500ms响应?
传统数字人视频生成方案通常如下:
文本 → 语音合成 → 口型驱动 → 表情渲染 → 视频编码 → 下载播放
       ↓            ↓           ↓           ↓           ↓
     服务端        服务端       服务端       服务端      服务端
每个环节都在服务端完成,端到端延迟通常达到5-10秒,用户体验较差。
魔珐星云的参数流方案则完全不同:
文本 → 驱动参数(口型系数/表情参数/姿态指令) → 客户端渲染解算 → 播放
       ↓              ↓                        ↓
     服务端          网络传输                 客户端
服务端只下发参数(仅几KB大小),而非传输完整视频(几十MB),客户端利用本地算力完成渲染和解算。网络传输延迟极低,端到端约500ms,这是实现快速响应的关键所在。
2.3 鉴权机制:MD5签名
魔珐星云API采用X-TOKEN签名机制,每次请求都需携带签名。签名生成规则如下:
def generate_token(method, api_path, data, secret, timestamp):
    """生成X-TOKEN签名
    签名规则:
    1. 将data按key排序,转为JSON字符串
    2. 拼接: api_path + method + data_json + secret + timestamp
    3. 计算MD5哈希值
    """
    sort_json_str = json.dumps(dict(data), sort_keys=True).replace(' ', '')
    sign_str = f"{api_path.lower()}{method.lower()}{sort_json_str}{secret}{timestamp}"
    token = hashlib.md5(sign_str.encode('utf-8')).hexdigest()
    return {"X-APP-ID": app_id, "X-TOKEN": token, "X-TIMESTAMP": str(timestamp)}
几个容易踩坑的地方:
- GET请求的签名也要包含query参数,不能遗漏
- data必须按key排序,确保签名一致
- timestamp是Unix时间戳(秒),不是毫秒
四、从0到1搭建Web平台:Flask+前后端分离架构实战
3.1 项目结构设计:4个文件搞定一切
数字人视频生成/
├── config.py          # 配置文件(API凭证、默认参数)
├── nebula_client.py   # API客户端(鉴权、请求封装)
├── web_app.py         # Web后端(Flask服务)
├── index.html         # 前端页面(单文件SPA)
└── tasks.json         # 任务数据(自动生成,JSON持久化)
为什么这样设计?
- 配置与代码分离:config.py独立管理,便于维护,修改配置无需改动代码
- API客户端复用:nebula_client.py可独立使用,方便在其他项目中调用
- 前后端分离:index.html独立,Flask只提供API,前端可自由扩展
- 数据持久化:tasks.json简单可靠,无需数据库,适合小规模使用
3.2 配置文件:config.py
# 应用凭证
APP_ID = "APP_ID"
APP_SECRET = "APP_SECRET"
# API基础URL
HOST = "https://nebula-agent.xingyun3d.com"
# 默认参数配置
DEFAULT_CONFIG = {
    "look_name": "N_Wuliping_12298_new",          # 形象名ID
    "tts_vcn_name": "XMOV_HN_TTS__40",            # 音色ID
    "studio_name": "sstage_single_tech_black_01",  # 演播室ID
    "sub_title": "on",                             # 开启字幕
    "output_resolution": "720P",                   # 视频清晰度
    "if_aigc_mark": True,                          # AI生成标识
}
# 轮询配置
POLL_INTERVAL = 10   # 轮询间隔(秒)
MAX_POLL_TIMES = 120 # 最大轮询次数(约20分钟)
配置项说明:
look_name:数字人形象,可在魔珐星云控制台查看tts_vcn_name:音色ID,支持多种声音选择studio_name:演播室背景,支持自定义output_resolution:可选540P/720P/1080P/2K/4K,按需调整
3.3 API客户端:nebula_client.py
核心功能包括鉴权签名、创建任务和查询状态。先看鉴权签名部分:
class NebulaClient:
    """魔珐星云API客户端"""
    def __init__(self, app_id=None, secret=None, host=None):
        self.app_id = app_id or APP_ID
        self.secret = secret or APP_SECRET
        self.host = host or HOST

    def _generate_token(self, method, api_path, data):
        """生成X-TOKEN签名"""
        timestamp = int(time.time())
        sort_json_str = json.dumps(dict(data), sort_keys=True).replace(' ', '')
        sign_str = f"{api_path.lower()}{method.lower()}{sort_json_str}{self.secret}{timestamp}"
        token = hashlib.md5(sign_str.encode('utf-8')).hexdigest()
        return {"X-APP-ID": self.app_id, "X-TOKEN": token, "X-TIMESTAMP": str(timestamp)}
创建任务和查询状态的接口封装:
    def create_task(self, segment, **kwargs):
        """创建视频生成任务"""
        api_path = "/api/v1/video/create"
        data = {"segment": segment, **kwargs}
        headers = self._generate_token("POST", api_path, data)
        response = requests.post(self.host + api_path, json=data, headers=headers)
        return response.json()

    def query_task(self, task_id):
        """查询任务状态"""
        api_path = f"/api/v1/video/query/{task_id}"
        data = {}
        headers = self._generate_token("GET", api_path, data)
        response = requests.get(self.host + api_path, headers=headers)
        return response.json()
踩坑记录:
- GET请求签名:query参数也要包含在签名中,否则会鉴权失败
- data排序:必须按key排序,确保签名一致,否则MD5对不上
- 时间戳:使用Unix时间戳(秒),不是毫秒,不要搞混
3.4 Web后端:web_app.py
后端主要负责接收前端请求、调用星云API、轮询任务状态,并用JSON文件持久化任务数据。核心代码片段:
from flask import Flask, render_template, request, jsonify
from nebula_client import NebulaClient

app = Flask(__name__, template_folder=os.path.dirname(os.path.abspath(__file__)))
TASKS_FILE = 'tasks.json'

# 任务数据持久化
def load_tasks():
    """从文件加载任务数据"""
    global tasks
    if os.path.exists(TASKS_FILE):
        with open(TASKS_FILE, 'r', encoding='utf-8') as f:
            tasks = json.load(f)

def save_tasks():
    """保存任务数据到文件"""
    with open(TASKS_FILE, 'w', encoding='utf-8') as f:
        json.dump(tasks, f, ensure_ascii=False, indent=2)

@app.route('/api/create_task', methods=['POST'])
def create_task():
    """创建视频生成任务"""
    data = request.json
    segment_text = data.get('segment', '').strip()
    # 纯文本自动转换SSML
    if segment_text and not segment_text.startswith('['):
        paragraphs = [p.strip() for p in segment_text.split('\n\n') if p.strip()]
        segment = [{"text": para, "media_url": ""} for para in paragraphs]
    else:
        segment = json.loads(segment_text)
    # 创建任务
    client = NebulaClient()
    result = client.create_task(segment, **DEFAULT_CONFIG)
    # 保存任务
    task_id = result['data']['task_id']
    tasks[task_id] = {'task_id': task_id, 'status': 'creating', 'created_at': time.time()}
    save_tasks()
    return jsonify({'success': True, 'task_id': task_id})
几个亮点:
- 纯文本转换:用户无需学习JSON格式,直接输入文本,系统自动按双换行符分割段落,转换为SSML结构
- 数据持久化:用JSON文件存储任务数据,简单可靠,重启不丢失
- 模板路径:template_folder指向根目录,index.html直接放在根目录下,省去配置麻烦
3.5 前端页面:index.html
前端采用单页应用设计,核心特性包括:
- 左右分栏布局(CSS Grid)
- 纯文本输入,自动转换SSML(用户只需输入普通文本,后端自动处理)
- 任务列表固定高度+滚动,不挤占页面
- 视频点击展开/收起,节省空间
- 毛玻璃效果+动态背景,视觉上更现代
关键代码:
// 表单提交 - 创建任务
document.getElementById('taskForm').addEventListener('submit', async (e) => {
    e.preventDefault();
    const data = {
        segment: document.getElementById('segment').value,
        video_name: document.getElementById('video_name').value,
        output_resolution: document.getElementById('output_resolution').value,
        sub_title: document.getElementById('sub_title').value,
        if_aigc_mark: document.getElementById('if_aigc_mark').value === 'true'
    };
    const response = await fetch('/api/create_task', {
        method: 'POST',
        headers: { 'Content-Type': 'application/json' },
        body: JSON.stringify(data)
    });
    const result = await response.json();
    if (result.success) {
        showMessage('success', `任务创建成功!任务ID: ${result.task_id}`);
        loadTasks(); // 刷新任务列表
    }
});

// 视频展开/收起 - 节省空间
function toggleVideo(taskId) {
    const videoContainer = document.getElementById(`video-${taskId}`);
    videoContainer.classList.toggle('active');
    const btn = event.target;
    btn.innerHTML = videoContainer.classList.contains('active') ? '


