
接着上半部分的话题,咱们继续把SoccerNet 2026剩下的几个赛题聊完。这次的重点是“Spiideo SoccerNet合成定位”和“视觉问答”这两个赛道,它们各自的技术挑战和解决方案都非常有意思。
Spiideo SoccerNet合成定位
这个赛道有个很长的名字——Spiideo SoccerNet合成定位,简称SSS。它的任务很明确:给定一张足球场上的单张图像,加上相机的校准信息,算法需要把场上每一位球员精准定位到球场坐标系中。具体来说,是根据球员骨盆在地面的投影来进行定位[1]。

评测这个赛道表现的核心指标是mAP-LocSim。这个指标是在经典的mAP基础上,引入了一个叫做LocSim的评判标准,用来判断每个预测是否准确。LocSim的定义是这样的:
简而言之,当预测的球员位置与实际位置之间的欧氏距离d,代入这个公式后,计算出的LocSim值低于0.5时,这个预测才算准确。这里的τ值设定为1米,精度要求相当高。
从提交的方案来看,所有参赛团队都使用了基线模型,比如YOLO26、RF-DETR或YOLOX-Pose。部分团队还额外引入了人体姿态估计模型(如RTMPose-X或ViTPose),专门用来估算球员骨盆位置及其在地面上的投影。原理并不复杂:先检测到图像中的球员,再利用相机校准参数进行坐标转换,就能得到球员在球场平面上的实际位置。
在部分参赛方案中,还出现了一种叫Tiling的技术。简单解释一下,Tiling就是把一张大图切成若干个小图(即Tiles),然后独立处理每一小块。具体到这次比赛,不同团队用了不同的Tiling策略:
- 自适应Tiling:根据粗粒度的人员检测结果,动态调整小图的裁剪范围,确保每个小图都能覆盖到目标球员。
- 非自适应Tiling:这种方式需要后续的NMS(非极大值抑制)等处理,来避免重叠的检测结果,同时还要把分散在不同小图中的检测结果合并起来。
还有一个值得注意的点:很多基座模型的损失函数是在像素级别上计算的,但比赛的评测指标却是基于真实的场上距离。这个不一致性让不少团队动了脑筋。有的改用了基于球场坐标系的Huber损失函数,有的干脆直接去优化LocSim这个指标本身。
视觉问答
视觉问答赛道,也就是VQA,考验的是多模态理解能力。它要求参赛系统根据文本、图像和视频等多种输入,来回答自然语言问题。每个问题都有四个备选答案,其中只有一个正确[1]。
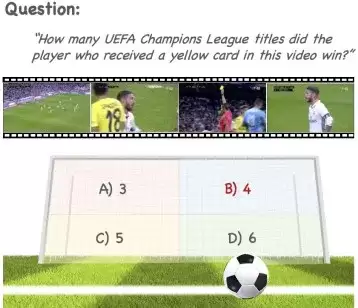
问题类型被分成了14类,覆盖范围很广:针对文本输入的问题,侧重考察背景知识和比赛情况;针对图像输入的,则涵盖摄像机视角、球员识别、球衣号码、记分牌等;而针对视频输入的,则涉及镜头切换、重放检索、动作分类、评论以及多视角犯规识别等。
评测指标相当直接:回答准确率,也就是在500个问题中答对的比例。
在这次比赛中,优胜团队普遍采用了一种叫做“任务路由”的架构[1]。获得第二名的方案是:先推测出提问的分类,然后由任务路由把问题分发给14个Agent之一,每个Agent专门负责回答一类问题。而获得第一名的方案更进一步,它将任务路由分发给以下四个处理模块之一:
- 处理知识和事实的模块;
- 处理图像和视觉任务的模块;
- 将推理进行分解的模块,专门用来处理那些比较含糊的推理任务;
- 针对视频进行时间方面理解的模块。
除此之外,优胜团队还大量采用了其他方法,包括:
- 基于检索的推理;
- 在SoccerAgent及类似工具链的基础上,额外增加了人员检测、人脸匹配、基于姿态的球衣号码裁剪、CLIP风格的检索、球员分割等能力。这些改进主要针对球衣号码识别、球员身份判断、背景知识、重放检索和犯规识别等复杂问题。
参考文献
[1] SoccerNet 2026 Challenges Results
https://arxiv.org/abs/2607.07320
参考文献使用许可协议:CC BY 4.0
https://creativecommons.org/licenses/by/4.0/


