
近日,计算机视觉领域顶级学术会议 CVPR 2026 正式公布论文录用结果。来自群核科技、浙江大学与宇树科技团队的两篇研究论文双双入选,内容分别聚焦于具身智能体的终身学习框架,以及视觉语言模型在空间逻辑推理中的能力评估。作为业界公认的“计算机视觉界奥斯卡”,CVPR 每年汇聚全球最前沿的 AI 研究成果。本届会议共收到有效投稿 16092 篇,最终录用 4090 篇,整体录用率约为 25.42%。
机器人如何实现持续学习?Arcadia 框架构建具身智能闭环
其中,论文《Arcadia: Toward a Full-Lifecycle Framework for Embodied Lifelong Learning》提出了一种名为 Arcadia 的全新框架,旨在为具身智能体打造一个覆盖完整生命周期的学习闭环。简单来说,该框架涵盖了从数据采集、模型训练,到实际部署后的自我进化与知识持续更新的全过程。其核心挑战在于:如何让机器人在不断变化的环境里,像人类一样真正实现“活到老、学到老”的持续适应能力。
在该框架中,群核科技充分发挥了其在空间重建与空间生成技术方面的积累。通过自研的 SpatialLM 大模型,系统能够将机器人采集的多模态传感器数据高效解析为结构化的语义信息;再结合 SpatialGen 的空间生成能力,系统可自动生成大量丰富且多样化的仿真 3D 场景。随后,依托空间智能训练平台 SpatialVerse 进行物理特性模拟与数据集扩增,相当于为机器人搭建了一个海量且物理一致性极高的“训练场”。

实测数据也充分验证了该框架的有效性。在宇树 G1 人形机器人的真实世界零样本测试中,Arcadia 框架表现出色:导航任务成功率达到 46%,操作任务成功率达到 27%。与 NaVILA、OpenVLA 等主流开源方案相比,整体性能提升了约 3 倍,尤其是在多目导航、多物体协同操作等复杂场景下,优势尤为显著。
AI 真的理解空间逻辑吗?SpatiaLQA 构建空间推理“评测标杆”
另一篇论文《SpatiaLQA: A Benchmark for Evaluating Spatial Logical Reasoning in Vision-Language Models》则聚焦于一个更基础的问题:当前的视觉语言模型,是否真正理解“空间”这一概念?
坦白说,当下的视觉语言模型已经相当强大。它们擅长“看懂是什么”——例如物体识别与描述,也能“答对为什么”——比如处理抽象问答与常识推理。然而,一旦面对真实物理空间中的任务,比如遮挡关系判断、相对位置约束、操作顺序推理等问题,其能力短板便会暴露无遗。
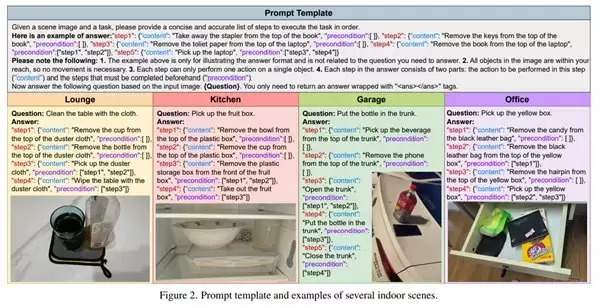
举个例子,如果让机器人执行书架整理任务,它需要准确判断哪些书是承重支撑点、哪些摆件可以独立移动。倘若空间逻辑判断出错,抽出一本书,可能导致整排物品全部倒塌。SpatiaLQA 这一基准测试,不仅提供了一套涵盖多种空间逻辑关系的评测数据集,还系统性地定义了相应的评价指标。
值得注意的是,群核科技在 SpatialLM 空间理解方面的积累,也为 SpatiaLQA 基准的构建提供了关键的技术支撑。
在过去几年中,大模型主要改变了数字世界——文本、图像与视频的生成和理解,几乎已被 AI 全面重塑。但 AI 要真正走进物理世界,其核心能力在于对物理空间的理解与交互。而这,恰恰是当前许多语言模型最欠缺的能力。
行文至此,不难发现此次入选的两篇论文分别触及了两个核心命题:Arcadia 框架致力于解决机器人“如何持续学习以适应真实世界”的难题,而 SpatiaLQA 则回答了“如何衡量 AI 对空间逻辑的理解程度”。两者共同指向一个判断:空间智能,正在成为 AI 从数字世界迈向物理世界的关键跳板。在这一进程中,群核科技所扮演的角色,正是连接数字世界与物理世界的那座桥梁。


