
先说几个核心判断。单节点 Redis 在实际生产环境中会面临四个常见痛点:数据存在丢失风险、存储容量受限、并发处理能力有限、故障后自动恢复能力较弱。针对这些问题,业界已有成熟的解决方案——数据丢失可通过持久化到磁盘来规避,存储不足则搭建分片集群利用插槽机制扩容,并发瓶颈通过主从集群实现读写分离,故障恢复则交由哨兵机制自动处理。下面就从持久化入手,逐一拆解这些技术。
Redis 持久化
RDB 持久化
RDB 全称 Redis 数据备份文件,也叫数据快照。简单来说,就是定时将内存中的所有数据完整地拍一张“快照”保存到磁盘上。一旦 Redis 实例宕机重启,就可以从这张快照中恢复数据。值得一提的是,当你主动关闭 Redis 时,它也会自动执行一次 RDB,相当于一个保底机制。
执行 RDB 有两种方式:
save    # 由主进程直接执行,会阻塞所有命令
bgsave  # 另起子进程执行,主进程不受影响
实际生产环境中当然使用 bgsave,毕竟谁也不希望因为备份就把线上请求卡住。Redis 内部也预设了自动触发规则,在 redis.conf 中可以找到:
# 900 秒内至少 1 个 key 被修改,触发 bgsave
save 900 1
# 300 秒内至少 10 个 key 被修改,触发 bgsave
save 300 10
# 60 秒内至少 10000 个 key 被修改,触发 bgsave
save 60 10000

# 注意:如果设置 save "",就是彻底禁用 RDB,生产环境需谨慎
其他几个常用配置也很值得关注:
# 是否压缩 RDB 文件(默认开启)。压缩会消耗 CPU,如今磁盘成本不高,建议关闭
rdbcompression yes

# RDB 文件名
dbfilename dump.rdb

# 保存目录
dir ./
bgsave 的执行逻辑非常巧妙:先 fork 出一个子进程,该子进程与主进程共享同一份内存数据。子进程负责读取并写入 RDB 文件,主进程继续处理请求。这里用到了写时复制(copy-on-write)技术——主进程只读操作时直接访问共享内存,只有写操作发生时才拷贝一份数据再写入。这种机制在保证数据一致性的同时,将性能影响降到了最低。
RDB 总结
梳理一下 bgsave 的完整流程:
- fork 主进程,获得子进程,共享内存空间
- 子进程读取内存数据,写入新的 RDB 文件
- 用新文件替换旧文件
不过 RDB 也有明显的短板。最突出的问题是两次 RDB 之间的间隔可能长达几分钟,若在此期间宕机,所有写入的数据都会丢失。此外,fork 子进程、压缩、写文件等操作本身也比较耗时。
AOF 持久化
AOF 的思路与 RDB 截然不同。它不拍快照,而是将每一次写命令都记录下来。这就带来一个问题——AOF 文件通常比 RDB 大得多,而且同一个 key 可能被反复修改,但真正有价值的只有最后一次操作。
为此 Redis 提供了 bgrewriteaof 命令进行重写,用最少的命令达到相同效果,从而精简文件体积。
AOF 默认是关闭的,需要在 redis.conf 中手动开启:
appendonly yes           # 开启 AOF
appendfilename "appendonly.aof"  # 文件名
最关键的是刷盘策略,它决定了数据安全程度与性能的取舍:
# 每次写命令都立即写入磁盘
appendfsync always

# 每秒写入一次(默认)
appendfsync everysec

# 交给操作系统决定(通常约 30 秒)
appendfsync no
三种策略的差异非常明显:
| 策略 | 同步时机 | 数据安全 | 性能影响 | 适用场景 |
|---|---|---|---|---|
| always | 每次写命令后 | 最高(零丢失) | 最低 | 金融交易、支付系统 |
| everysec | 每秒一次 | 较高(最多丢 1 秒) | 中等 | 大多数生产环境 |
| no | 由系统决定 | 最低(可能丢 30 秒+) | 最高 | 缓存、非关键数据 |
另外,Redis 也支持 AOF 的自动重写,阈值可配置:
# 比上次文件增长超过 100% 则触发重写
auto-aof-rewrite-percentage 100
# 文件最小体积超过 64MB 才触发
auto-aof-rewrite-min-size 64mb
AOF 和 RDB 对比
两种方案各有优劣,如果对数据安全性要求很高,实际开发中通常会两者结合使用:
| 对比维度 | RDB | AOF |
|---|---|---|
| 持久化方式 | 定时对整个内存做快照 | 记录每一次执行的命令 |
| 数据完整性 | 不完整,两次备份之间会丢失 | 相对完整,取决于刷盘策略 |
| 文件大小 | 有压缩,体积小 | 体积很大 |
| 宕机恢复速度 | 很快 | 慢 |
| 数据恢复优先级 | 低 | 高 |
| 系统资源占用 | 高(fork 子进程) | 低(主要是磁盘 IO,但重写时也高) |
| 使用场景 | 可容忍数分钟丢失,追求启动速度 | 对数据安全性要求高 |
Redis 主从
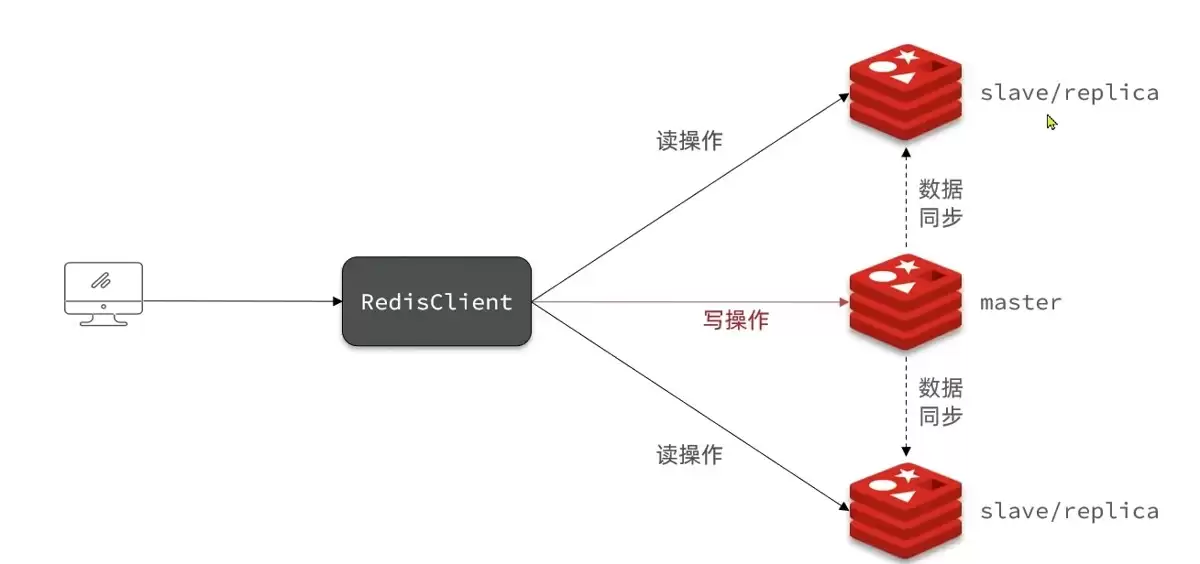
单节点的并发能力存在上限,要突破这个瓶颈就需要搭建主从集群,实现读写分离。
具体搭建方式此处不再展开。
数据同步原理
主从同步的核心在于 master 判断 slave 是否是第一次来同步。这里有两个关键概念:
- Replication Id(replid):数据集的标识。每个 master 都有唯一的 replid,slave 会继承 master 的 replid。如果两个节点的 replid 一致,说明它们属于同一个数据集。
- offset:偏移量。随着 repl_baklog 中的数据增多而变大。slave 同步时会记录自己的 offset,如果 slave 的 offset 小于 master 的 offset,说明 slave 的数据落后了,需要补上。
因此 slave 做数据同步时,必须向 master 声明自己的 replid 和 offset,这样 master 才能判断应该同步哪些数据。
一、全量同步(第一次同步)
结合两个核心概念后,流程更清晰:

全量同步的完整流程:
- slave 请求增量同步
- master 对比 replid,发现不一致,拒绝增量同步
- master 生成完整 RDB,发送给 slave
- slave 清空本地数据,加载 RDB
- master 将 RDB 生成期间收到的命令记录到 repl_baklog,并持续发给 slave
- slave 执行这些命令,与 master 保持一致
二、增量同步(slave 重启后)

但 repl_baklog 有大小限制,写满后会覆盖旧数据。如果 slave 断开太久,导致未同步的数据被覆盖,那就只能再触发一次全量同步了。
优化主从集群的几个建议:
- 在 master 中配置
repl-diskless-sync yes,启用无磁盘复制,避免全量同步时的磁盘 IO 瓶颈 - 单节点内存不要太大,否则 RDB 生成的磁盘 IO 会非常重
- 适当增大 repl_baklog 的大小,slave 宕机后争取尽快恢复,避免触发全量同步
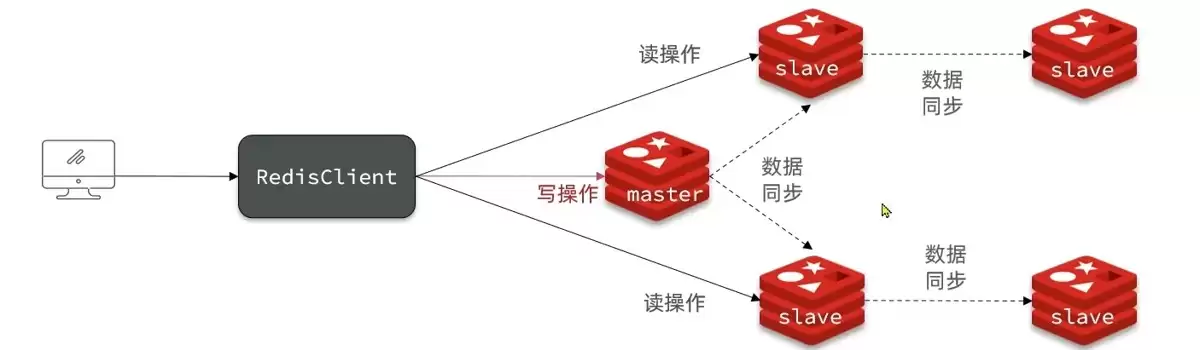
- 控制每个 master 的 slave 数量。如果实在太多,可以采用主-从-从链式结构来分担 master 压力
Redis 主从总结
全量同步和增量同步的本质区别:
- 全量同步:master 将完整内存数据生成 RDB 发给 slave,后续命令记录到 repl_baklog 并持续发送
- 增量同步:slave 提交自己的 offset,master 从 repl_baklog 中取出 offset 之后的命令发给 slave
总结
以上就是关于 Redis 持久化和主从集群的核心内容。从单节点的问题出发,我们看到了 RDB 和 AOF 这两种持久化方案各自的优缺点和适用场景,也了解了主从集群如何通过全量同步和增量同步来保证数据一致性。实际部署时,结合业务对数据完整性的要求和性能预算来做取舍,才是最合理的方式。


