
来源:环球网
摘 要:面对万亿级大模型训练与推理中日益凸显的通信墙与算力利用率难题,紫光股份旗下新华三集团推出H3C UniPoD S80000超节点产品,基于“算力×联接”技术理念,通过Scale-up架构实现GPU全互联,卡间带宽较传统8卡服务器提升8倍,单卡推理效率提升80%。该方案不仅支持液冷高密部署与多品牌GPU兼容,还针对大模型训练的长稳性需求,进行了软硬件协同调优。目前,该超节点已在多个大型智算项目中落地,并正向1024卡以上超大规模全互联演进,为AI大模型时代提供高性能、高可靠、高能效的算力底座。
关键词:新华三;超节点;AI基础设施;大模型;
案例正文:
2025年,大模型走向“技术摸高”与“工程创新”并行的新阶段,以DeepSeek为代表的高参数量MoE大模型逐渐成为业内主流。随之而来的,是市场对高性能算力需求的爆发式增长。这意味着,谁能够在大模型训推效率上跑赢对手,谁就有可能在瞬息万变的AI时代抢得市场先机。因此,如何搭建更优、更稳、更强劲的AI算力基础设施变得尤为重要,在此背景下,算力更强、通信更快、效率更高的超节点产品,成为当前算力领域最受关注的技术热点。
以网强算,超节点技术带来的大模型训推效率跃升
在经历百模大战后的商用落地阶段,各大模型厂商在实现技术落地之外的首要考量便是每Token成本。虽然目前单台服务器内已经可以基于OAM标准实现最高8卡GPU的直接互联,但更大规模的算力需求下还是要依靠跨节点的Scale-out方式进行集群组网,在动辄百卡、千卡级的大模型训推需求下,巨大的通信开销会造成算力利用率的大幅下降,大量GPU的等待和空转使得传统组网在整体训推效率表现上显得越发吃力。因此,依靠Scale-up技术实现GPU多卡全互联的超节点产品,成为破局智算效率瓶颈的最优解。
在万亿级参数量成为常态的当下,大模型训练阶段数据的传输量和传输频率激增,同时,张量并行、专家并行等训练模式以及超长序列多模态等技术场景也对GPU之间的带宽和时延提出了极高要求。基于Scale-up的节点内互联能够实现每个GPU之间的直接高速通信,相比跨节点的通信提高数倍带宽,从而大幅提升GPU利用效率,减少GPU空闲;同时,超高带宽、超低时延的互联网络,能够有效打破通信墙,大幅缩减以传统多机多卡方式布局训练的通信开销,真正实现以网强算。
另一方面,在大模型推理阶段,为了提升GPU使用效率,PD分离(Prefill-Decode分离)技术被广泛应用。然而,由于大模型逐token生成的特性,在推理Decode阶段,需要频繁访问KV Cache,对显存容量和带宽要求极高。而超节点支持计算与存储资源独立扩展,为Prefill配置高算力节点,为Decode配置大内存节点,避免资源浪费,同时其多卡部署、卡间高速直联的特性,能够大幅度降低推理的时延,确保KV Cache快速同步,天然适配PD分离场景。
兼顾性能与稳定,新华三超节点为AI提供强劲可靠的算力效能
基于在ICT领域的深厚积淀,紫光股份旗下新华三集团以“算力×联接”理念为技术依托,于近期推出了H3C UniPoD S80000超节点产品。作为面向万亿级参数模型训推场景的超节点产品,H3C UniPoD S80000以算力芯片多元化、互联协议标准化、基础设施集成化为核心设计理念,实现了更高性能、更高密度、更高效率的三重进化。柜内卡间全互联通信,相比传统8卡服务器组网,卡间互联带宽提升8倍,单卡推理效率提升80%。同时,H3C UniPoD S80000采用液冷高密部署,单柜可支持64卡超节点部署,并兼容下一代高性能AI加速卡。
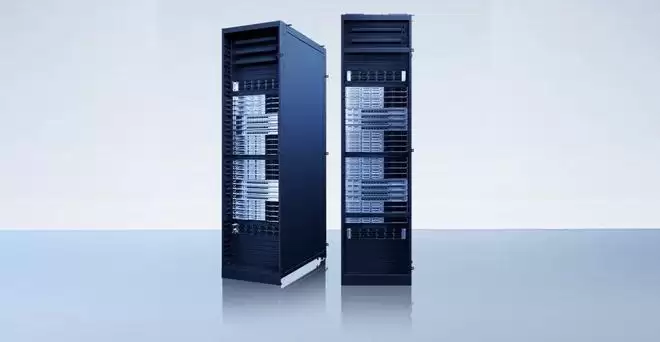
在确保大模型训推效率的基础上,新华三超节点还深度考量了产品的稳定性和可维护性,在大模型训练进程中,任何一次中断都可能导致训练进度丢失、资源浪费甚至模型性能退化,因此,AI基础设施不仅要考虑训练性能的提升,更要确保训练连续性,避免时间与金钱的双重损耗。
对此,除了通过软硬件的协同调优来保障产品上线后的长稳训练不中断,硬件本身的稳定可靠至关重要。目前,在数百卡以上的超节点规模下,通常需要引入电+光的二层网络架构,新华三也在积极投入节点级的光互联技术研发和测试,在充分利用光技术带来的高速率、低延迟和低能耗优势的同时,尽可能降低光学器件一直以来的高故障率,为客户提供真正具备稳定性、可靠性的商用产品,保障大模型训练的长稳续航。
目前,新华三超节点产品已完成在多个大型项目的集群化部署,支持多款国内外主流GPU的兼容适配,并持续开展与上下游生态伙伴的软硬件协同开发和调优工作,积极布局1024卡及以上更大规模超节点产品的研发和落地,持续提升智算集群规模和效率。
AI技术持续进化,多元算力百花齐放,AI产业的繁荣依托基础设施的稳固与强劲。面向崭新的AI时代,新华三方面表示,将以超节点技术为全新路标,持续深化“算力×联接”技术理念,全面拥抱产业变革,不断构建性能强劲、多元开放、持续进化的算力基础设施,以技术聚合之力,加速百行百业智慧跃迁。
案例点评:
在大模型参数量激增、工程化挑战加剧的背景下,单纯堆砌算力已难以为继,系统级协同创新成为破局关键。新华三超节点以“以网强算”为核心思路,将高速互联从跨节点通信下沉至节点内全互联,有效打破通信瓶颈,显著提升GPU利用效率,体现了从“算力堆叠”向“算力质效”转型的战略前瞻性。尤为可贵的是,其在追求极致性能的同时,高度重视稳定性与可维护性,通过光互联技术预研与长稳训练保障机制,回应了产业对AI基础设施“既快又稳”的双重期待。这一实践不仅为国产智算基础设施树立了技术标杆,也为构建自主可控、高效绿色的大模型生态提供了坚实支撑。
——环球趋势案例征集组委会


