
临时表的诞生:为什么会有内存与磁盘之分
在 MySQL 执行复杂查询时,优化器常需要借助临时表来保存中间结果,例如处理 GROUP BY、ORDER BY、DISTINCT 或 UNION 等操作。需要明确的是,本文讨论的是 MySQL 内部自动创建的临时表,而非用户通过 CREATE TEMPORARY TABLE 显式声明的会话级临时表。内部临时表的工作流程是:查询执行过程中,当内存无法直接完成排序或去重时,引擎会动态分配一块空间作为临时表。初始阶段,MySQL 会优先尝试将其存放在内存中,以获得极高的读写速度。然而,一旦临时表的数据量超过系统设定的阈值,或者包含 TEXT、BLOB 等内存引擎不支持的数据类型,MySQL 便会自动将其落盘至磁盘。内存与磁盘存储的核心差异在于访问延迟与容量上限:内存临时表响应极快但受限于可用 RAM,磁盘临时表则依赖 I/O 吞吐,虽能容纳海量数据,但会显著拖慢查询性能。
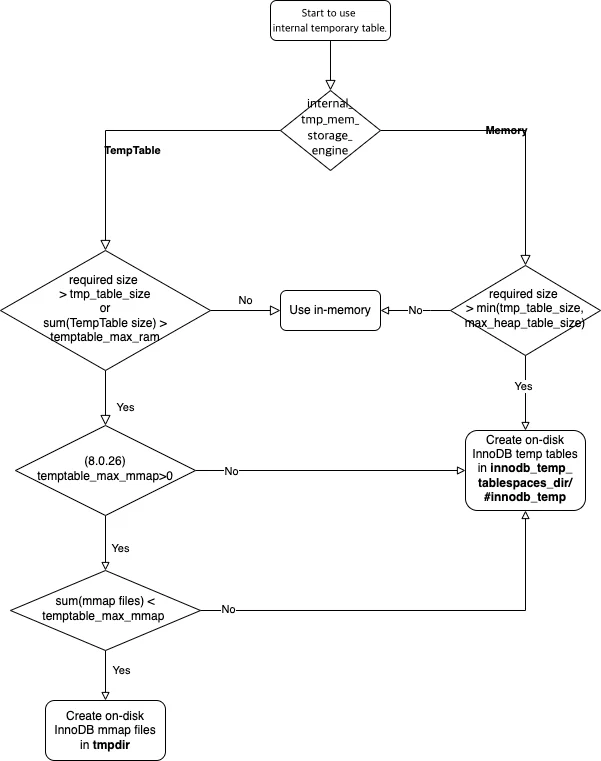
底层差异:存储引擎、触发条件与配置边界
内存临时表与磁盘临时表在底层存储引擎与触发机制上存在本质区别。内存临时表默认采用 MEMORY 存储引擎,数据完全驻留于 RAM 中,读写无需经过磁盘 I/O,但受限于 max_heap_table_size 与 tmp_table_size 两个参数中的较小值。磁盘临时表在 MySQL 5.7 及之后版本默认使用 InnoDB 引擎,具备事务与崩溃恢复能力,但读写需经过文件系统与缓冲池。触发落盘的典型条件包括:一是临时表体积超过上述内存阈值;二是查询涉及 TEXT、BLOB 或超长 VARCHAR 字段,因为 MEMORY 引擎不支持这些类型;三是 SQL 语句包含复杂的 GROUP BY 与 ORDER BY 组合、UNION ALL 或子查询嵌套。例如,当执行 SELECT col1, col2 FROM t GROUP BY col1 ORDER BY col2 时,若排序字段与分组字段不一致,MySQL 无法利用索引完成排序,必须创建临时表。若此时结果集较大,便会迅速突破内存限制转为磁盘表。合理配置这两个参数是平衡性能与内存占用的关键,但需注意它们仅对内存临时表生效。
验证方法:如何判断查询产生了内存临时表还是磁盘临时表
要准确判断查询是否使用了临时表以及是否发生落盘,可结合执行计划与状态指标进行验证。首先,使用 EXPLAIN 分析 SQL,若 Extra 列出现 Using temporary,则表明优化器决定使用临时表。在 MySQL 8.0 及以上版本,推荐使用 EXPLAIN ANALYZE,它能返回实际执行耗时与临时表构建的详细步骤。其次,通过状态变量进行量化验证:执行查询前运行 FLUSH STATUS;,查询后执行 SHOW SESSION STATUS LIKE 'Created_tmp%';。若 Created_tmp_tables 增加 1 且 Created_tmp_disk_tables 未增加,说明仅使用了内存临时表;若两者同时增加,则已发生落盘。可复现的测试思路如下:创建一张包含十万行数据的测试表,分别执行 SELECT id, name FROM test_table ORDER BY name;(无索引时易触发内存临时表)与 SELECT id, content FROM test_table GROUP BY content;(content 为 TEXT 类型)。对比两次查询的状态指标变化,即可直观观察到内存与磁盘临时表的生成差异,从而为后续优化提供数据支撑。
性能优化与避坑:减少临时表落盘的实用方法
减少临时表落盘的核心在于从 SQL 逻辑与索引设计源头降低中间结果集规模。首先,优化 SQL 写法:避免在 GROUP BY 与 ORDER BY 中使用不同列,尽量让排序与分组字段一致或走相同索引;使用 UNION ALL 替代 UNION 以跳过去重步骤;严格限制 SELECT 字段,避免返回 TEXT 或 BLOB 类型。其次,完善索引覆盖:为高频排序与分组字段建立联合索引,使 MySQL 能通过索引顺序直接返回结果,彻底跳过临时表构建。在参数调优方面,可适当调大 tmp_table_size 与 max_heap_table_size,但切忌盲目翻倍。内存参数属于全局或会话级限制,若单条查询占用过大,极易引发内存碎片甚至 OOM,进而拖垮整个实例。正确的做法是结合慢查询日志定位具体 SQL,针对单次查询优化执行路径,而非依赖全局参数掩盖设计缺陷。同时,需区分单次查询优化与全局资源风险:临时表落盘虽影响性能,但在高并发场景下,过度依赖内存反而会导致 Swap 频繁,合理接受部分落盘并配合 SSD 存储,往往是更稳健的架构选择。


