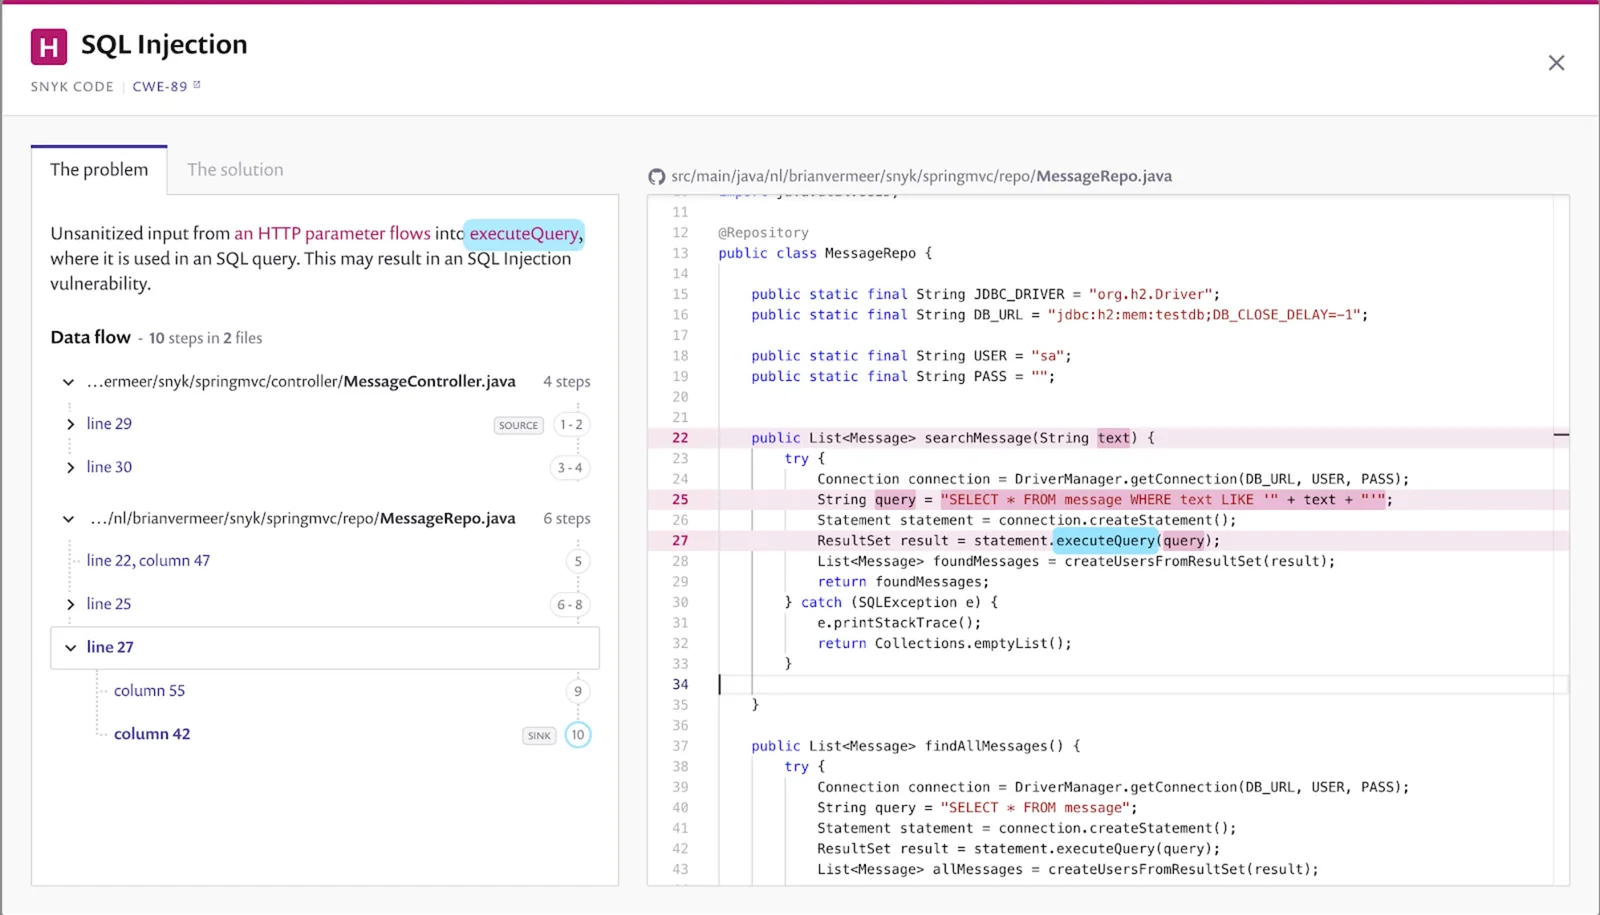
SQL注入的本质:代码与数据的混淆
SQL注入并非某种高深的攻击技巧,而是应用程序将不可信的用户输入直接拼接到SQL语句中,导致输入内容逃逸出原有的数据上下文,被数据库引擎误认为可执行的SQL代码。其核心漏洞在于“代码与数据未分离”。例如,在登录验证中,若后端采用字符串拼接方式构建查询,攻击者通过输入特定字符闭合引号并注入永真条件,即可绕过身份验证。此类危险编码模式广泛存在于动态查询、模糊搜索及分页排序逻辑中。预编译参数化查询的防护思路正是切断这种语义篡改路径:数据库在解析阶段先将SQL结构固定为执行计划,随后将用户输入严格作为纯文本参数传入,无论输入包含何种特殊字符,都不会改变原始SQL的语法树,从而从根本上消除注入风险。
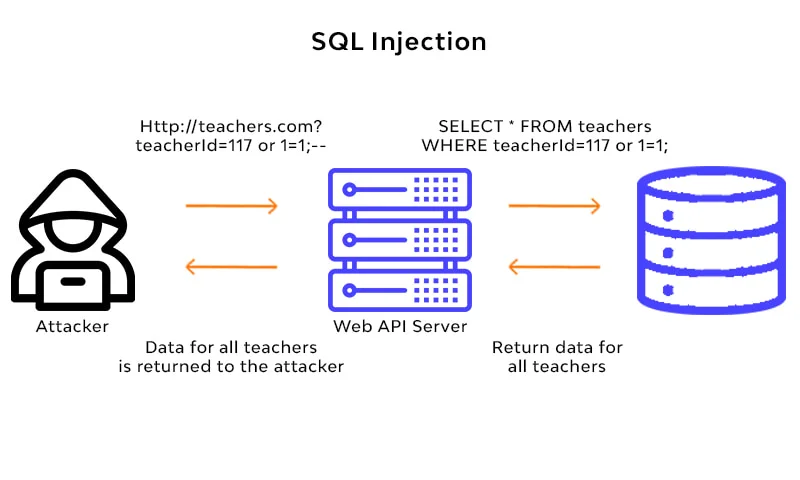
预编译与参数化查询:结构与数据的分离
预编译语句(Prepared Statement)的工作机制分为两个明确阶段:首先,数据库接收包含占位符(如?或:name)的SQL模板,完成词法分析、语法检查并生成执行计划缓存;其次,应用程序将实际参数值单独发送至数据库引擎,由驱动层负责类型转换与安全绑定。这种“结构与数据分离”的设计确保了参数永远被视为字面量而非指令。在实际开发中,必须杜绝任何形式的字符串拼接。以Java为例,错误写法为Statement.executeQuery("SELECT id FROM t WHERE name='" + name + "'"),正确做法是使用PreparedStatement pstmt = conn.prepareStatement("SELECT id FROM t WHERE name = ?"); pstmt.setString(1, name);。Python的psycopg2或Node.js的pg库同样要求使用参数数组或字典传参。开发者需养成“先写带占位符的SQL,后绑定变量”的编码习惯,并严格校验参数类型与长度,避免隐式转换带来的边界绕过。
ORM安全:从查询API到动态条件
许多开发者误以为使用ORM(对象关系映射)框架即可天然免疫SQL注入,实则ORM仅在封装的查询构建器(Query Builder)中默认启用了参数化。一旦调用原生SQL接口或处理动态条件,风险依然存在。例如,在Django中直接使用Model.objects.raw("SELECT * FROM users WHERE role = '%s'" % role),或在SQLAlchemy中使用text()拼接字符串,均会破坏参数化机制。更隐蔽的陷阱在于动态排序与字段名:ORM通常不对ORDER BY后的列名进行参数化,若直接接收前端传入的sort_field并拼入查询,极易引发注入。安全实践要求:第一,优先使用ORM提供的链式API而非原生SQL;第二,对必须使用的动态标识符(表名、列名、排序方向)实施白名单校验;第三,批量操作时确保所有条件均通过框架的__in或参数数组传入,避免手动拼接IN (...)子句。
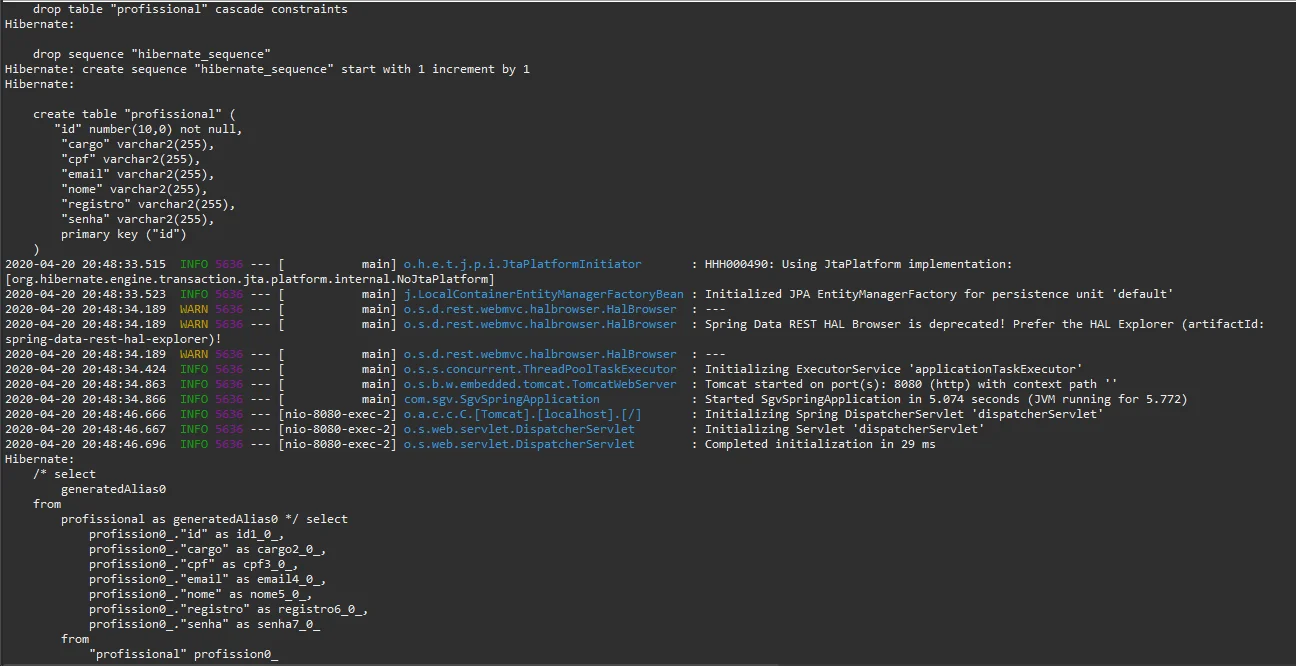
验证防护效果与常见避坑指南
验证SQL注入防护不能仅依赖开发直觉,必须建立可落地的验证闭环。代码审计阶段应使用SAST工具扫描所有数据库交互点,重点排查字符串拼接、动态SQL生成及ORM原生查询调用。测试环节需构造典型注入载荷(如' OR 1=1--、UNION SELECT NULL--)输入至所有用户可控参数,观察应用是否返回异常数据或报错。同时,开启数据库慢查询日志与驱动层调试日志,确认实际执行的SQL是否已替换为占位符形式。常见误区包括:过度依赖addslashes或正则转义替代参数化(转义规则易被绕过且性能差);盲目信任ORM而忽略动态条件拼接;在存储过程或触发器中继续使用拼接逻辑。改进方式应坚持“默认参数化、动态标识白名单化、输入最小权限化”原则,并结合CI/CD流水线集成自动化安全扫描,确保防护策略在迭代中持续生效。