
游乐游手机版
首页/编程语言/文章详情

Linux文本处理:awk与sed常用命令

时间:2026-10-09 14:49
掌握awk与sed的核心语法、常用文本处理场景及组合使用方法,并通过实际命令完成文本筛选、列处理、替换和批量修改,同时注意正则、引号、原文件修改等常见问题。

理解awk与sed的定位和基本语法

awk与sed是Linux文本处理的两大基石,但定位截然不同。awk擅长结构化数据的按行按列分析与统计,其基本语法为awk '模式 {动作}' 文件,默认以空白字符为分隔符将每行拆分为字段,逐行读取并执行动作块。sed则是流编辑器,定位为文本的流式筛选、替换与行级编辑,语法为sed '地址命令' 文件,它按行读入模式空间,匹配地址后执行替换、删除或打印,处理完即输出并清空空间。两者均采用标准输入或文件输入,执行逻辑均为逐行扫描。例如,awk '{print $1}' data.txt直接提取首列,而sed -n '2p' data.txt仅打印第二行。理解这种列分析与流编辑的差异,是高效组合使用的前提。
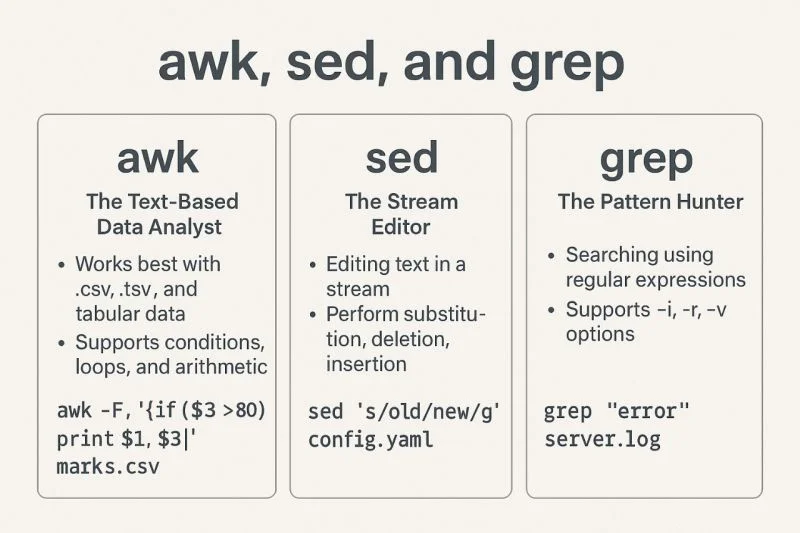
展示Linux终端中awk与sed处理文本的基本流程,并直观区分awk的字段处理与sed的文本编辑能力。
通过对比图直观展示awk面向字段和数据分析、sed面向流式文本编辑的定位差异。

用awk完成筛选、列提取与统计

awk的核心优势在于字段操作与内置变量。通过$1、$2可直接引用列,NF记录当前行字段总数,NR记录当前行号。结合条件判断可实现精准筛选,如awk 'NR>1 && $3>50 {print $1, $2}' data.csv跳过表头并提取第三列大于50的前两列。格式化输出推荐使用printf,例如awk '{printf "%-10s %5.2f\n", $1, $2}'可对齐文本与浮点数。统计场景下,利用累加器与END块极为高效:awk '{sum+=$3} END {print "总和:", sum, "平均:", sum/NR}' file.txt。这些操作无需编写复杂脚本,单行命令即可完成数据清洗、列提取与基础统计,是运维与数据分析的利器。

用sed完成查找、替换与行编辑

sed的强项在于非交互式文本编辑,其核心是s/旧/新/标志替换命令。默认仅替换每行首个匹配项,添加g标志可实现全局替换,如sed 's/foo/bar/g' file.txt。通过指定行号或正则地址可精准控制范围,例如sed '3,5d'删除第3至5行,sed -n '/error/p'仅打印含error的行。正则表达式在sed中需遵循基础正则规范,特殊字符如.、*需转义或使用\(、\)分组。原地修改务必使用-i参数,但强烈建议配合备份后缀如sed -i.bak 's/old/new/g' file,以防误操作覆盖原文件。掌握地址寻址与替换标志,即可高效完成批量配置调整与文本清洗。
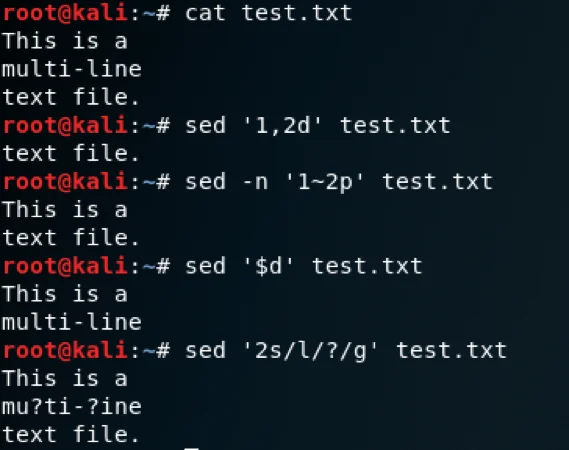
展示真实Linux终端或脚本中使用sed执行文本替换、删除指定行和原地修改文件的过程与结果。
Kali Linux终端演示sed按行删除、打印以及替换文本,体现常见行编辑操作。

组合awk与sed处理实际文本任务

实际工作中,awk与sed常通过管道组合,形成清洗、筛选、统计的完整流水线。以处理Nginx访问日志为例,原始日志含方括号时间戳与多余空格,可先用sed清理:sed 's/\[//g; s/\]//g' access.log去除括号。随后管道传递给awk提取IP与状态码:awk '{print $1, $9}'。若需统计高频IP,可继续组合sort | uniq -c | sort -nr。完整命令为:cat access.log | sed 's/\[//g; s/\]//g' | awk '{print $1, $9}' | sort | uniq -c | sort -nr | head -10。sed负责预处理非结构化干扰字符,awk专注列提取与字段重组,两者互补避免了单一工具的语法臃肿,大幅提升复杂日志或配置文件的处理效率。
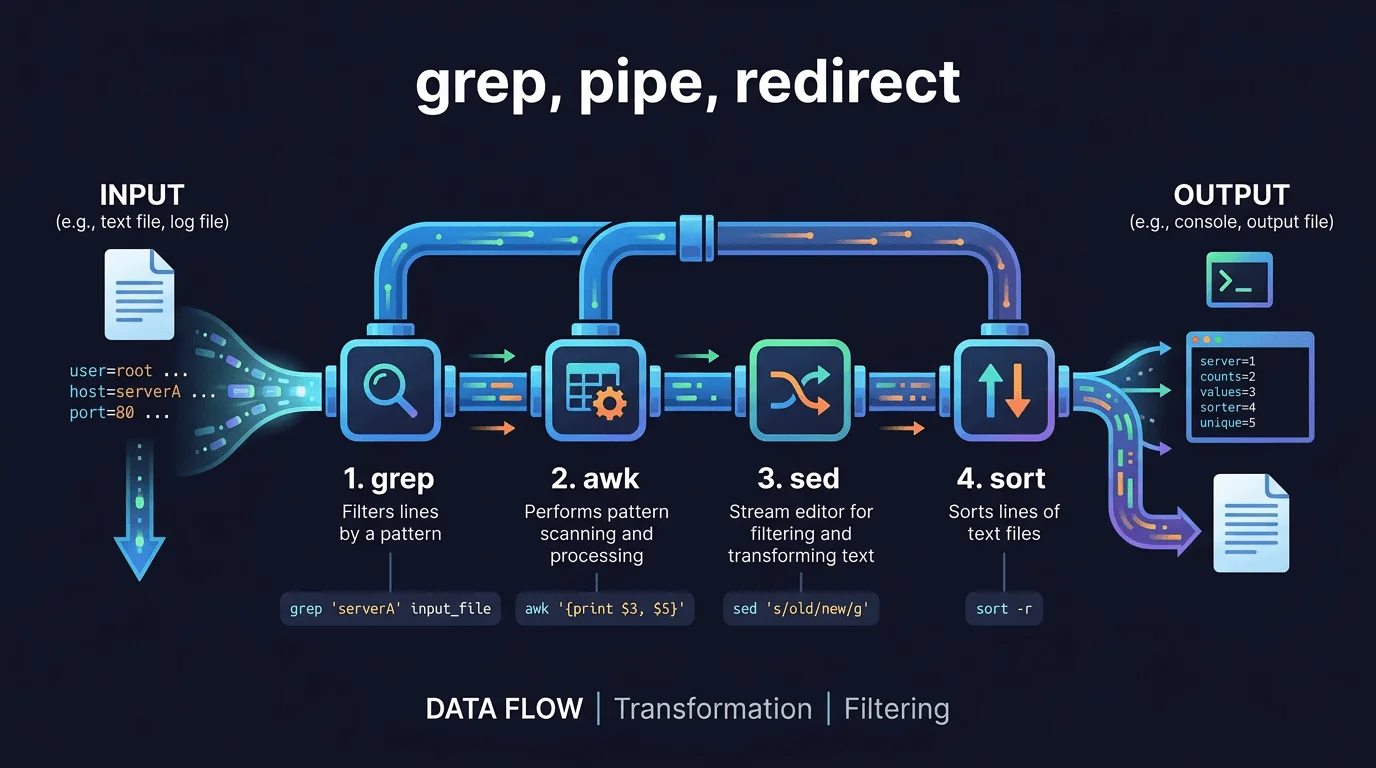
展示Linux命令管道中sed预处理文本、awk筛选和统计数据的实际终端操作流程。
流程图展示Linux文本处理管道中awk与sed串联,对输入数据进行字段提取和文本替换。

验证结果与常见避坑

执行文本处理后,验证与避坑是保障数据安全的关键。输出验证可使用diff对比修改前后文件,或通过head、wc -l核对行数与内容。常见陷阱包括:awk默认分隔符为空格或制表符,处理CSV需显式指定-F',';sed正则中/若作为匹配内容需转义为\/或改用|作为分隔符(如s|old|new|g)。引号使用需严格区分:单引号阻止Shell变量展开,双引号允许变量替换,涉及复杂正则时务必用单引号包裹sed或awk表达式。最危险的误操作是滥用sed -i,务必养成先无-i预览、确认无误后再加-i或-i.bak的习惯,必要时结合cp手动备份,确保生产环境文本修改可追溯、可回滚。

展示终端中执行awk、sed命令后的验证结果,并突出备份文件、检查差异和避免误修改的操作。
终端中的diff结果展示两个文本文件的新增、删除和修改内容,适合用于验证sed或awk处理后的文件差异。
来源:workshop:16d380bf34f24d7fb091113b61a4072e:site:2
上一篇云安全实战:IAM 权限管理的核心原则与落地指南 下一篇Linux 安全审计实战:auditd 规则配置与日志排查指南
本站内容用于信息整理与展示,如有侵权或内容问题请及时联系处理。

相关推荐

补充同频道和同主题内容,方便继续浏览更多相关内容。

同类最新

继续查看同栏目最近更新的文章。

更多
用 pytest-benchmark 建立可复现的性能基线:从对比到回归
编程语言 · 2026-10-09

用 pytest-benchmark 建立可复现的性能基线:从对比到回归

本文介绍如何利用 pytest-benchmark 为 Python 代码建立可重复的性能基准,通过基准测试、对比分析和结果验证定位性能差异,同时避免测试环境、数据规模和统计方式带来的误判。

Python数据清洗:缺失值处理与异常值检测
编程语言 · 2026-10-09

Python数据清洗:缺失值处理与异常值检测

系统掌握使用Python与Pandas进行数据清洗的方法,从识别缺失值、选择合理的填补或删除策略,到检测异常值并验证清洗效果,避免因盲目处理导致数据偏差。

SQLAlchemy 事务避坑指南:Session 生命周期与异常处理
编程语言 · 2026-10-09

SQLAlchemy 事务避坑指南:Session 生命周期与异常处理

在 SQLAlchemy 开发中,Session 不仅是对象状态的跟踪器,更是数据库事务的边界载体。许多数据不一致问题源于对 Session 生命周期、事务提交机制及异常回滚的误解。本文从 Session 的工作单元本质出发,解析 flush 与 commit 的行为差异,探讨并发场景下的请求级 S

Redis 与 Memcached 选型指南:从架构差异到生产实践
编程语言 · 2026-10-09

Redis 与 Memcached 选型指南:从架构差异到生产实践

本文不单纯比较 QPS 峰值,而是从架构原理出发,解析 Redis 与 Memcached 在数据模型、内存管理与并发处理上的本质差异。通过统一环境的基准测试与真实业务场景分析,揭示在 Session 存储、复杂数据结构及高并发读写下的性能表现与瓶颈。文章最后提供针对缓存穿透、雪崩及大 Key 问题

Linux服务器初始化:防火墙与SELinux策略配置
编程语言 · 2026-10-09

Linux服务器初始化:防火墙与SELinux策略配置

从服务器初始化安全基线出发,系统梳理防火墙规则与SELinux策略的配置、验证、联动排障及常见避坑方法,帮助在保证服务可用的同时建立合理的访问控制边界。