
微软研究院近期开源了一套很有意思的 AI 网页自动化框架,名为 Webwright。简单来说,它可以让 AI 模型直接在终端中编写 Playwright 代码、执行 bash 命令、查看运行日志,并依据执行结果持续迭代修正。它不同于常见那种“截图或分析 DOM→预测下一步操作”的传统方案,而是让模型像程序员一样,一边写代码一边调试网页任务。
从整体架构来看,这个框架主要由三个核心部分组成:Runner、Model Endpoint 和终端环境。比较值得关注的是,整个实现相当轻量——Runner 大约 150 行代码,模型接口约 550 行,环境部分约 300 行,总计也只有 1000 行左右。它没有复杂的多智能体编排设计,也没有分层规划模块。对于工程落地来说,这种简洁架构往往意味着更高的稳定性与可靠性。
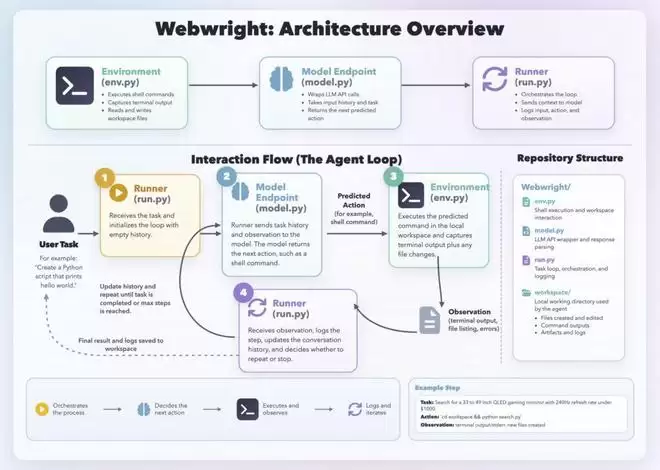
它的执行流程大致如下:Runner 先将当前上下文发送给模型,模型返回自己的思考结果,并附带一条 shell 命令;终端环境执行该命令后,再把终端输出、日志、截图,甚至错误栈信息一并返回给模型,随后进入下一轮迭代。相比一次只预测一个底层操作的方式,这种“直接写 Playwright 代码”的方法显然更适合处理复杂的多步骤网页自动化任务。例如完整填写表单、选择日期、跨页面重复执行操作等,用代码表达会更加清晰,也能更方便地利用循环、函数和抽象复用能力。
研发团队重点解决了两个工程实践中非常棘手的问题。第一个是“过早宣告完成”——模型有时会在任务尚未真正结束时就误判为成功。为了解决这个问题,Webwright 增加了一个门控步骤:模型必须先进行自检,生成相应配置,然后在一个全新的文件夹中运行最终脚本,再结合日志和截图进行自我反思,确认任务成功或失败后,才能输出完成标记。这有点像考试做完后还要认真检查一遍,而不是刚写完就立刻交卷。
第二个问题是上下文膨胀。对于长轨迹任务来说,如果持续累积历史信息,很容易触发上下文长度限制。因此,系统每 20 步就会将历史内容压缩为一份摘要,相当于定期清理缓存,确保模型不会在过多历史细节中迷失方向,从而提升长流程任务的执行稳定性。
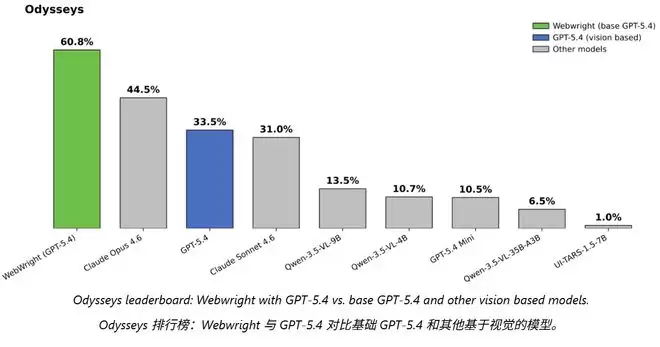
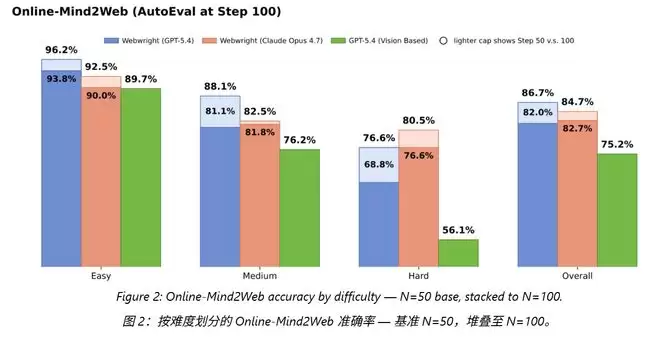
从基准测试结果来看,Webwright 的表现也相当亮眼。在 Online-Mind2Web 和 Odysseys 这两个网页任务数据集上,Webwright 都展现出了很强的性能。前者包含 300 个任务,覆盖 136 个常用网站;基于 GPT-5.4 的 Webwright 整体准确率达到 86.67%,在 100 步预算条件下位列公开 harness 配方中的前列。


参考


