
说到缓存,相信大家都不陌生。无论是前端开发还是服务端开发,缓存都是提升系统性能、降低响应延迟的常见优化手段之一。在真实的生产环境中,缓存设计与使用规范也一直非常关键。如果使用不当,就很容易出现缓存穿透、缓存击穿、缓存雪崩等严重问题,进而给系统稳定性和数据库带来难以预估的风险。
为了尽量避免因缓存策略不合理而造成的损失,我们有必要搞清楚这些缓存异常的产生原因、典型表现以及对应的解决方案,从而提前制定更稳妥的预防措施。
缓存穿透
所谓缓存穿透,是指请求的数据在缓存中不存在,在数据库中也不存在。这样一来,每次请求都会直接落到数据库查询,而不会命中缓存。如果同一时刻有大量类似请求涌入,就会给数据库带来巨大的查询压力,严重时甚至可能把 db 系统直接拖垮。
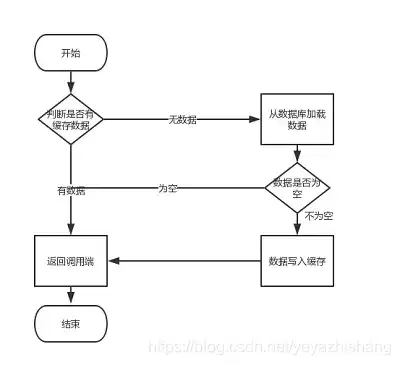
举个例子,比如查询 id 为 -1 的商品,这种 id 在商品表里通常肯定不存在。如果系统没有做特殊处理,攻击者就很容易利用这类无效参数持续发起请求,最终导致系统崩溃。那么,应该如何避免缓存穿透的发生呢?
一般来说,解决缓存穿透的常见方案主要有两种:
一、缓存空对象
当缓存和数据库都查不到对应 key 的数据时,可以把返回的空对象写入缓存。这样下次再请求这个 key 时,系统就可以直接从缓存中返回空结果,而不必继续访问 db。当然,为了避免缓存中过多无效空值,占用大量内存空间,通常会给空对象设置较短的过期时间,例如给 key 设置 30 秒过期:
redisTemplate.opsForValue().set(key, null, 30, TimeUnit.SECONDS);这种做法虽然简单直接,但也存在两个明显问题:
- 如果发生大量 key 穿透,缓存空对象会持续占用宝贵的内存资源。
- 空对象 key 设置了过期时间,在这段时间内数据库里可能恰好新增了该 key 对应的数据,从而带来短时间的数据不一致问题。
在这种场景下,我们还可以考虑一种更常见也更高效的方案,也就是布隆过滤器。
二、Bloom Filter
布隆过滤器(Bloom Filter)由 Bloom 在 1970 年提出,是一种由超长二进制向量和多组随机映射函数组成的概率型数据结构。它最大的特点是空间利用率高,特别适合用于判断某个元素是否存在于集合中,因此在防止缓存穿透、去重过滤等场景中非常实用。
设计思想
布隆过滤器本质上由一个长度为 m 比特的位数组(bit array)和 k 个哈希函数(hash function)组成。当一个元素被加入集合时,会通过 K 个哈希函数把这个元素映射到位数组中的 K 个位置,并将这些位置置为 1。查询某个元素时,只需要检查这些映射位置是否都为 1,就可以大致判断该元素是否存在。也就是说,如果这些位置中有任何一个为 0,那么该元素一定不存在;如果全部都为 1,那么该元素大概率存在。
至于为什么“全部为 1”时只是“可能存在”,原因就在于不同元素经过哈希计算后,可能出现相同的映射位置,也就是哈希冲突。这就会导致某些实际上不存在的元素,对应的比特位恰好也都是 1,从而出现误判。
举个例子:下图是一个布隆过滤器,共有 18 个比特位,3 个哈希函数。当查询某个元素 w 时,经过三个哈希函数计算后,发现其中有一个比特位的值为 0,那么就可以明确判断该元素不在集合中。
优缺点
优点:
- 节省存储空间:不需要保存数据本身,只需要记录数据映射后的 hash 比特位。
- 查询效率高:基于哈希算法完成判断,插入和查询的时间复杂度通常都为 O(k),其中 k 为哈希函数个数。
缺点:
- 存在一定误判:布隆过滤器判断“存在”时,元素实际上可能并不在集合中;其准确率与哈希函数设计及数量有关。
- 不支持直接删除:某个元素即便已经被删除,也很难从布隆过滤器中同步移除,这会进一步增加误判的可能性。
适用场景
- 爬虫系统 URL 去重
- 垃圾邮件过滤
- 黑名单过滤
缓存击穿
缓存击穿从字面上看,确实很容易和缓存穿透混淆,这也是很多面试官喜欢考察的重点。其实只要把概念理解透彻,面试时就不会轻易掉坑。
简单来说,缓存击穿是指某个 key 本身就是热点 key,一直承载着很高的并发访问。当这个热点 key 在某个瞬间失效时,持续不断的大并发请求就会直接绕过缓存,集中打到数据库上,就像堤坝突然被冲开一个口子,大量洪水瞬间灌入。
一旦发生缓存击穿,数据库查询压力会在短时间内急剧上升,进而导致大量请求阻塞,严重时甚至引发数据库雪上加霜的连锁反应。
这类问题的处理方式也不复杂。既然是热点 key,就说明该数据会被持续访问,那么可以考虑不给这个 key 设置过期时间。如果数据需要更新,可以在后台启动异步线程,发现缓存需要刷新时主动重建缓存即可。
当然,这种方案只适用于对数据一致性要求没有那么严格的业务场景。因为后台线程在重建缓存时,其他线程很可能仍在读取旧值,这样就可能读到过期但尚未更新的数据。
如果业务上必须严格保证缓存与数据库的数据一致性,那么就可以考虑使用互斥锁方案。
互斥锁
所谓互斥锁,就是在 key 失效后,只允许一个线程去查询数据库并重建缓存,其他线程则先等待,待缓存构建完成后再重新读取缓存。
如果是单机系统,使用 JDK 自带的 Synchronized 或 ReentrantLock 就可以实现。但一般来说,真正需要防止缓存击穿的系统往往都已经是高并发分布式场景了,这时更适合通过分布式锁来实现互斥控制。
为了让流程更容易理解,下面还是给大家准备一段伪代码:
public String getData(String key){
    String data = redisTemplate.opsForValue().get(key);
    if (StringUtils.isNotEmpty(data)){
        return data;
    }
    String lockKey = this.getClass().getName() + ":" + key;
    RLock lock = redissonClient.getLock(lockKey);
    try {
        boolean boo = lock.tryLock(5, 5, TimeUnit.SECONDS);
        if (!boo) {
            // 休眠一会儿,然后再请求
            Thread.sleep(200L);
            data = getData(key);
        }
        // 读取数据库的数据
        data = getDataByDB(key);
        if (StringUtils.isNotEmpty(data)){
            // 把数据构建到缓存中
            setDataToRedis(key,data);
        }
    } catch (InterruptedException e) {
        // 异常处理,记录日志或者抛异常什么的
    }finally {
        if (lock != null && lock.isLocked()){
            lock.unlock();
        }
    }
    return data;
}
不过,互斥锁方案也并不是完美无缺。缓存失效时,同一时间只有一个线程能够访问数据库并回写缓存,其他线程只能阻塞等待。如果是在高并发场景下,大量线程排队等待必然会影响系统吞吐量和响应速度。
因此,缓存设计本身就是一种权衡:你既想强一致性,又想高吞吐、高性能,往往很难同时做到绝对完美。很多时候,为了保证系统整体稳定性,适当牺牲一部分性能也是可以接受的。至于最终采用哪种方案,还是要结合具体业务场景、流量规模和一致性要求来综合判断,并不存在放之四海而皆准的万能方案。
缓存雪崩
缓存雪崩同样是因为 key 失效后,大量请求直接涌向数据库而引发的异常场景。不过它和缓存击穿有所不同:缓存击穿通常是某一个热点 key 失效导致的,而缓存雪崩则是缓存中大量数据在同一时间集中失效,海量请求瞬间压向 db 层,最终造成数据库压力过大,甚至直接宕机,这也正符合“雪崩”这个说法。

解决方案
缓存雪崩的处理思路和缓存击穿比较接近,同样可以通过设置 key 不过期或者使用互斥锁的方式来缓解问题。
除此之外,既然缓存雪崩的核心问题在于大量 key 同时过期,那么更重要的预防措施就是:为不同 key 的过期时间增加随机值,让缓存失效时间尽量打散,避免在同一时刻大面积失效。
redisTemplate.opsForValue().set(Key, value, time + Math.random() * 1000, TimeUnit.SECONDS);同时,还可以结合主备缓存策略,进一步提高互斥锁方案的可靠性。
主缓存:按照业务经验设置有效期,作为主要读取的缓存;主缓存失效后,再从数据库加载最新数据并重建。
备份缓存:有效期设置更长,当获取锁失败时读取备份缓存;主缓存更新时,也需要同步刷新备份缓存。
通常来说,上面三类缓存异常场景是最常见、也是面试中最容易被问到的内容。掌握这几种基本就足够应对大部分问题了。不过有些面试官喜欢继续追问缓存相关的延伸场景,为了更全面一些,我们再顺带补充两种常见的缓存策略。
缓存预热
缓存预热指的是系统上线后,先主动把相关业务数据加载到缓存中,这样用户首次访问时就可以直接命中缓存,避免请求一上来就直接查询数据库。
至于哪些数据需要预热,主要取决于访问量和数据规模。如果某部分数据访问量本来就不高,那么通常没必要专门做缓存预热,直接按照正常缓存读写流程处理即可。
如果访问量较大,则还需要结合数据量大小来设计不同的预热方案。
- 数据量不大的时候,可以在工程启动时直接加载缓存。这类数据一般可以是电商首页运营位、首页推荐配置等内容;
- 数据量较大的时候,可以通过定时任务或脚本定期执行缓存刷新;
- 数据量非常大的时候,应优先保证热点数据提前加载到缓存,并确保访问期间不要随意修改缓存内容。比如在秒杀活动开始前 30 分钟,就提前把商品信息刷新到缓存中,同时规定后台运营人员在活动期间不要修改商品属性。
缓存降级
缓存降级是指在缓存失效,或者缓存服务器宕机、不可用的情况下,系统不再继续访问数据库,而是直接返回默认数据,或者返回服务本地内存中的兜底数据。
在实际项目中,很多系统会把一部分热点数据同时缓存在服务内存中,比如使用 HashMap、Guava 这类工具。这样一旦 Redis 等缓存组件出现异常,就可以直接读取本地内存数据,尽量避免数据库承受过大的访问压力。
当然,这种做法本质上是一种业务兜底策略,往往会带来一定副作用。尤其在分布式系统中,很容易出现数据不一致的问题。所以通常来说,我们还是更倾向于从运维和架构层面优先保证缓存服务的高可用,例如 Redis 采用主从、哨兵或集群部署,并做好容灾和备份,尽可能避免走到缓存降级这一步。
最后
关于缓存的几种常见异常处理,这里就介绍到这了。虽然针对每种问题我们都给出了相应的解决思路,但并不意味着这些方案可以直接生搬硬套到所有业务场景中。真实开发过程中,还是要结合系统架构、数据特征、访问模型以及一致性要求,来制定合适的缓存策略。
比如使用布隆过滤器防止缓存穿透确实很有效,但在很多业务系统中并不一定是首选方案。现在不少防恶意请求、防刷、防攻击的能力,更多会优先在网关、运维或安全层面进行限制;而在业务代码层面,更多还是通过参数校验、数据校验等方式来做基础防护。
如果每一个使用缓存的地方都设计得过于复杂,不仅开发工作量会显著增加,后期维护成本也会更高,而且很多方案未必真的有足够高的实用价值。过度设计往往得不偿失。做程序开发,很多时候选择合适的方案,比选择最“高级”的方案更重要。程序员嘛,能少给自己制造一点麻烦就少一点,毕竟我们最大的敌人可能不只是 996,还有那越来越珍贵的发量啊。
本文同步分享在 博客“鄙人薛某”(CSDN)。
如有侵权,请联系 support@oschina.cn 删除。
本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。


