
随着互联网的快速发展,企业的业务类型不断增多,业务数据规模也在持续增长。当业务发展到一定阶段后,传统数据存储架构往往难以满足海量数据处理与实时分析需求,因此,实时数据仓库逐渐成为企业数字化建设中的关键基础设施。以维表 Join 为例,业务数据通常以范式表形式存储在业务系统中,分析查询时需要执行大量 Join 操作,这会显著影响查询性能。如果能够在数据清洗和导入阶段就以流式方式完成 Join,那么在后续分析过程中就无需重复关联,从而有效提升查询效率与整体分析性能。
借助实时数仓,企业可以实现实时 OLAP 分析、实时数据看板、实时业务监控以及实时数据接口服务等多种应用场景。不过,一提到实时数仓,很多人的第一反应仍然是架构复杂、实施门槛高、维护成本大。得益于新版 Flink 对 SQL 的良好支持,以及 TiDB 在 HTAP 方面的能力,我们探索出了一套高效、易上手、便于运维的 Flink+TiDB 实时数仓解决方案。
本文将先介绍实时数仓的基本概念,再说明 Flink+TiDB 实时数仓的架构设计与核心优势,随后分享一些已落地的典型用户实践,最后给出一个可在 docker-compose 环境中运行的 Demo,方便读者快速体验。
实时数仓的概念
数据仓库这一概念最早由 Bill Inmon 在 20 世纪 90 年代提出,指的是一个面向主题、集成、相对稳定并能够反映历史变化的数据集合,主要用于支持管理决策。早期的数据仓库通常通过消息队列采集来自各类数据源的数据,再按照每天或每周一次的频率进行计算,最终为报表分析提供支持,这类模式也被称为离线数仓。

离线数仓架构
进入 21 世纪后,随着计算技术演进和整体算力提升,决策主体逐步从人工判断转向计算机算法,实时推荐、实时监控、实时分析等需求不断出现。与之对应,决策周期也从天级逐步缩短到秒级,实时数仓正是在这样的背景下快速发展起来的。
当前主流的实时数仓架构主要包括三类:Lambda 架构、Kappa 架构以及实时 OLAP 变体架构:
- Lambda 架构指的是在离线数仓基础上叠加实时数仓能力,利用流式计算引擎处理实时性要求较高的数据,最终将离线结果与实时结果统一输出给上层应用使用。

实时数仓的 Lambda 架构
- Kappa 架构则去除了离线数仓部分,完全基于实时数据流进行生产与处理。这种架构统一了计算引擎,能够在一定程度上降低开发与维护成本。

实时数仓的 Kappa 架构
- 随着实时 OLAP 技术不断成熟,一种新的实时数仓架构也被提出,暂时称为“实时 OLAP 变体”。简单理解,就是将部分计算压力从流式计算引擎转移到实时 OLAP 分析引擎上,从而实现更加灵活的实时数仓计算能力。

总体来看,在实时数仓建设中,Lambda 架构需要同时维护流式和批式两套引擎,因此开发和运维成本通常高于另外两种方案。相比 Kappa 架构,实时 OLAP 变体架构在计算灵活性方面更有优势,但也需要额外依赖实时 OLAP 的算力资源。接下来将要介绍的 Flink + TiDB 实时数仓方案,就属于实时 OLAP 变体架构。
如果希望进一步了解实时数仓及上述架构的详细对比,感兴趣的读者可以参考 Flink 中文社区的相关文章:基于 Flink 的典型 ETL 场景实现方案。
Flink+ TiDB 实时数仓
Flink 是一款低延迟、高吞吐、流批一体化的大数据计算引擎,广泛应用于高实时性场景下的实时计算任务,并具备 exactly-once 等关键特性。
在集成 TiFlash 之后,TiDB 已成为真正意义上的 HTAP(在线事务处理 OLTP + 在线分析处理 OLAP)数据库。也就是说,在实时数据仓库架构中,TiDB 既能够作为业务数据库承载数据源和在线事务查询,又能够作为实时 OLAP 分析引擎支撑分析型计算场景。
Flink 与 TiDB 的能力结合后,使得 Flink + TiDB 实时数仓方案的优势更加突出。首先,在性能与扩展性方面,两者都可以通过水平扩展节点来提升整体算力,因此能够为系统速度和稳定性提供可靠保障。其次,TiDB 深度兼容 MySQL 协议,而 Flink 提供了 Flink SQL 以及丰富的连接器生态,用于快速编写和提交实时任务,因此整体学习成本、接入成本和配置门槛都相对较低。
针对 Flink + TiDB 实时数仓,下面介绍几种常见的搭建原型。这些原型可以满足不同场景下的实时数据处理需求,也能够在实际业务中按需扩展。
以 MySQL 作为数据源
通过使用 Ververica 官方提供的 flink-connector-mysql-cdc,Flink 既可以作为数据采集层,采集 MySQL binlog 生成动态表,也可以作为流计算层完成各类实时计算任务,例如流式 Join、预聚合等。最终,Flink 再通过 JDBC 连接器将处理完成的数据写入 TiDB。
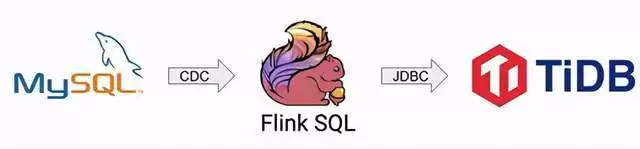
以 MySQL 作为数据源的简便架构
这一架构的优势在于整体设计简洁、部署方便。在 MySQL 与 TiDB 预先准备好对应数据库和表结构的前提下,通常只需要编写 Flink SQL,即可完成任务注册与作业提交。读者可以在本文末尾的【在docker-compose 中进行尝试】部分体验该架构。
以 Kafka 对接 Flink
如果数据已经通过其他方式进入 Kafka,那么可以直接借助 Flink Kafka Connector,让 Flink 从 Kafka 中消费数据并进行后续实时处理。
这里还需要补充一点:如果计划将 MySQL 或其他数据源的变更日志先写入 Kafka,再交由 Flink 处理,那么推荐使用 Canal 或 Debezium 来采集数据源的变更日志。原因在于 Flink 1.11 已原生支持解析这两类工具生成的 changelog 格式,无需额外开发解析器,能显著降低接入复杂度。
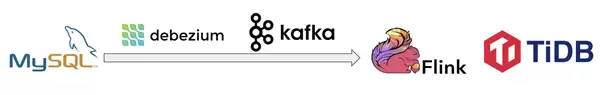
以 MySQL 作为数据源,经过 Kafka 的架构示例
以 TiDB 作为数据源
TiCDC 是一款通过拉取 TiKV 变更日志来实现 TiDB 增量数据同步的工具,可以利用它将 TiDB 的变更数据输出到消息队列中,再由 Flink 进一步消费和处理。

以 TiDB 作为数据源,通过 TiCDC 将 TiDB 的增量变化输出到 Flink 中
在 4.0.7 版本中,可以通过 TiCDC Open Protocol 实现与 Flink 的对接。在后续版本中,TiCDC 还将支持直接输出 canal-json 格式,以便更方便地供 Flink 使用。
案例与实践
上一部分介绍的是一些基础架构原型,而在真实业务场景中,实时数仓的实践通常更加复杂,也更具参考价值。下面将分享几个具有代表性和启发意义的用户案例。
小红书
小红书是面向年轻用户的生活方式平台,用户可以通过短视频、图文等形式记录生活、分享经验,并基于兴趣产生互动。截至 2019 年 10 月,小红书月活跃用户数已经过亿,且仍保持快速增长。
在小红书的业务架构中,Flink 的数据输入端与结果汇总端都采用了 TiDB,从而达到类似“物化视图”的效果:
- 左上角的线上业务表负责承载正常的 OLTP 业务任务。
- 下方的 TiCDC 集群抽取 TiDB 的实时变更数据,并以 changelog 形式传递到 Kafka 中。
- Flink 消费 Kafka 中的 changelog 数据并进行计算,例如构建宽表或聚合表。
- Flink 再将计算结果回写到 TiDB 的宽表中,供后续分析查询使用。

小红书 Flink TiDB 集群架构
整个流程形成了基于 TiDB 的数据闭环,将后续分析任务中的 Join 压力前移到 Flink 侧,并通过流式计算实现压力分担。目前,这套方案已经支撑了小红书的内容审核、笔记标签推荐、增长审计等核心业务,经历了高吞吐线上场景考验,并保持稳定运行。
贝壳金服
贝壳金服长期深耕居住场景,积累了丰富的中国房产大数据资源。其以金融科技为驱动,结合 AI 算法高效利用多维海量数据,提升产品体验,并为用户提供丰富且定制化的金融服务。
在贝壳数据组的数据服务体系中,Flink 实时计算主要被用于典型的维表 Join 场景:
- 首先,使用 Syncer(一个 MySQL 到 TiDB 的轻量级同步工具)将业务数据源中的维表数据同步到 TiDB。
- 随后,业务数据源中的流表数据通过 Canal 采集 binlog,并写入 Kafka 消息队列。
- Flink 读取 Kafka 中流表的变更日志,执行流式 Join;当需要访问维表数据时,再到 TiDB 中进行查找。
- 最后,Flink 将拼接完成的宽表写入 TiDB,用于后续数据分析服务。
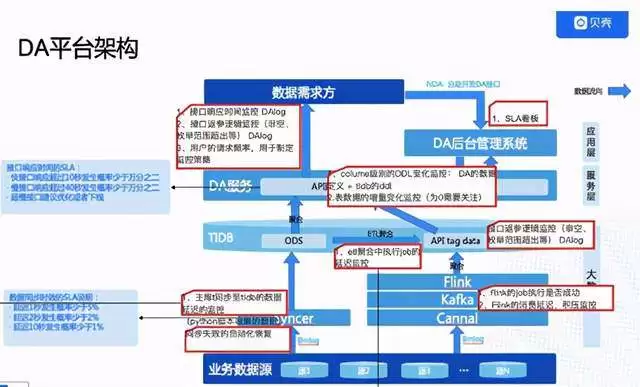
贝壳金服数据分析平台架构
借助上述架构,数据服务中的主表可以实时完成 Join 并落地,下游服务方只需要查询单表即可。这套系统目前已经深入贝壳金服多个核心业务系统,跨系统数据获取统一通过数据组的数据服务完成,减少了业务系统自行开发 API 以及编写内存聚合逻辑的工作量。
智慧芽
PatSnap(智慧芽)是一款全球专利检索数据库,整合了自 1790 年至今、覆盖全球 116 个国家和地区的 1.3 亿专利数据,以及 1.7 亿化学结构数据。用户可以进行专利检索、浏览、翻译,并生成 Insights 专利分析报告,用于专利价值分析、引用分析、法律搜索以及查看 3D 专利地图。
智慧芽使用 Flink + TiDB 替换了原有的 Segment + Redshift 架构。
在原有的 Segment + Redshift 架构中,只构建了 ODS 层,数据写入规则和 schema 缺乏有效控制。同时,还需要围绕 ODS 编写复杂 ETL,才能按照业务需求完成各类指标计算并支撑上层应用。由于 Redshift 中落库数据量大,计算速度慢,整体时效通常为 T+1,并且还会影响对外服务性能。
替换为基于 Kinesis +Flink + TiDB 构建的实时数仓架构后,不再需要单独建设 ODS 层。Flink 作为前置计算单元,直接从业务需求出发构建 Flink Job ETL,完全控制落库规则并自定义 schema;也就是说,只把业务真正关注的指标清洗后写入 TiDB,用于后续分析查询,从而显著减少写入数据量。围绕用户/租户、地区、业务动作等关键指标,再结合分钟、小时、天等不同粒度时间窗口,最终在 TiDB 上构建 DWD/DWS/ADS 层,直接服务于业务统计、明细清单等需求,使上层应用能够直接使用加工完成的数据,并获得秒级实时能力。
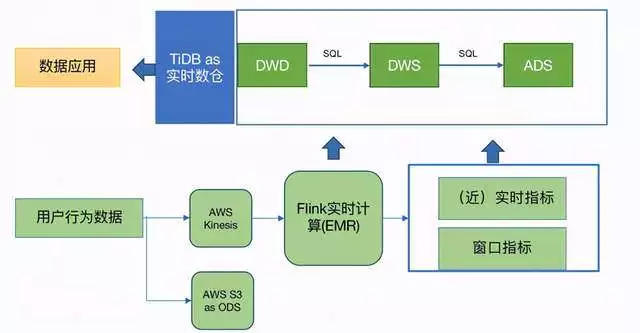
智慧芽数据分析平台架构
从用户体验来看,新架构下入库数据量、入库规则复杂度以及整体计算复杂度都大幅降低。数据在 Flink Job 中按业务需求处理完成后再写入 TiDB,不再依赖 Redshift 的全量 ODS 层进行 T+1 ETL。基于 TiDB 构建的实时数仓通过合理的数据分层,架构更加精简,开发与维护更简单;数据查询、更新和写入性能也显著提升;在满足不同 ad hoc 分析需求时,无需等待类似 Redshift 的预编译过程;同时扩容方便,整体开发效率更高。
目前,这套架构正在逐步上线,已在智慧芽内部用于用户行为分析与追踪,并汇总形成公司运营大盘、用户行为分析、租户行为分析等功能。
网易互娱
网易于 2001 年正式成立在线游戏事业部,经过近 20 年发展,已经跻身全球七大游戏公司之一。在 App Annie 发布的“2020 年度全球发行商 52 强”榜单中,网易位列第二。
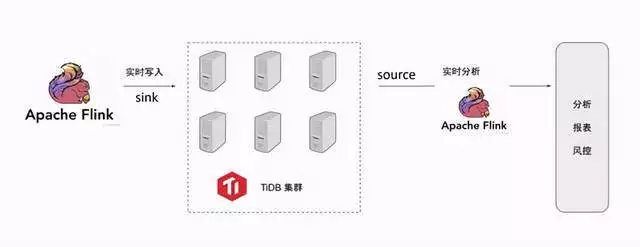
网易互娱数据计费组平台架构
在网易互娱计费组的应用架构中,一方面通过 Flink 完成业务数据源到 TiDB 的实时写入;另一方面,又以 TiDB 作为分析型数据源,在后续 Flink 集群中继续执行实时流计算,生成分析报表。此外,网易互娱内部还开发了 Flink 作业管理平台,用于统一管理作业的完整生命周期。
知乎
知乎是中文互联网综合内容平台,以“让每个人高效获得可信赖的解答”为品牌使命和北极星。截至 2019 年 1 月,知乎已拥有超过 2.2 亿用户,累计产出 1.3 亿个回答。
知乎作为 PingCAP 的合作伙伴,同时也是 Flink 的深度使用者,在实际落地过程中开发了一套 TiDB 与 Flink 的交互工具,并贡献给开源社区:pingcap-incubator/TiBigData,主要包括以下能力:
- TiDB 作为 Flink Source Connector,用于批量同步数据。
- TiDB 作为 Flink Sink Connector,基于 JDBC 实现。
- Flink TiDB Catalog,可以在 Flink SQL 中直接使用 TiDB 表,而无需重复创建表定义。
Flink TiDB 实时数仓 Slides 中还提供了该场景下的一个简明教程,内容包括概念说明、代码示例、基础原理以及一些注意事项,其中示例涵盖:
- Flink SQL 简单尝试
- 利用 Flink 进行从 MySQL 到 TiDB 的数据导入
- 双流 Join
- 维表 Join
在启动 docker-compose 后,可以通过 Flink SQL Client 编写并提交 Flink 任务,并通过 localhost:8081 观察任务执行状态。
原文链接
本文为阿里云原创内容,未经允许不得转载。


