
上周,Anthropic有一个看似低调却很值得关注的动作——他们计划在 Claude 的设置中加入一项名为“AI Fluency”的个性化评分功能。简单理解,就是为你的 AI 使用熟练度打分,并进一步告诉你还能如何优化使用方式。
事实上,早在今年 2 月,Anthropic 就发布过一份《AI Fluency Index》研究报告。当时一个很有代表性的发现是:随着 AI 工具快速普及,用户是否也在学习更高效、更谨慎地使用人工智能?结论显示,当用户借助 AI 生成代码、应用、文档或交互式工具等更复杂的成果时,确实能够提出更精准的提示词与指令,也更明确自己真正需要什么。但随之而来的问题也逐渐显现——用户反而更少主动质疑 AI 的输出内容,导致更容易忽视其论证是否可靠、回答是否缺乏必要背景,以及事实信息是否存在错误。
研究还指出了一个重要信号:反复迭代与持续修正,是预测高质量 AI 使用水平最强的指标之一。换句话说,如果用户经常与 AI 展开贴近真实工作的连续对话,其 AI 应用能力往往更容易提升。同时,排版专业、措辞自信的回答,也更容易被默认视为可信内容——而这背后其实隐藏着不容忽视的认知陷阱。
如今,Anthropic 正在基于这些研究成果,将其转化为 Claude 内部的个人能力反馈功能。相关选项已经出现在 Claude 的设置页面中。用户进入特定界面后,可以让 Claude 生成一份结构化的 AI 使用能力报告,并直接在设置面板中查看和管理结果。
这份评分卡会扫描用户在 Chat、CoWork、Claude Code 中的活动记录,然后依据 11 个可观察行为进行评分。评估维度涵盖目标澄清、沟通表达、质量控制等多个方面,整体对应的是 Anthropic 与学者 Rick Dakan、Joseph Feller 共同构建的 4D AI Fluency Framework——其核心维度包括委派、描述、辨别等方向。
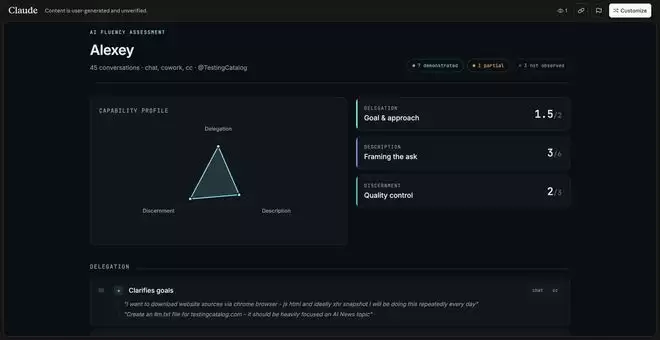
Claude AI Fluency 评分示意图
除了行为评分外,这张评分卡还会纳入近 30 天的产品功能使用情况。例如某位用户:projects 功能使用了 30 次对话,web-search 使用了 27 次,artifacts 使用了 3 次,connectors 使用了 4 次,而 memory 使用为 0 次。系统会将行为反馈与功能探索情况结合起来,并根据尚未使用的功能给出下一步优化建议。最终结果会显示一个类似 7.5/11 的分数,同时明确指出哪些使用习惯值得保留,哪些能力环节还可以进一步提升。对于 AI 新手用户来说,这类功能尤其友好——你不必再猜测自己是否用对了方法,系统会直接告诉你哪些做法更有效,哪些地方还有进步空间。
可以说,这不仅是在给 AI 使用能力打分,更是在帮助用户建立对 AI 的“元认知”。未来,类似的 AI 反馈机制很可能会成为智能工具的标准配置——你越懂得高效使用 AI,工具能回馈给你的价值也就越大。


