
“(我口袋里)东西实在太多了。”黄仁勋在台北用中文这样调侃自己。

6月1日,在台北电脑展前夕,GPU行业最具代表性的“带货主播”、英伟达创始人黄仁勋,带来了一场名为GTC Taipei 2026的主题演讲。围绕英伟达打造的AI工厂生态系统,他一口气发布了多款重磅新品:Vera CPU、Vera Rubin、Vera BlueField-4 STX、DSX、RTX Spark……一连串新品名称密集登场,普通用户最直观的感受大概只有两个字:强悍。
如果只看硬件参数,这场演讲依然像是一场标准的英伟达新品发布会。但真正值得关注的变化在于,英伟达正在尝试把CPU、GPU、网络、存储、散热、Windows PC,甚至安全权限管理,全部整合进同一个AI叙事框架中。
这个新故事的核心关键词,就是“智能体AI”。而其中最关键的两个新角色,一个是面向数据中心与AI基础设施的Vera CPU,另一个则是面向个人电脑与AI PC市场的RTX Spark(此前网传代号为N1X)。从GPU扩展到CPU,再到“重新定义个人电脑”,英伟达显然不只是想继续卖GPU,它更希望在AI时代,为数据中心和个人PC描绘新的计算蓝图。
英伟达Vera炸场:AI时代的原生CPU
先看最硬核、也最值得行业关注的部分:Vera CPU。
过去几年的AI浪潮中,英伟达的核心竞争力始终集中在GPU。从A100、H100到Blackwell,整个AI产业链的焦虑点也大多围绕GPU展开:谁能买到?谁能稳定供货?谁能把机柜真正堆起来?但当大模型从聊天机器人进一步演进为智能体AI,问题开始明显变得更复杂。
一个AI智能体不只是生成文本内容,它还需要拆解任务、检索资料、执行代码、调用工具、验证结果,甚至同时维护成千上万个执行环境。在这种工作负载下,CPU的重要性再次被推回台前。也正因此,我们看到了英伟达专门为AI时代设计的原生CPU——Vera。
英伟达对Vera的定位非常直接:这是第一颗专为AI智能体超大规模运行打造的CPU。它拥有88个自研Olympus核心,支持Spatial Multithreading,LPDDR5X内存带宽最高可达1.2TB/s。在Vera Rubin系统中,它还能通过第二代NVLink-C2C与GPU实现最高1.8TB/s的一致性带宽连接。
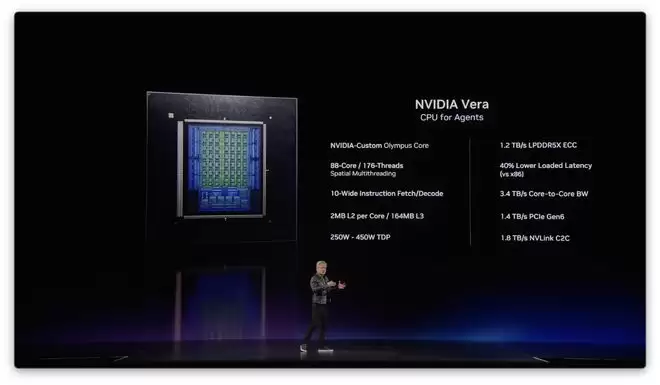
在这些参数背后,CPU在AI基础设施中的角色已经发生变化。它不再只是为GPU“打下手”的配套部件。在智能体工作流中,代码执行、数据处理、沙盒环境和任务编排,都会成为AI算力工厂中的关键路径。按照英伟达公布的数据,Vera相比传统x86 CPU可带来1.8倍更快的任务完成速度,此前官方也强调过其2倍能效与50%的性能提升。
如今,AI工厂的竞争逻辑,已经从“每张卡卖多少钱”逐渐转向“每瓦电能究竟能产出多少token”。Vera Rubin正是这一逻辑的强化版本。黄仁勋宣布,Vera Rubin已进入全面量产阶段,系统由Vera CPU、Rubin GPU、Groq 3 LPX、BlueField-4 STX存储以及Spectrum-6网络等机架级组件构成。根据最新数据,相比上一代Grace Blackwell,Vera Rubin在大规模智能体吞吐能力上最高可达10倍。
也正因为智能体AI会持续读写企业数据,英伟达把存储与安全能力一并纳入了这套AI工厂叙事中。Vera BlueField-4 STX的重点,不只是再推出一款DPU,而是把智能体的上下文记忆、文件访问控制和网络隔离能力,直接下沉到芯片层面处理。按照英伟达给出的数据,Vera BlueField-4 STX在引入DOCA后,运行时威胁检测速度相比现有无智能体方案最高可快1000倍,并能在最高800Gb/s速率下执行网络与文件访问策略。
RTX Spark将彻底引爆个人PC智能体
如果说Vera是AI工厂的新地基,那么RTX Spark就是这场发布会中距离普通用户最近、也最有机会引爆AI PC市场的产品。
英伟达与微软将RTX Spark定义为面向个人AI智能体的Windows PC超级芯片。它拥有1 petaflop的AI算力、最高128GB统一内存,采用Blackwell RTX GPU,配备6144个CUDA核心、第五代Tensor Core和FP4精度,并通过NVLink-C2C连接一颗20核Grace CPU。

顺带一提,这颗SoC中的Grace CPU部分由英伟达与联发科联合定制设计。而首款搭载RTX Spark的笔记本电脑,将是微软的Surface Laptop Ultra,计划于今年晚些时候正式发布。与此同时,联想、戴尔、惠普、华硕、宏碁等厂商的同类AI PC产品,也都已在上市路上。
RTX Spark的硬件配置,听起来已经不像传统笔记本电脑,更像是DGX Spark的消费级版本。英伟达给出的使用场景同样十分明确:
- 本地运行1200亿参数大模型和最高100万token上下文;
- 渲染90GB以上3D场景;
- 剪辑12K 4:2:2视频;
- 生成4K AI视频;
- 在1440p下以超过100帧运行3A游戏。

过去两年,AI PC最大的尴尬在于,不少产品只是在传统PC中加入一个NPU,然后就直接告诉用户“这就是AI PC”。但普通用户真正关心的问题是:能不能不用排队等待云端算力、不额外支付token费用、不把私人文件上传到云端,也能让AI真正帮我完成一些实际工作?
RTX Spark给出的答案显然更激进——让AI智能体直接进入Windows工作流。英伟达和微软将提供新的Windows安全基础架构,以及英伟达OpenShell,使智能体在本地运行时具备身份认证、隔离机制、策略管理和权限控制能力。Adobe也宣布,将为RTX Spark重构Photoshop和Premiere,并声称AI与图形性能最高可提升2倍。
这当然不意味着PC会立刻从工具变成“同事”。真正的门槛依然存在于软件层面:智能体是否能稳定调用应用程序?是否能准确理解本地文件?一旦出错由谁负责?用户又是否愿意把更多权限交给它?这些问题显然不是单靠1 petaflop算力就能彻底解决的。
写在最后
在演讲中,黄仁勋展示了一张围绕英伟达构建的AI工厂生态图,几乎覆盖了AI时代全球最具实力的一批公司。其中,联想作为唯一一家港股上市公司,近期也交出了一份历史最佳财报。
当然,这场台北演讲的重点并不只有Vera和RTX Spark。英伟达还把“AI工厂”的整体施工图继续向前推进,发布了DSX平台;对应桌面端,则推出了面向企业用户的DGX Station for Windows。另一条重要主线则是物理AI:英伟达不仅发布了Cosmos 3开放世界基础模型、物理AI开源工具与技能、Isaac GR00T人形机器人参考设计,还进一步扩展了DRIVE Hyperion robotaxi生态。
正如黄仁勋自己所说,口袋里的东西确实太多了。从晶圆厂、AI工厂、企业级桌面,到医院、机器人以及自动驾驶,英伟达正在尝试把“智能体”打造为下一代计算平台的默认用户。而在这套宏大布局中,最关键的两大核心节点,依然是数据中心和个人PC。


