
理解urllib3连接池与PoolManager工作机制
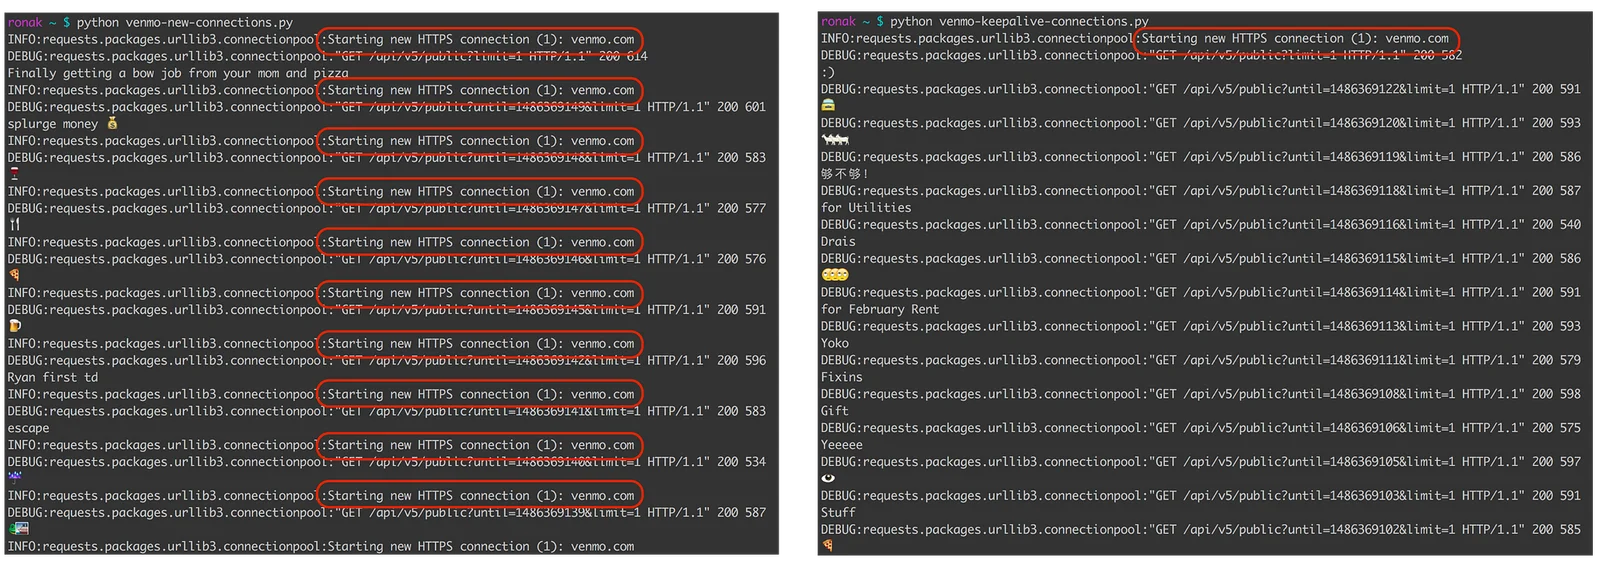
在网络请求中,频繁建立和断开TCP连接会消耗大量系统资源并增加延迟。urllib3通过内置的连接池机制有效解决了这一问题。PoolManager是urllib3的核心入口,它负责为每个目标主机维护独立的连接池。当发起请求时,PoolManager会优先检查池中是否存在空闲连接,若存在则直接复用,从而跳过耗时的TCP三次握手与TLS协商过程。这种设计显著降低了高并发场景下的网络延迟。标准使用方式非常简单:首先实例化PoolManager,随后调用其request方法即可自动完成连接分配与响应读取。例如,通过http = urllib3.PoolManager()创建管理器后,执行response = http.request('GET', 'https://httpbin.org/get')即可获取响应对象。请求结束后,连接不会立即关闭,而是归还至池中等待下一次复用,开发者无需手动管理底层Socket生命周期。
配置连接池大小与并发请求
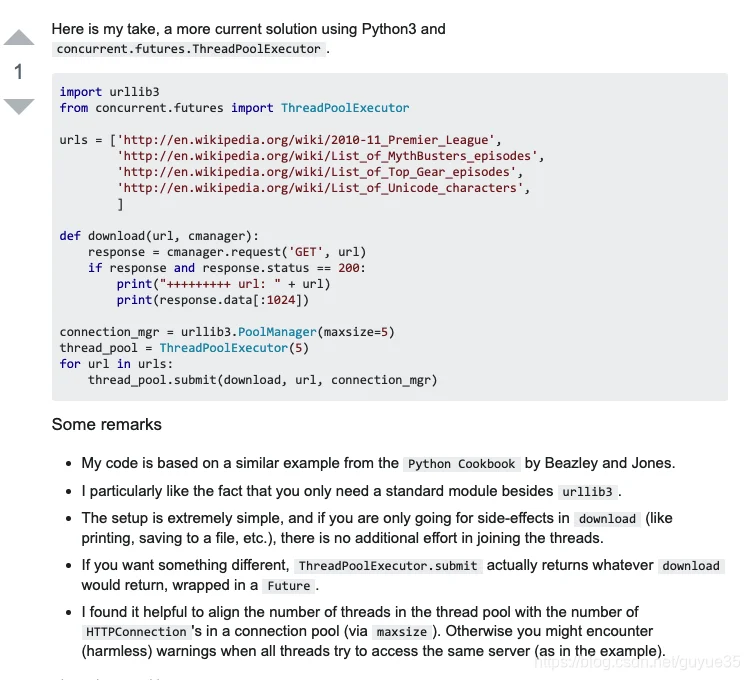
在实际并发场景中,合理配置连接池参数是保障系统稳定性的关键。num_pools控制PoolManager可缓存的主机连接池数量,默认值为10;若请求目标域名超过此限制,旧池将被淘汰。maxsize定义单个主机连接池的最大连接数,默认通常为10。当活跃连接数达到上限时,block参数决定后续请求的行为:若设为False(默认),新请求将直接抛出MaxRetryError;若设为True,请求将阻塞等待空闲连接释放。在多线程环境下,建议显式设置maxsize以匹配线程数,并启用block=True避免突发流量击穿。例如:http = urllib3.PoolManager(num_pools=5, maxsize=20, block=True)。需注意,连接复用依赖于正确的响应体读取与关闭操作。若未完整读取response.data或未调用response.release_conn(),连接将滞留池中无法复用,最终导致连接泄漏。因此,务必使用上下文管理器或显式释放机制确保资源回收。
设置Retry重试策略与退避机制
网络环境具有不确定性,urllib3提供了urllib3.util.Retry类来实现精细化的重试控制。核心参数包括:total设置最大重试总次数;connect与read分别限制连接建立失败和读取超时的重试次数;status用于指定因HTTP状态码触发的重试次数。allowed_methods定义允许重试的HTTP方法(默认仅GET等安全方法),status_forcelist则列出触发重试的状态码列表(如[500, 502, 503, 504])。为避免重试风暴,backoff_factor引入指数退避算法,实际等待时间为backoff_factor * (2 ** (retry_count - 1))。配置示例如下:retries = Retry(total=3, connect=2, read=2, status=2, status_forcelist=[500, 502, 503], backoff_factor=0.5)。将其传入PoolManager(retries=retries)后,当遇到临时性网络抖动或服务器5xx错误时,库会自动按策略重试,并在每次失败后递增等待时间,从而保护下游服务并提升请求成功率。
组合连接池与重试策略并验证效果
在生产环境中,将连接池与重试策略组合使用是构建高可用HTTP客户端的标准实践。通过PoolManager(num_pools=10, maxsize=50, block=True, retries=Retry(...))可一次性完成底层资源管理与容错逻辑的绑定。验证时,可通过模拟网络延迟或返回503状态码的测试接口,观察日志中自动重试与退避等待的触发过程。若请求最终成功,连接将被正确复用;若耗尽重试次数,则抛出MaxRetryError供上层捕获。避坑方面需注意三点:一是务必配置合理的timeout参数(如Timeout(connect=3.0, read=5.0)),防止重试叠加导致总耗时过长;二是警惕非幂等请求(如POST/PUT)被意外重试,应严格限制allowed_methods;三是避免将backoff_factor设得过大或total过高,以免引发重试风暴拖垮客户端线程池。结合结构化日志记录重试次数与最终状态,可快速定位网络瓶颈并优化服务调用链路。


