语义决定结果,也隐含性能差异
在 MySQL 中,INNER JOIN 仅返回两表匹配键值均存在的记录,而 LEFT JOIN 会保留左表所有行,右表无匹配时以 NULL 填充。这种语义差异直接决定了结果集大小与计算开销。例如,执行 SELECT a.id, b.name FROM users a LEFT JOIN profiles b ON a.id = b.user_id; 时,即使部分用户未完善资料,查询仍会返回完整用户列表。外连接因需处理未匹配行的 NULL 填充与额外的哈希或排序操作,理论上可能引入更多 CPU 与内存消耗,但性能优劣绝不能仅凭 JOIN 类型武断判定。实际执行效率高度依赖驱动表选择、索引覆盖情况以及数据匹配率。若左表数据量极小且右表连接列有高效索引,LEFT JOIN 的执行耗时可能与 INNER JOIN 相差无几。开发者应首先明确业务是否需要保留未匹配数据,再结合执行计划评估性能,而非盲目替换连接类型。
用 EXPLAIN 分析连接执行计划
准确评估 JOIN 性能的核心在于解读执行计划。在 MySQL 8.0 及以上版本,推荐使用 EXPLAIN 或 EXPLAIN ANALYZE 命令。执行 EXPLAIN 后,需重点关注 type 列(访问类型,如 ALL 全表扫描、ref 索引查找、eq_ref 唯一索引匹配)、key 列(实际使用的索引)、rows 列(预估扫描行数)以及 Extra 列(如 Using join buffer、Using where)。例如,若驱动表的 type 为 ALL 且 rows 值巨大,说明未走索引,此时无论 INNER 还是 LEFT JOIN 都会导致性能瓶颈。EXPLAIN ANALYZE 则能返回实际执行时间与行数,帮助验证优化器预估是否准确。通过观察执行计划中的驱动表与被驱动表顺序,可判断优化器是否选择了最优连接路径。若发现连接顺序不合理,可通过 STRAIGHT_JOIN 强制指定,或执行 ANALYZE TABLE 更新统计信息以引导优化器。建立以执行计划为核心的分析习惯,是科学诊断 JOIN 性能的前提。
搭建测试场景对比内外连接性能
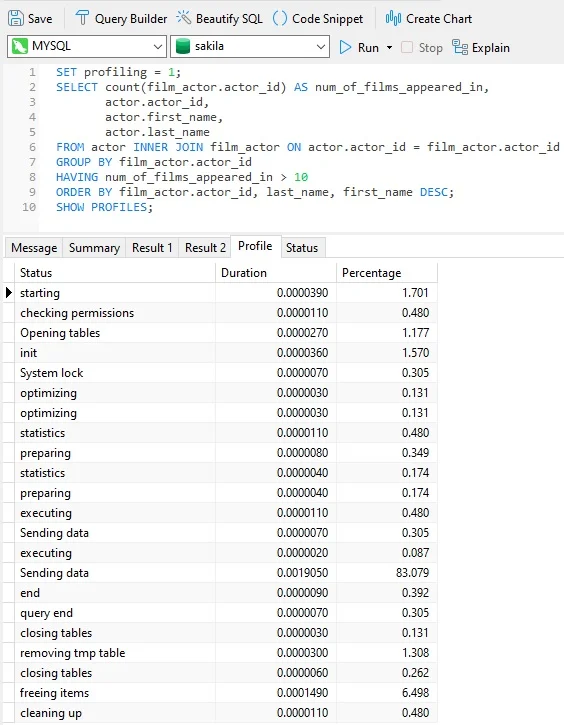
搭建可复现的测试场景需严格控制变量。首先创建 orders 订单表与 customers 客户表,分别插入十万条基础数据,确保 orders.customer_id 与 customers.id 存在约百分之八十的匹配率。在连接列上创建普通索引后,使用 EXPLAIN ANALYZE 分别执行 INNER JOIN 与 LEFT JOIN 查询。测试时务必多次运行取平均值,以消除缓冲池预热带来的偏差。对比指标应包含实际执行时间、扫描行数、临时表与文件排序使用情况。例如,在匹配率较高且索引生效时,两者执行计划可能完全一致,耗时差异在毫秒级;但当左表存在大量无匹配记录时,LEFT JOIN 需额外处理 NULL 填充,可能导致 Using temporary 或内存溢出。通过多轮压测与不同数据分布的交叉验证,才能得出具备参考价值的性能结论,避免单次偶然结果误导架构决策。
优化 JOIN 性能:索引、过滤与查询写法
JOIN 性能优化需从索引设计、条件过滤与 SQL 写法三方面入手。首要原则是为连接列建立合适索引,优先使用覆盖索引避免回表。例如,执行 CREATE INDEX idx_cust_id ON orders(customer_id); 可显著提升被驱动表的查找效率。其次,应将过滤条件尽可能下推至驱动表,减少参与连接的数据量。若 LEFT JOIN 的 WHERE 条件中包含右表字段非空判断,MySQL 会隐式将其转换为 INNER JOIN,此时应直接改写为 INNER JOIN 以消除优化器误判。此外,避免使用 SELECT 星号,仅查询必要字段可降低网络传输与内存排序开销。对于复杂多表连接,可考虑将部分逻辑拆分为子查询或临时表,降低单次 JOIN 的复杂度。所有优化动作必须以 EXPLAIN 输出与实际执行数据为依据,通过对比优化前后的 type、rows 与 Extra 字段变化,验证索引是否命中、连接顺序是否合理,切忌脱离执行计划盲目调整 SQL 结构。

常见性能误区与实际选型建议
在实际开发中,开发者常陷入 LEFT JOIN 必然慢于 INNER JOIN 的误区,进而盲目将外连接改为内连接,导致业务逻辑错误,如丢失未关联的报表记录。性能瓶颈往往源于缺失索引、数据倾斜或过滤条件位置不当,而非 JOIN 类型本身。仅凭执行时间判断性能同样片面,因为缓存命中与并发负载均会影响耗时。正确的选型原则应以业务语义为基石:若必须保留主表全量数据且允许从表缺失,应使用 LEFT JOIN;若仅需交集数据,则 INNER JOIN 更为高效。RIGHT JOIN 因可读性差且可等价转换为 LEFT JOIN,建议尽量避免。在数据分布极度不均的场景下,LEFT JOIN 可能触发全表扫描或大量临时表操作,此时需结合 EXPLAIN 评估是否改用 NOT EXISTS 或分步查询。最终,连接方式的选择必须经过真实数据压测与执行计划验证,确保在满足业务需求的前提下实现性能最优。