
语法差异背后的机制:立即执行与惰性求值
生成器表达式与列表推导式在语法上仅有一对括号之差,但底层运行机制截然不同。列表推导式使用方括号[],会在定义瞬间立即执行并一次性将所有结果存入内存,返回一个完整的列表对象。而生成器表达式使用圆括号(),返回的是一个生成器对象,它遵循惰性求值(Lazy Evaluation)原则。这意味着数据不会在定义时被计算,而是等到外部通过for循环或next()函数主动请求时才逐项产生。例如,执行gen = (x * 2 for x in range(1000000))时,Python仅分配极小的内存来保存迭代状态,不会创建百万级整数列表。生成器本质上是一个迭代器,具有“单向流动”的特性,元素一旦被消费便无法回溯,这种按需产生的机制正是流式处理的基石。

构建内存友好的数据管道
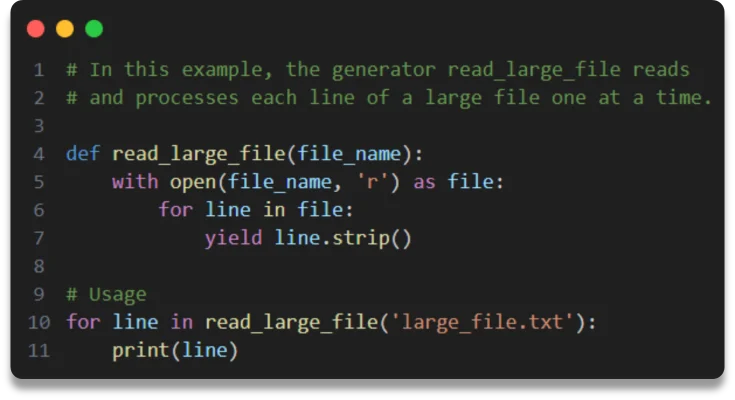
在处理GB级别的日志文件或海量数据集时,将数据全部读入内存会导致程序崩溃或严重卡顿。生成器表达式允许我们以“管道”形式串联过滤、转换与聚合操作,实现真正的流式处理。例如,读取一个包含千万行记录的日志文件时,可编写如下代码:with open('app.log', 'r', encoding='utf-8') as f: error_count = sum(1 for line in f if 'ERROR' in line)。此处f本身是一个文件迭代器,生成器表达式逐行读取、即时判断是否包含错误关键字,并仅对符合条件的行进行计数累加。整个过程中,内存中始终只保留当前正在处理的一行文本及计数器变量,峰值内存占用稳定在KB级别。若需进一步清洗数据,还可将多个生成器嵌套组合,如(float(val) for line in f if line.strip() for val in line.split(',')),确保数据在流转过程中始终保持“计算即丢弃”的流式特征。
内存占用的量化验证
通过Python内置的sys.getsizeof模块可以直观验证两者的内存差异。在标准64位Python环境中,执行lst = [i for i in range(1000000)]后,sys.getsizeof(lst)通常返回约8.5MB,因为列表需要为每个整数分配指针并维护底层动态数组结构。而执行gen = (i for i in range(1000000))后,sys.getsizeof(gen)仅返回约112字节,因为生成器对象只保存了迭代器状态、代码对象引用及局部变量指针,不存储实际数据。这种数量级的差异直接证明了流式处理能彻底消除峰值内存压力。需要注意的是,内存优势并不等同于绝对的速度优势。生成器在每次调用next()时需恢复执行上下文并执行状态切换,存在微小的CPU开销。因此,在纯CPU密集型且数据量较小的场景中,列表推导式可能更快;但在I/O密集或数据规模超出物理内存时,生成器的内存友好性才是决定程序能否稳定运行的关键。
使用边界与常见陷阱
生成器表达式虽高效,但开发者常因忽略其迭代器本质而陷入误区。最典型的问题是“重复消费”:生成器是单向流,一旦遍历结束便会耗尽(Exhausted)。例如执行gen = (x for x in range(3))后,第一次list(gen)得到[0, 1, 2],第二次再调用list(gen)只会返回空列表[],因为内部指针已到达末尾。另一个常见错误是隐式物化,如在调试时直接使用list(generator)或len(generator),这会强制Python将所有数据一次性加载到内存,完全抵消流式处理的内存优势。此外,生成器不支持索引访问、切片或长度查询,若业务逻辑需要多次遍历同一数据集、随机读取特定位置元素或提前获取数据总量,则必须改用列表或数组。合理的使用边界是:当数据只需单次顺序处理、规模庞大或来源为无限流时,优先选择生成器表达式;反之则应使用传统容器。


