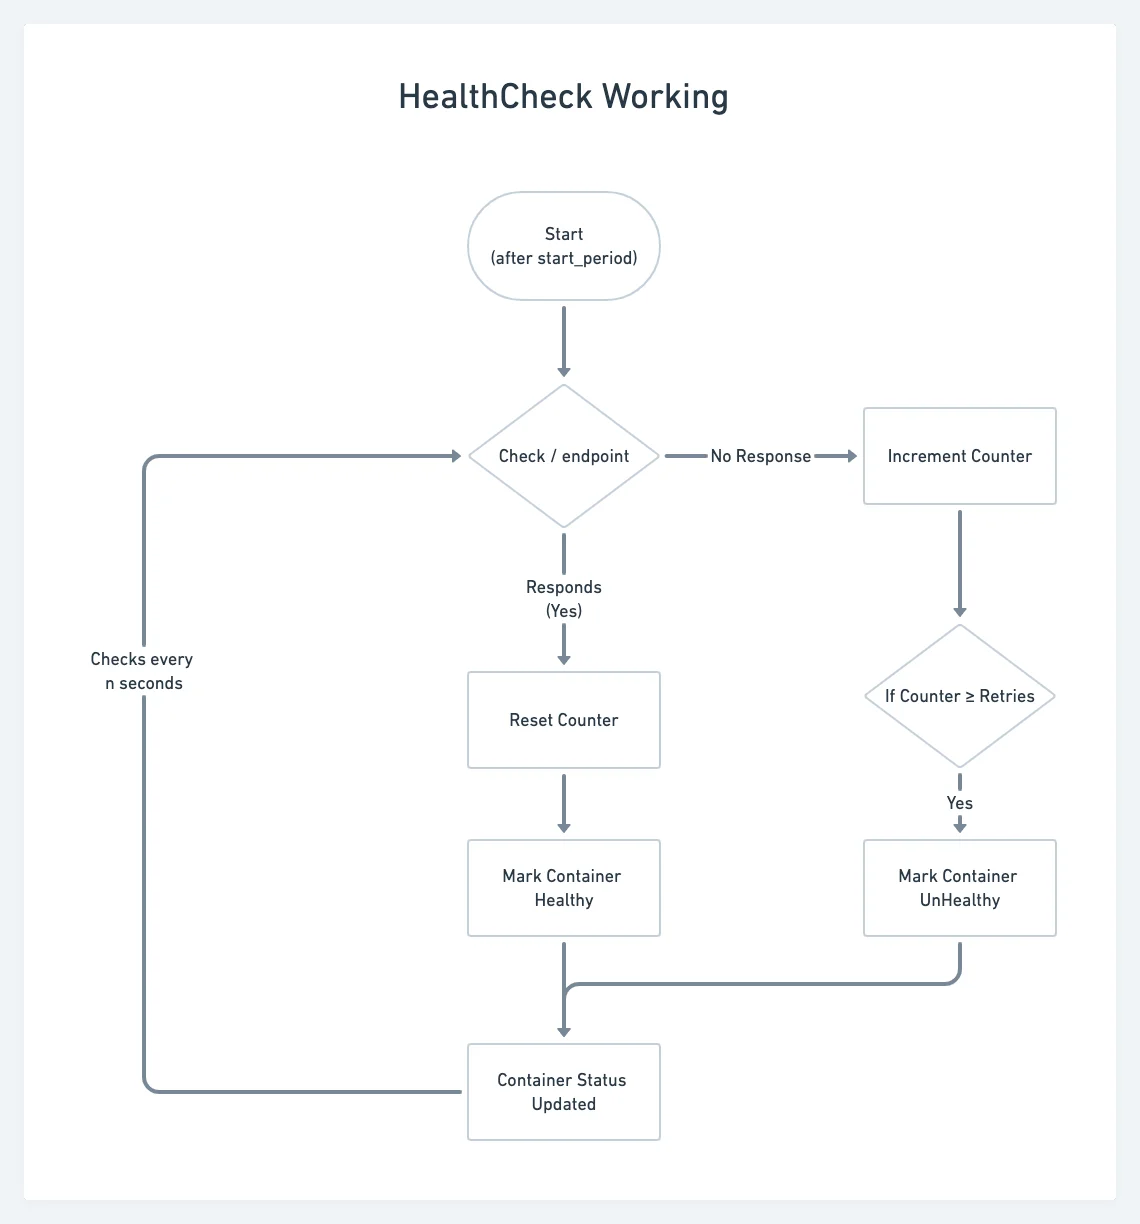
理解 depends_on 的启动依赖机制
在 Docker Compose 中,depends_on 指令用于定义服务之间的启动依赖关系。默认情况下,它仅控制容器的创建与启动顺序,即被依赖的服务会优先启动,但并不会等待该服务内部的进程真正就绪。例如,当 Web 应用依赖 MySQL 数据库时,仅配置 depends_on: [db] 只能保证 MySQL 容器先于应用容器拉起,而数据库进程初始化、加载数据目录并监听端口通常需要数秒至数十秒。在此期间,若应用容器立即尝试建立连接,必然因端口未开放或认证未就绪而报错退出。因此,传统的 depends_on 仅解决了“谁先跑”的问题,无法解决“何时可用”的问题。引入健康检查依赖机制,正是为了弥补这一缺陷,确保下游服务在真正具备服务能力后再启动上游依赖,从而提升系统启动的稳定性与可预测性。
为依赖服务配置 healthcheck 健康检查
要让 Docker 准确感知服务是否就绪,必须在被依赖的服务中配置 healthcheck 指令。该配置通常包含 test、interval、timeout、retries 和 start_period 五个核心参数。以 MySQL 为例,test 可设置为 ["CMD", "mysqladmin", "ping", "-h", "localhost"],通过执行系统命令探测数据库响应;interval 定义检查间隔(如 10s),timeout 设定单次探测超时时间(如 5s),retries 指定连续失败次数阈值(如 3次)。特别需要注意的是 start_period,它用于为服务初始化预留缓冲期,在此期间内的失败不会计入重试次数,避免容器因启动慢被误判为不健康。配置完成后,Docker 守护进程会按周期执行探测命令,若返回状态码为 0 则标记为 healthy,否则标记为 unhealthy,为后续的依赖调度提供状态依据。

使用 condition 实现健康状态依赖
在 Compose 规范中,通过为 depends_on 添加 condition 参数,即可实现基于健康状态的精确依赖控制。具体语法要求将依赖项声明为映射结构,并指定 condition: service_healthy。例如,在应用服务配置中写入:
``yaml
services:
web:
depends_on:
db:
condition: service_healthy
`
Docker Compose 在编排启动时,会先拉起数据库容器,随后持续监听其健康检查状态。只有当数据库容器状态由 starting 转变为 healthy 后,Compose 才会触发应用容器的创建与启动流程。该机制彻底改变了“启动即连接”的脆弱模式,将依赖判断从“进程存在”升级为“服务可用”。在实际编写 docker-compose.yml` 时,需确保 Compose 版本兼容(推荐 v2.20+ 或 v3 规范),并严格遵循 YAML 缩进规则,否则会导致解析失败或条件失效。
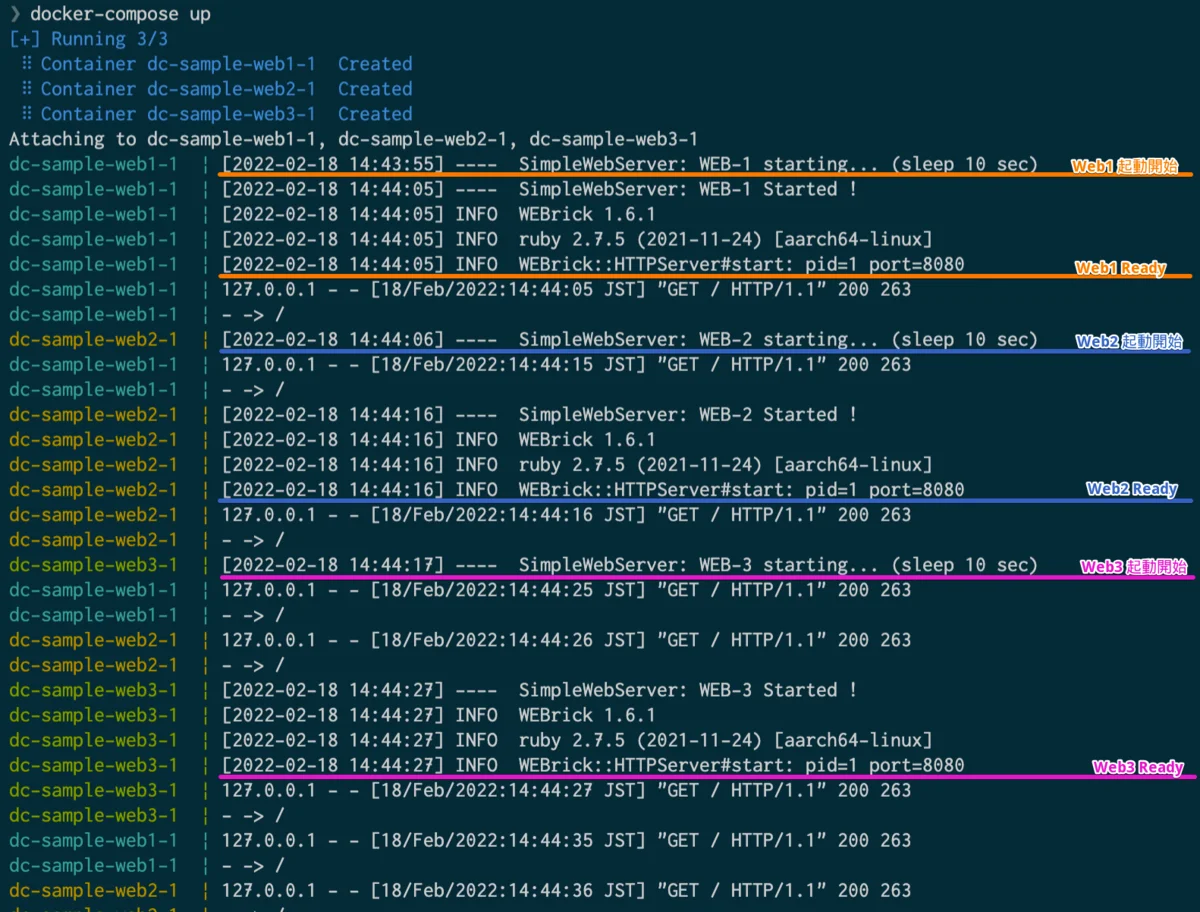
启动验证与健康状态排查
配置完成后,需通过标准命令验证依赖链路是否按预期执行。首先运行 docker compose up -d 启动编排,随后执行 docker compose ps 查看输出列表,重点关注 STATE 列是否显示 healthy 或 starting。若需深入排查,可使用 docker inspect <容器名> --format='{{.State.Health.Status}}' 获取精确状态,或通过 docker inspect <容器名> --format='{{json .State.Health}}' 查看完整的探测日志与失败原因。当容器长期卡在 starting 状态时,通常意味着健康检查命令执行失败或网络不通,此时应结合 docker compose logs <服务名> 检查应用日志,确认 test 命令路径是否正确、权限是否充足、端口是否被防火墙拦截。通过交叉比对状态输出与运行日志,可快速定位是配置错误还是服务本身异常。

常见坑点与生产环境实践
在实际落地中,开发者常陷入“服务启动即等于服务可用”的认知误区。典型坑点包括:忽略 start_period 导致初始化阶段频繁触发重试并误判失败;健康检查命令依赖外部网络或特权权限,在受限容器中无法执行;以及过度依赖 depends_on 而忽略应用层自身的重试与熔断机制。生产环境中,建议将 healthcheck 与业务探针结合,例如 Web 服务应探测 /health 接口而非仅检查 TCP 端口连通性。同时,应用代码必须实现指数退避重试逻辑,以应对健康检查通过瞬间的瞬时高并发连接。对于复杂微服务架构,可引入就绪探针与存活探针分离策略,并配合服务网格或配置中心实现动态依赖发现,从而构建高可用、可观测的容器化部署体系。