从GIL对CPU密集型多线程的影响入手,结合进程并行、异步IO和任务拆分等方案,说明如何选择合适的并发模型,并通过基准测试验证性能改善,同时避开进程开销、数据共享和并发安全等常见问题。
先定位瓶颈:确认GIL是否限制了多线程性能
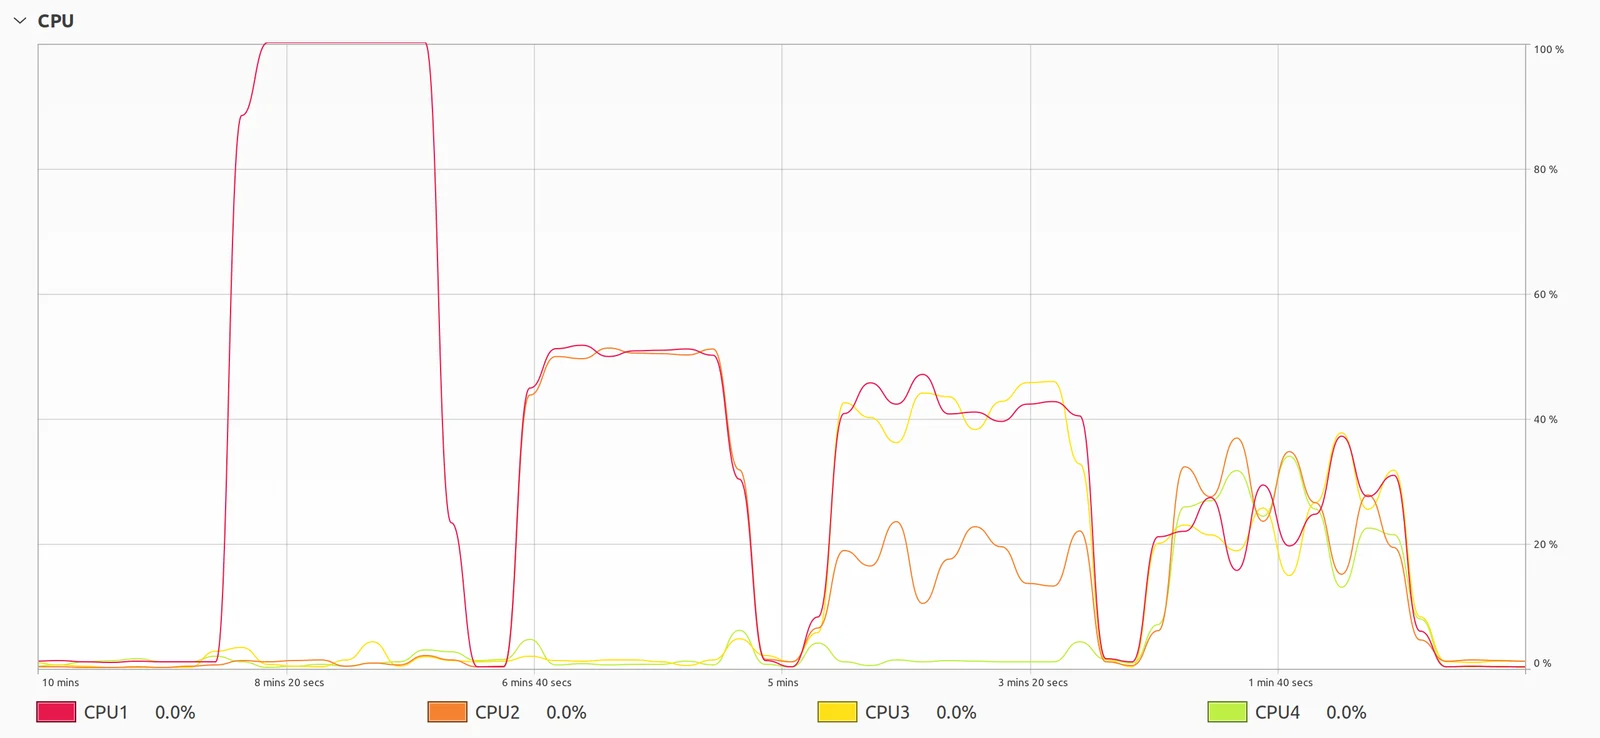
在Python中遇到多线程性能未达预期时,首要任务是确认瓶颈是否真正来自全局解释器锁(GIL)。GIL是CPython解释器层面的互斥锁,它保证同一时刻只有一个线程执行Python字节码。对于CPU密集型任务(如大规模数值计算、图像处理或复杂循环),多线程不仅无法利用多核CPU,反而会因为频繁的线程上下文切换和锁竞争导致性能下降。可以通过编写一个简单的CPU密集型函数(例如计算斐波那契数列或进行矩阵乘法),分别使用单线程和threading模块的多线程执行,并借助psutil或系统监控工具观察CPU利用率。若发现多线程运行时CPU总利用率远低于核心数上限,且各线程的CPU时间片呈现交替占用而非并行累加,即可判定GIL已构成限制。此时应停止盲目增加线程数,转而评估任务类型以选择更合适的并发模型。
CPU密集型任务改用多进程:绕开GIL实现并行计算
当确认任务属于CPU密集型且受GIL制约时,最直接的解决方案是改用多进程模型。Python的multiprocessing模块或concurrent.futures.ProcessPoolExecutor会为每个任务创建独立的Python解释器进程,每个进程拥有独立的内存空间和GIL,从而真正实现跨核并行计算。实际操作中,可通过ProcessPoolExecutor(max_workers=os.cpu_count())提交计算任务,利用map或submit分发工作。需要注意的是,进程间通信(IPC)依赖序列化(如pickle),会带来额外的内存与时间开销。因此,在拆分任务时应尽量保证每个子任务具有足够的计算粒度,避免“任务过碎”导致序列化与进程调度开销抵消并行收益。对于需要共享大量中间状态的场景,可结合multiprocessing.shared_memory或内存映射文件来降低数据拷贝成本,确保并行效率最大化。
IO密集型任务用异步或多线程:不要把所有问题归因于GIL
并非所有并发性能问题都源于GIL,IO密集型任务(如网络请求、数据库查询、文件读写)的瓶颈通常在于外部设备的响应延迟。在IO操作期间,Python解释器会自动释放GIL,允许其他线程或协程继续执行,因此多线程或异步IO在此类场景下表现优异。推荐使用asyncio配合aiohttp或httpx处理高并发网络请求,或使用concurrent.futures.ThreadPoolExecutor处理阻塞型文件IO。以异步模型为例,通过async def定义协程并使用asyncio.gather批量调度,可以在单线程事件循环中实现数万级并发连接,而无需承担多线程的上下文切换开销。关键在于识别任务的等待属性:若代码大部分时间处于sleep、recv或read状态,应优先选择异步或多线程,而非强行引入多进程,以免徒增系统资源消耗。

实测与优化:比较并发方案并避开常见性能陷阱
在实际工程中,必须通过基准测试量化不同并发模型的表现,并针对性地规避常见陷阱。可使用timeit或cProfile记录单线程、多线程、多进程与异步方案的执行耗时与内存占用。测试时需严格控制变量,确保任务输入一致。常见性能陷阱包括:多进程场景下频繁传递大型字典或DataFrame导致的序列化延迟;多线程中未使用线程安全数据结构(如queue.Queue)引发的竞态条件;以及异步代码中混入阻塞调用(如requests.get)导致事件循环卡死。优化策略应聚焦于任务粒度调整:将大任务拆分为独立子任务以减少IPC频率,使用multiprocessing.Array或Manager替代全局变量共享,并在异步流中严格使用非阻塞库。通过持续监控与压测迭代,才能在并发安全与执行效率之间取得最佳平衡。