
面对海量 Python 习题,直接复制代码往往掩盖了逻辑缺陷。本文从解析深度、获取渠道、运行验证及常见陷阱四个维度,梳理如何筛选真正包含解题思路的答案,并通过实际运行与边界测试确保代码健壮性,帮助学习者从“看懂结果”转向“掌握原理”。
先判断习题答案是否真正带有详细解析
在查找 Python 习题答案时,首要任务是建立严格的筛选标准,辨别答案是否真正“带详细解析”。一份优质的解析不应仅停留在提供最终代码,而必须包含完整的解题思路拆解、逐行代码实现说明、预期运行结果展示、关键语法或内置函数的原理解释,以及常见错误原因的排查指导。例如,针对“列表去重”题目,合格的答案会先说明使用集合(set)或字典键的特性,接着给出list(dict.fromkeys(original_list))的代码,并解释为何该方法能保持原有顺序,同时对比list(set(original_list))可能打乱顺序的缺陷。只有具备这些维度的内容,才能帮助学习者理解底层逻辑,而非机械记忆。
从教材、课程平台和在线题库寻找解析答案
获取高质量解析的渠道主要分为四类,各自适配不同学习阶段。官方教材配套习题通常附带详尽的课后解答手册,适合初学者打牢基础语法;在线编程平台如LeetCode、牛客网或Codecademy提供交互式环境,其官方题解区往往包含多语言对比与时间空间复杂度分析,适合进阶刷题;Python官方文档及Real Python、GeeksforGeeks等学习网站侧重原理讲解,适合查漏补缺;GitHub上的开源题库(如Python-100-Days)则提供社区维护的实战项目解析,适合有一定基础后拓展应用。使用时建议按“教材打基础→平台练算法→开源做项目”的路径递进,避免跨阶段盲目搜索导致知识断层。
用代码运行验证答案,而不是直接照抄
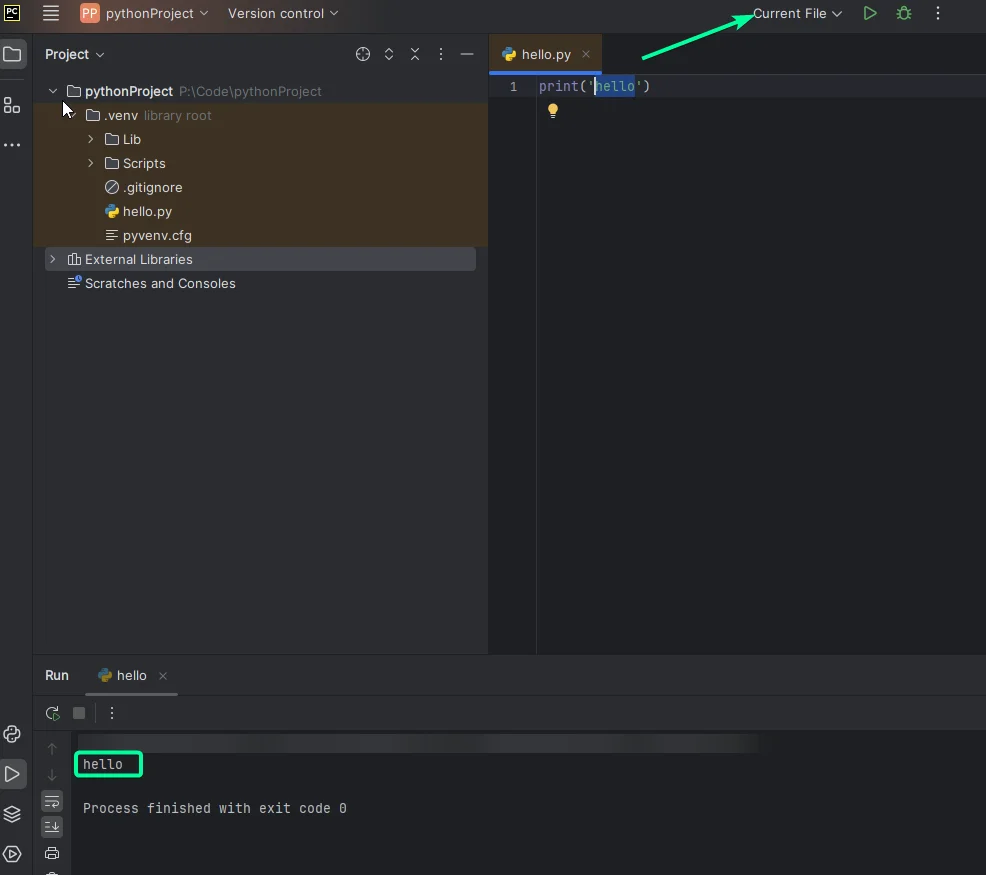
获取参考答案后,切忌直接复制粘贴,必须通过实际运行进行验证。具体操作是:将答案代码粘贴至本地IDE(如PyCharm、VS Code)或交互式解释器(Jupyter Notebook、IPython)中,首先检查基础用例是否通过,随后主动构造边界条件进行测试。例如,若习题要求编写计算阶乘的函数,除输入正整数外,还应测试输入0、负数或非整数类型时的程序表现。通过观察控制台输出的Traceback信息或断言结果,可以反向推导代码的健壮性。若答案未处理异常,可自行补充try-except块或类型检查,这一过程能强制大脑从“看懂”转向“理解”,真正掌握代码成立的逻辑链条。
避开只给最终代码、答案错误和版本不兼容的坑
在搜集习题答案时,学习者常陷入三大陷阱:一是仅提供最终代码而无推导过程,导致知其然不知其所以然;二是社区搬运的答案存在逻辑漏洞或硬编码,直接运行会引发隐蔽Bug;三是代码基于Python 2.x编写,在Python 3环境下因print语法、整数除法或字符串编码差异直接报错。规避这些问题的核心在于交叉核验与版本确认。遇到可疑答案时,应查阅官方文档确认API变更,使用sys.version检查运行环境,并通过单元测试框架(如unittest或pytest)编写多组断言用例。若发现答案在特定版本失效,可借助2to3工具转换或手动替换废弃模块,确保代码的现代性与正确性。


