
游乐游手机版
首页/编程语言/文章详情

Excel 数据建模实战:从导入清洗到关系验证

时间:2026-09-30 14:45
本文以实际业务场景为例,演示如何从外部数据源导入并清洗数据,利用 Power Pivot 建立表间关联,并通过数据透视表验证模型准确性。重点讲解一对多关系的构建逻辑、常见报错排查及字段规范,帮助读者掌握 Excel 数据模型的核心操作与避坑指南。

本文以实际业务场景为例,演示如何从外部数据源导入并清洗数据,利用 Power Pivot 建立表间关联,并通过数据透视表验证模型准确性。重点讲解一对多关系的构建逻辑、常见报错排查及字段规范,帮助读者掌握 Excel 数据模型的核心操作与避坑指南。

为什么需要数据模型:告别宽表的冗余与低效

在 Excel 中处理复杂业务数据时,新手常倾向于将所有信息合并到一张巨大的“宽表”中。这种做法虽然直观,但随着数据量增加,会引发严重的性能瓶颈和维护困难。Excel 数据模型(Data Model)提供了一种更底层的架构:它允许在内存中存储多张独立的表,并通过逻辑关系将它们连接起来。

数据模型的核心概念包括: 1. **数据表**:结构化的二维记录集合。 2. **字段**:表中的列,描述特定属性。 3. **主键**:唯一标识每一行记录的字段。 4. **关系**:通过主键与外键连接不同表的桥梁。 当业务涉及多个维度(如客户、订单、产品)且需交叉统计时,数据模型能保持各表独立性,通过动态关联提升处理效率。
展示办公人员在Excel中分析多张业务数据表的真实场景,电脑屏幕同时呈现客户表、订单表、产品表等数据,并体现多表关联分析的概念。
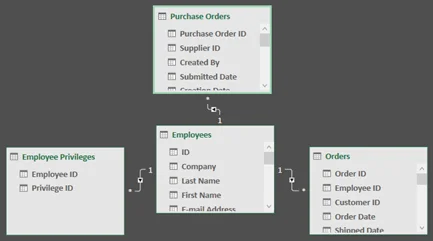
Excel Power Pivot 中展示采购订单、员工和权限等多张表及其关联关系,直观体现数据模型的表间连接。

数据导入与清洗:Power Query 的关键作用

构建数据模型的第一步是将外部数据加载到 Excel。推荐使用“数据”选项卡下的“获取数据”功能,支持从工作簿或 CSV 文件导入。在导入前,务必在源文件中清理空行、合并单元格及重复表头,否则会导致加载失败或字段错位。

进入 Power Query 编辑器后,系统会自动预览数据。此时需执行以下操作: - **检查字段类型**:将文本型日期转换为日期格式,将金额转为十进制数。 - **确认列标题**:确保首行已正确识别为列标题。 - **加载策略**:点击“关闭并上载至”,选择“仅创建连接”并勾选“将此数据添加到数据模型”。 该方式不会占用工作表空间,而是将清洗后的数据直接驻留于内存模型中,为后续关联分析奠定基础。
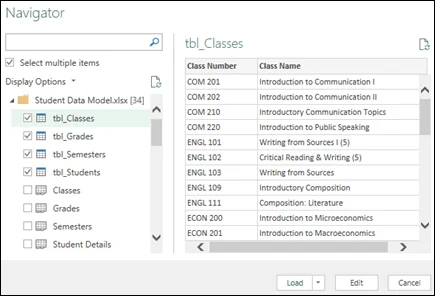
展示用户通过Excel获取外部数据并导入工作簿的真实操作界面,数据预览区域包含规范的字段和记录。
Excel 导入数据时的 Navigator 数据预览界面,可选择工作簿中的表并加载到 Excel。

建立表间关系:理解“一对多”的核心逻辑

当多张数据表成功加载至数据模型后,需进入 Power Pivot 的“关系图视图”进行关联配置。建立关系的核心原则是“一对多”(One-to-Many): - **主表(维度表)**:关联字段必须保持唯一,通常存放静态属性(如客户信息、产品规格)。 - **明细表(事实表)**:对应字段允许重复,记录动态流水(如订单记录、考勤打卡)。 例如,客户表中的“客户ID”作为主键具有唯一性,属于主表;订单表中的“客户ID”用于记录每笔交易,属于明细表。在关系图视图中,将主表的唯一键拖拽至明细表的关联字段上,系统会自动生成一条连接线。

正确识别主表与明细表并建立单向一对多关系,是确保后续聚合计算准确的前提。若关系建反或为多对多,将导致统计结果异常。
展示Excel数据模型关系视图,多张业务数据表通过客户ID、产品ID等字段连接,直观体现表与表之间的关系。
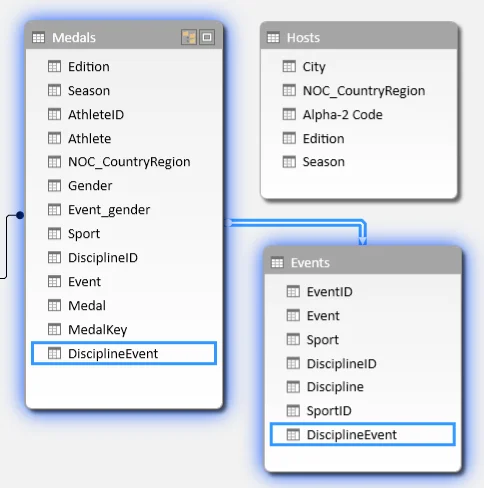
Power Pivot Diagram View 展示 Events 与 Medals 表通过 DisciplineEvent 字段建立关系。

模型验证:通过透视表检查关联准确性

模型搭建完成后,必须通过数据透视表进行交叉验证。插入透视表时,数据源需选择“使用此工作簿的数据模型”。在字段列表中,尝试将主表的维度字段(如客户名称)拖入行区域,将明细表的数值字段(如订单金额)拖入值区域。

若关联正确,透视表将自动按客户汇总订单总额。若发现统计结果异常,可依据以下现象排查: - **结果偏大**:通常意味着明细表存在重复记录或关系方向建反。 - **大量“空白”分类**:说明明细表中存在主表未包含的外键值。 排查时,应优先检查关系图视图中的连线箭头方向(必须从“一”指向“多”),并核对两表关联字段的基数,必要时返回 Power Query 清洗异常数据。

展示Excel数据模型创建完成后使用数据透视表进行汇总分析的真实场景,包含订单、客户和销售额等字段及正常统计结果。
Excel 数据模型生成透视表后的汇总分析结果,可用于检查不同表之间的关联是否正常。

常见避坑指南:类型、唯一性与方向

初学者在维护数据模型时极易遭遇几类典型错误,日常检查应遵循“先查类型、再验唯一、后看方向”的原则: 1. **字段类型不一致**:例如主表 ID 为文本格式而明细表 ID 为数值格式,这将直接导致关系无法建立,必须在 Power Query 中统一类型。 2. **主表键值重复**:若维度表出现重复 ID,系统会拒绝创建一对多关系,需通过“删除重复项”功能清理。 3. **空值处理**:关联字段若包含空值,透视表会将其归类为“(空白)”,影响统计口径,建议提前填充默认值或过滤。 4. **命名规范**:字段命名混乱(如“客户编号”与“Cust_ID”)会增加维护成本,应建立标准化命名规范。 5. **严禁多对多**:除非明确使用桥接表,否则随意建立多对多关系会导致笛卡尔积爆炸。
展示Excel数据模型排错场景,用户对比两张表中的字段类型、重复ID和空值,电脑屏幕体现数据关系异常排查过程。
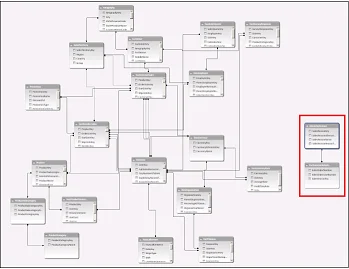
Power Pivot 关系图展示存在断开连接的表,可用于排查键值、字段匹配和数据关系异常。
来源:workshop:f779c56ccf6542bbb92c8a870657a4f9:site:2
上一篇PyCharm 环境搭建实战:从版本选型到脚本验证 下一篇Matplotlib与Pyplot:从接口混淆到正确选型
本站内容用于信息整理与展示,如有侵权或内容问题请及时联系处理。

相关推荐

补充同频道和同主题内容,方便继续浏览更多相关内容。

同类最新

继续查看同栏目最近更新的文章。

更多
Python应用打包与部署入门教程:核心概念、操作步骤与结果验证
编程语言 · 2026-10-01

Python应用打包与部署入门教程:核心概念、操作步骤与结果验证

从 Python 应用打包的基本概念入手,介绍项目环境准备、依赖管理、构建发布包、安装部署以及运行结果验证,并梳理常见打包失败与部署问题,帮助初学者完成从源码到可部署应用的完整流程。

Python CLI 开发避坑指南:从环境配置到参数解析的实战排查
编程语言 · 2026-10-01

Python CLI 开发避坑指南:从环境配置到参数解析的实战排查

本文聚焦 Python 命令行工具(CLI)开发中最高频的故障点,按执行链路梳理从环境配置、参数解析、路径处理到异常调试的完整排查流程。通过具体代码示例与终端输出对照,提供可复现的修复方案,帮助开发者快速定位 ModuleNotFoundError、参数校验失败及跨平台兼容性问题,构建更健壮的命令行

Python CLI 开发:从参数解析到工程化发布的完整路径
编程语言 · 2026-10-01

Python CLI 开发:从参数解析到工程化发布的完整路径

本文以 Python 命令行工具开发为切入点,从项目结构搭建与虚拟环境配置入手,深入讲解 argparse 参数解析与子命令设计。通过一个完整的日志分析工具案例,演示输入校验、错误处理与异常捕获的最佳实践,最后覆盖打包发布流程与常见排查技巧,帮助开发者构建健壮、易用的 CLI 应用。

Python 模块与包的工程化实践:结构、依赖与排错指南
编程语言 · 2026-10-01

Python 模块与包的工程化实践:结构、依赖与排错指南

本文从项目目录规范与模块导入机制切入,详细阐述虚拟环境的配置、第三方包的管理策略以及完整案例的模块化拆分方法。通过具体代码示例展示如何构建高内聚低耦合的代码结构,并针对 ModuleNotFoundError、ImportError 及依赖冲突等常见工程问题提供系统化的排查与解决方案,帮助开发者建立

Python 函数参数与返回值:从环境搭建到实战避坑
编程语言 · 2026-10-01

Python 函数参数与返回值:从环境搭建到实战避坑

本文从搭建 Python 运行环境入手,详细解析函数定义、参数传递机制及返回值处理。通过电商订单计算的完整案例,展示如何模块化组织业务逻辑,并针对参数数量、作用域及返回值缺失等常见错误提供排查方案,帮助开发者写出健壮且可维护的代码。