
列表推导式适合把“遍历、筛选、生成新值”写成一段清楚的表达式。读法是先看 for 和 if 决定取哪些元素,再看最前面的表达式决定输出什么;嵌套展开时,for 的顺序与普通循环保持一致。
从一个普通循环改写
如果原循环只是把符合条件的值处理后加入列表,可以改为推导式。需要多步日志、异常处理或复杂分支时,保留普通循环往往更容易维护。
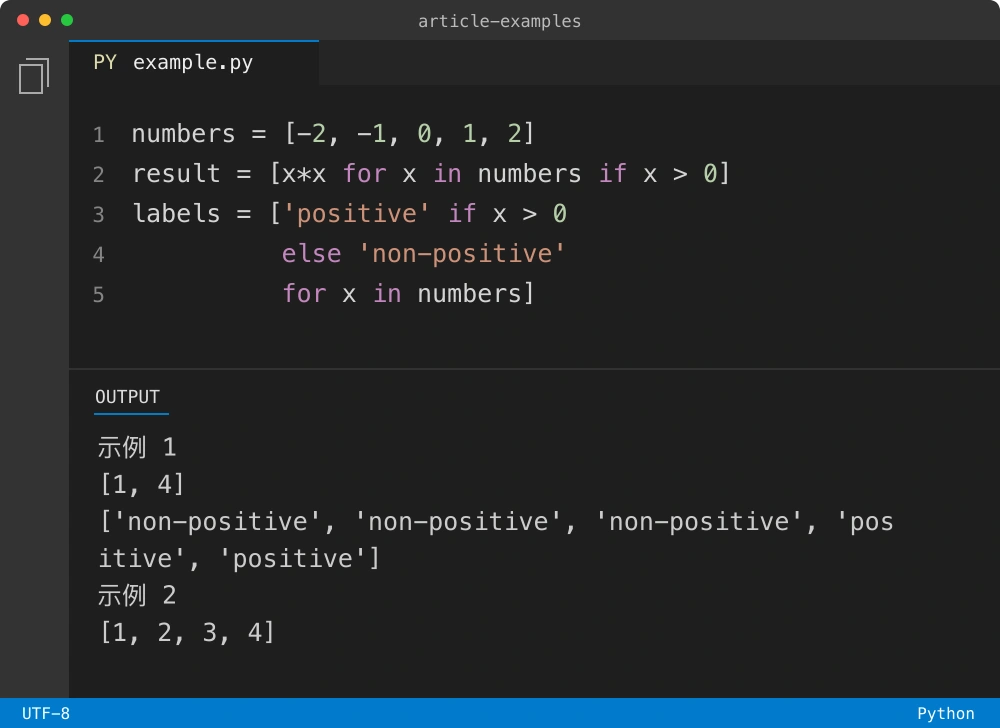
numbers = [-2, -1, 0, 1, 2]
result = [x * x for x in numbers if x > 0]
assert result == [1, 4]
print(result)
labels = ['positive' if x > 0 else 'non-positive' for x in numbers]
assert len(labels) == len(numbers)
print(labels)
第一个列表只保留正数;第二个列表为每个输入生成标签,不会减少元素数量。两者的 if 位置不同,含义也不同。
先写普通循环,再决定是否压缩
初学时可以把需求拆成三句话:从哪里取元素,什么条件下保留,保留后生成什么。对应到本例,输入是 numbers,只保留大于零的数,输出这些数的平方。将这三件事说清楚之后,推导式最前面的 x * x 就不再像一个需要先执行的步骤,它是每轮最终放进结果列表的值。
排查结果不符时,不必反复调整一整行表达式。先暂时移除过滤条件,确认遍历到的输入;再加入条件,确认剩下哪些元素;最后恢复转换表达式,确认输出值。对空列表、全部被过滤、恰好包含零这几种输入各测一次,可以快速暴露条件边界写错的问题。
嵌套展开时按循环顺序阅读
matrix = [[1, 2], [3, 4]]
flat = [value for row in matrix for value in row]
assert flat == [1, 2, 3, 4]
print(flat)
expanded = []
for row in matrix:
    for value in row:
        expanded.append(value)
assert flat == expanded
先取一行,再遍历这一行。若交换两个 for,就改变了变量可用范围与遍历逻辑。遇到难懂的推导式,先展开成普通循环检查。
过滤元素和选择值为何不能混写
末尾的 if x > 0 决定当前元素要不要进入结果,所以列表长度可能减少。表达式中的 positive if ... else ... 决定进入结果的值是什么,只要没有另外的过滤条件,每个输入都会对应一个输出。因此本例中平方列表有两项,而标签列表仍有五项。
选择写法时,先问业务是否需要保留位置对应关系。如果后面还要把标签与原始记录逐项配对,就不能因为某条记录不满足条件而直接把它删掉;如果业务只需要符合条件的记录,则没有必要给其他记录生成占位标签。两种表达式都能运行,但它们表达的数据契约不同。
别让简短代码隐藏额外成本
- 列表推导式会构造整个列表;大输入只需逐个处理时可考虑生成器表达式。
- 不要用推导式单纯执行副作用,例如批量写文件而丢弃生成的列表。
- 多层嵌套或过长条件应拆开,让筛选条件和转换规则可以分别测试。
用嵌套循环解释展开顺序
对于 matrix,外层循环先获得第一行 [1, 2],内层循环把 1、2 依次放入结果;然后再处理第二行 [3, 4]。结果为 [1, 2, 3, 4]。这种展开并不要求每行长度相同:空行不产生元素,不同行按自身顺序贡献元素。
如果目标是按列读取矩阵,就不能把这里的展开当成转置。应重新确定索引关系和不等长行的处理规则。推导式里的多个 for 是嵌套遍历,不能仅凭看起来简短就认为它比普通循环更适合所有二维数据。
最终保留哪种写法,应以维护成本判断。单次筛选和映射适合推导式;需要记录跳过原因、捕获每条数据的异常或执行多步变换时,普通循环更方便调试。数据量大时,还要判断后续是否真的需要完整列表,避免为了遍历一次就提前构造全部结果。


