
MongoDB采用灵活的文档存储机制,无需预先定义表结构即可插入数据。面对复杂业务时,开发者常需在嵌入式与规范化模型之间做出权衡。本文将梳理核心设计原则,对比两种模型的实现差异,并通过博客系统案例提供可落地的架构判断依据。
数据模型设计核心原则
MongoDB提供嵌入式数据模型和规范化数据模型两种设计方式。在实际项目中,模型选择应围绕具体业务需求展开,并遵循以下原则:
- 根据项目需求选择合适的设计模式,避免盲目套用单一方案。
- 若数据通常被同时访问,应将其合并到同一文档中;若访问模式独立,则拆分为多个文档。
- 允许适当的数据冗余,因为相比计算时间,磁盘存储成本更低。
- 针对最常用的查询用例优化模型结构,减少运行时开销。
- 优先在写入阶段完成数据连接与聚合,而非在读取时执行。
- 在模型层面支持复杂聚合操作,提升查询效率。
嵌入式数据模型实现与适用场景
嵌入式数据模型(也称非规范化模型)将高度关联的数据整合到单个文档中。例如,将员工的个人信息、联系方式和地址合并存储:
{
  _id: ObjectId("601f4be6e646844cd045c8a4"),
  Emp_ID: "10025AE336",
  Personal_details: {
    First_Name: "Radhika",
    Last_Name: "Sharma",
    Date_Of_Birth: "1995-09-26"
  },
  Contact: {
    e-mail: "biancheng.net@gmail.com",
    phone: "9848022338"
  },
  Address: {
    city: "Hyderabad",
    Area: "Madapur",
    State: "Telangana"
  }
}
该模型适合数据访问模式固定、关联数据需一次性读取的场景。通过减少跨文档查询,可显著提升读取性能,但需注意文档大小限制(MongoDB默认单文档上限为16MB)。
规范化数据模型实现与适用场景
规范化数据模型通过引用(Reference)将主文档与子文档关联,避免数据重复。上述员工信息可拆分为以下独立文档:
Employee 文档:
{
  _id: ObjectId("601f4be6e646844cd045c8a4"),
  Emp_ID: "10025AE336"
}
Personal_details 文档:
{
  _id: ObjectId("601f50bae646844cd045c8a5"),
  empDocID: ObjectId("601f4be6e646844cd045c8a4"),
  First_Name: "Radhika",
  Last_Name: "Sharma",
  Date_Of_Birth: "1995-09-26"
}
Contact 文档:
{
  _id: ObjectId("601f50bae646844cd045c8a6"),
  empDocID: ObjectId("601f4be6e646844cd045c8a4"),
  e-mail: "biancheng.net@gmail.com",
  phone: "9848022338"
}
Address 文档:
{
  _id: ObjectId("601f50bae646844cd045c8a7"),
  empDocID: ObjectId("601f4be6e646844cd045c8a4"),
  city: "Hyderabad",
  Area: "Madapur",
  State: "Telangana"
}
规范化模型适用于数据更新频繁、关联关系复杂或存在多对多关系的场景。通过引用关联,可避免数据冗余带来的更新异常,但读取时需通过聚合管道(如 $lookup)执行连接操作,会增加查询复杂度与延迟。
博客系统架构对比案例
假设需设计一个博客数据库,需求如下:
- 每个帖子包含唯一标题、描述和网址。
- 每个帖子可关联一个或多个标签。
- 每个帖子记录发布者名称和点赞数。
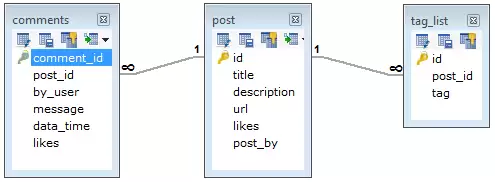
- 每个帖子可包含零个或多个评论,评论包含用户名、内容、创建时间和点赞数。
在关系型数据库中,该需求至少需要创建三个表(帖子表、标签关联表、评论表),并通过外键维护关系,架构示意图如下:
在MongoDB中,可直接使用单个集合实现相同功能,将标签数组与评论子文档嵌入主帖子文档:
{
  _id: POST_ID,
  title: TITLE_OF_POST,
  description: POST_DESCRIPTION,
  by: POST_BY,
  url: URL_OF_POST,
  tags: [TAG1, TAG2, TAG3],
  likes: TOTAL_LIKES,
  comments: [
    {
      user: 'COMMENT_BY',
      message: TEXT,
      dateCreated: DATE_TIME,
      like: LIKES
    },
    {
      user: 'COMMENT_BY',
      message: TEXT,
      dateCreated: DATE_TIME,
      like: LIKES
    }
  ]
}
该设计将高频读取的帖子详情、标签与评论集中存储,一次查询即可返回完整内容。若评论数量可能无限增长或需独立高频更新,则应改用规范化模型,将评论拆分为独立集合并通过帖子ID引用。


