
“当AI原生设备成为Agent新物种的主力终端,底层算力体系也在加速重构。”
把一台能够运行122B大模型的AI主机装进口袋,究竟需要付出怎样的代价?
过去大半年,端侧AI硬件的发展逻辑正在明显变化。
两个月前,国内掀起了一场现象级的本地部署Agent热潮,大量AI爱好者开始“养虾”,让原本相对小众的Mac mini意外走红,一度出现溢价和缺货。在更硬核的开发者圈层中,售价三四万元的英伟达DGX Spark同样热度不减,因为它已经具备本地运行千亿参数模型的能力。
Mac mini和DGX Spark同时爆火,背后其实指向同一个趋势:Agent正在快速抬高端侧AI硬件的入门门槛。
此前,40TOPS级别的AI PC通常只能完成对话、内容生成等轻量级任务。但进入Agent时代后,开发者开始追求更大的本地大模型、更长时间的本地推理,以及真正能够承担生产力任务的端侧AI设备。
问题也随之而来。Mac mini足够安静、低功耗,但很难支撑更大的本地模型;DGX Spark虽然性能强悍,但在价格、功耗和散热方面,又难以真正走向大众化。大算力、低功耗与小体积之间,似乎始终难以同时兼得。
Agent时代真正缺少的,已经不只是一台更强的AI PC,而是一种能够7×24小时稳定运行、低功耗、安静,并具备本地执行能力的新型终端。
于是,一种介于AI PC与AI工作站之间的Agent Computer开始出现。最近发布的联想AI主机P7,就是这样一款仅300克、30W功耗,却拥有190TOPS端侧AI算力,并能在本地运行122B参数模型的设备。
AI 2.0时代,需要怎样的Agent Computer?
传统AI更多还是一问一答式交互,任务结束后,模型也会停止运行。但Agent不同,它需要长期在线、持续调用模型、自主拆解任务,并在本地完成记忆、推理、执行等完整流程。
这意味着,Agent设备比拼的已不再只是瞬时峰值性能,而是长期稳定运行的综合能力。
换句话说,AI 2.0时代真正需要的,并不是AI PC的简单升级版,而是一种介于AI PC与AI工作站之间的新终端。它既要具备本地运行大模型的能力,又必须兼顾低功耗、静音、小体积,以及7×24小时持续工作的稳定性。
联想AI主机P7,正是在AI 2.0需求驱动下诞生的Agent Computer新物种。它既尝试接近DGX Spark的大模型生产力能力,又保留了类似Mac mini的低功耗与静音优势。
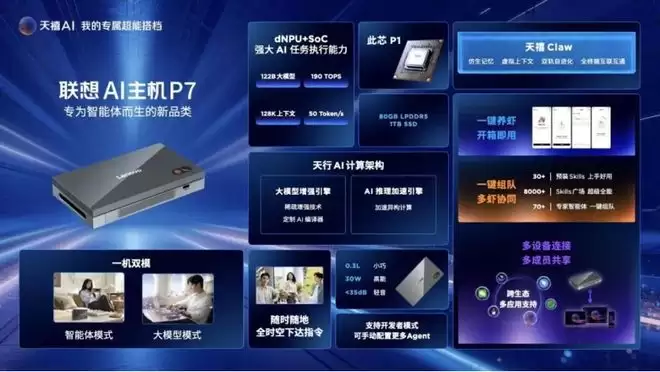
P7拥有190TOPS异构AI算力(dNPU+SoC),其中160TOPS来自后摩漫界M50 dNPU,30TOPS来自此芯P1 SoC。整机最高支持122B参数模型本地部署,最高可配置80GB RAM,并支持128K上下文窗口。
在无网环境下,P7本地自主推理速度最高可达50 Tokens/s,可实现7×24小时连续执行Agent任务。
围绕Agent长期在线的需求,P7机身只有手掌大小,重量约300克,甚至可以直接通过充电宝供电运行。为了在小体积下实现持续稳定运行,P7还将整机功耗控制在30W以内,并把运行噪音压低至35分贝以下。
这意味着,联想AI主机P7已经开始真正具备本地AI生产力价值。
更重要的是,与传统PC+AI的思路不同,P7并不是在原有设备中简单增加AI功能,而是围绕Agent场景重新定义终端逻辑。
例如,P7采用了一机双模设计:在智能体模式下,本地运行天禧Claw,将复杂任务尽可能留在本地执行;在大模型模式下,则通过开放API Key接入各类AI应用与智能体,直接承担本地推理与Token生成能力。
P7的推出,代表着过去只有高功耗工作站才能承担的大模型本地推理能力,开始有机会进入更低功耗、更低成本的小型AI设备。
而只有当大模型推理能够在低功耗、小体积条件下长期运行,Agent才有可能真正从少数开发者设备,逐步走向更广泛的消费级终端与行业场景。
支撑这种Agent Computer形态成立的,是P7背后一套不同于传统GPU路线的新型算力方案。
千亿模型装进口袋之后,算力逻辑也变了
联想在P7立项初期就已经明确,要做一台能放进口袋、又能本地运行大模型的AI主机。这意味着,它的芯片必须同时满足三个几乎互相制约的条件:大算力、低功耗、小体积。
传统AI芯片很难同时兼顾这些需求,核心问题在于数据搬运——计算单元与存储单元物理分离,数据需要在两者之间频繁流动,从而带来额外能耗与延迟。
AI芯片行业因此不断探索新的架构路径,其中一个正被越来越多厂商重视的方向,就是存算一体。存算一体让数据在存储侧就近完成计算,从而减少搬运开销,提升整体能效表现。
联想选择引入存算一体架构芯片,作为P7的主要AI算力来源,也就是dNPU(Discrete NPU)。它类似于独立GPU的定位,但拥有更强的端侧AI性能。
这颗dNPU,正是后摩智能在2025年推出的存算一体AI芯片——后摩漫界M50。
后摩漫界M50采用存算一体架构设计,具备160TOPS物理算力,配备最高48GB内存与153.6GB/s带宽,典型功耗仅10W,能效达到传统架构芯片的5~10倍。
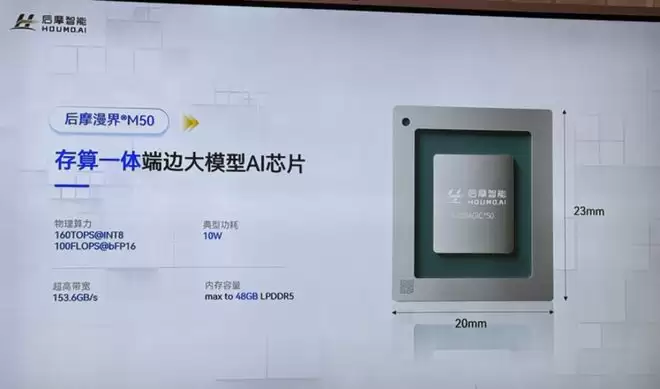
从公开信息来看,M50在设计阶段就针对大模型本地部署进行了优化,通过SRAM与48GB LPDDR5的组合方案,在兼顾性能的同时,提升了千亿参数模型的可部署性与成本可控性。
真正的挑战不止于芯片本身,而在于如何让千亿参数大模型在一台300克级别的设备上长期稳定运行。这需要联想与后摩智能在本地Agent系统、推理框架以及软硬件协同层面进行深度配合。
尤其是在Agent执行链路、模型调度与端侧资源管理方面,联想需要一套全新的系统能力,来支撑持续运行的AI任务。
从2025年下半年项目正式启动开始,联想与后摩智能组建了联合团队,围绕硬件设计、软件适配与推理框架展开了长达十多个月的联合攻坚,最终实现了在后摩漫界M50上运行千亿参数大模型。
目前,P7已经支持千问、智谱、DeepSeek等主流模型,并可实现新模型的Day0适配,即模型发布当天即可完成运行支持。对于用户而言,这让P7不再只是演示型设备,而是一台可长期运行Agent任务的本地AI终端。
从芯片到系统,再到Agent执行能力,联想与后摩智能正在共同验证一种全新的AI主机形态。
随着端侧大模型持续演进,这种兼顾性能、功耗与长期运行能力的Agent Computer,正在成为AI 2.0时代最具现实落地潜力的终端方向之一。
Agent浪潮重构硬件规则,存算一体迎来推理黄金时代
AI芯片的竞争逻辑,正在发生一场静默却深刻的转向。
过去几年,行业的核心指标是峰值算力,比拼的是谁能训练更大的模型,GPU也因此成为整个AI时代的核心基础设施。
但当AI从1.0时代的一次性生成回答,走向2.0时代长期运行、持续执行任务的Agent形态后,芯片的评价体系开始变化:能效比、持续推理能力、本地执行复杂任务的稳定性,正在逐渐与峰值算力同等重要。
这一变化并不是传统AI芯片最擅长的方向,却为新的架构路线打开了窗口。
一个明显的信号来自行业巨头。英伟达重金收购初创公司Groq的核心技术资产,将其LPU(Language Processing Unit)用于高性能推理场景。后摩智能与Groq都走的是存算一体技术路线,都是基于SRAM设计产品,通过减少数据搬运来提升推理能效,只是产品命名方式不同。
后摩智能在成立之初就专注于存算一体技术的研发与产业化,并于2024年推出针对大模型推理优化的后摩漫界M30,支持运行60亿参数模型,且获得了中国移动等客户。
目前,基于后摩漫界M50,后摩智能已经搭建起M.2卡、DM.2卡、Pcie卡,最高640TOPS算力的完整产品矩阵,并完成了从技术原型到规模化商用的关键跨越。如今,后摩漫界M50已全面落地于联想AI主机P7、AI PC、桌面机器人、Agent Box、智能语音终端、AI网关等多元端边场景。
后摩智能也在研发下一代芯片,目标是进一步提升能效比与大模型推理能力,以适配未来更复杂的Agent时代需求。
这是一个标志性的转折点。GPU定义了大模型训练时代,而Agent的全面爆发,正将算力竞争从云端训练中心,推向海量的端侧与边缘推理节点。在这场算力格局迁移中,以存算一体为代表的AI原生架构,不再只是GPU的补充或替代,更在逐步建立端侧Agent时代的全新硬件标准。
随着Agent开始向更多本地设备加速渗透,行业对于低功耗、高能效端边推理芯片的需求也将持续增长。
未来,围绕端侧大模型推理,还会出现更多新的芯片形态与架构路线。
在这场由Agent驱动的AI硬件范式切换中,AI原生芯片正在成为竞争关键。像后摩智能这样率先完成存算一体商业化落地的公司,也正在进入更大的增长通道。


