连夜实测Kimi K3体验评测:为何被调侃改名Kable
类型:热点整理2026-08-21
KimiK3以2 8万亿参数成为全球最大开源模型,在CodeArena前端编程盲测中登顶,超越ClaudeFable5和GPT-5 6Sol。其混合线性注意力与注意力残差架构支持百万token上下文,API价格仅为对标模型20%至40%。实测在物理模拟、程序化生成及产品级应用开发中表现优异,但官方承认综合能力仍逊于最强闭源模型。
凌晨刷到 Arena AI 更新 Code Arena 榜单时,说实话,还是有些意外。
刚刚发布的 Kimi K3 拿到了 1679 分,位列全球第一,超过了 Claude Fable 5 的 1631 分,以及 GPT-5.6 Sol 的 1618 分。
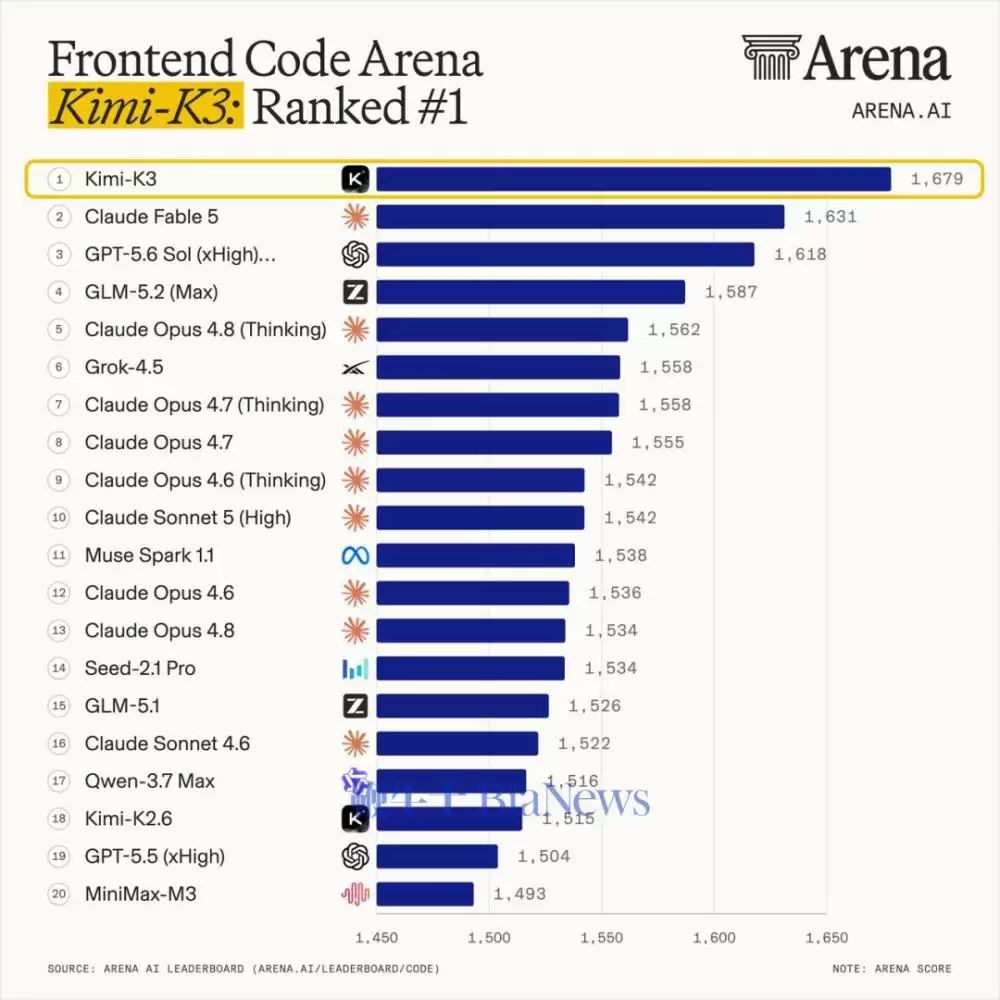
Code Arena 主要测试的是前端编程能力。模型需要按照用户需求生成网页,并完成视觉还原、交互设计以及功能实现等任务。
榜单成绩来自百万级用户参与的公开盲测。相同任务会同时交给两个匿名模型,用户在实际体验两个结果后进行投票,投票结束后才会公开模型身份。
在结果揭晓之前,用户并不知道自己选择的是哪家模型,因此品牌影响被进一步削弱,测试结果也更具参考价值。换句话说,至少在强调视觉表现与交互落地的前端开发场景中,K3 已经来到了当前最靠前的位置。
一个刚上线的开源大模型,直接超过多款闭源旗舰,确实让人有种 too good to be true 的感觉。于是团队也趁热打铁,连夜实测了 Kimi K3,想看看它的真实水平到底如何。
一个冷知识:下面这段视频并不是 Kimi 官方发布的宣传片,而是 APPSO 把原预告片交给 K3 作为参考,再让它重新生成的一段动画。
从理解原始视频、重建网页画面,到处理镜头、动画效果和交互逻辑,整个流程都由 K3 独立完成。让模型亲自为自己做一支介绍动画,确实是非常直接的开场测试。
尤其考虑到最近 Fable 5 和 GPT-5.6 的竞争愈发激烈,模型能力越来越强,Token 消耗也一路走高。很多人还在等待 Claude Opus 5,没想到 Kimi 已经率先端出一个参数规模达到 2.8 万亿的开源模型。
你没看错,2.8 万亿,而且还是开源。
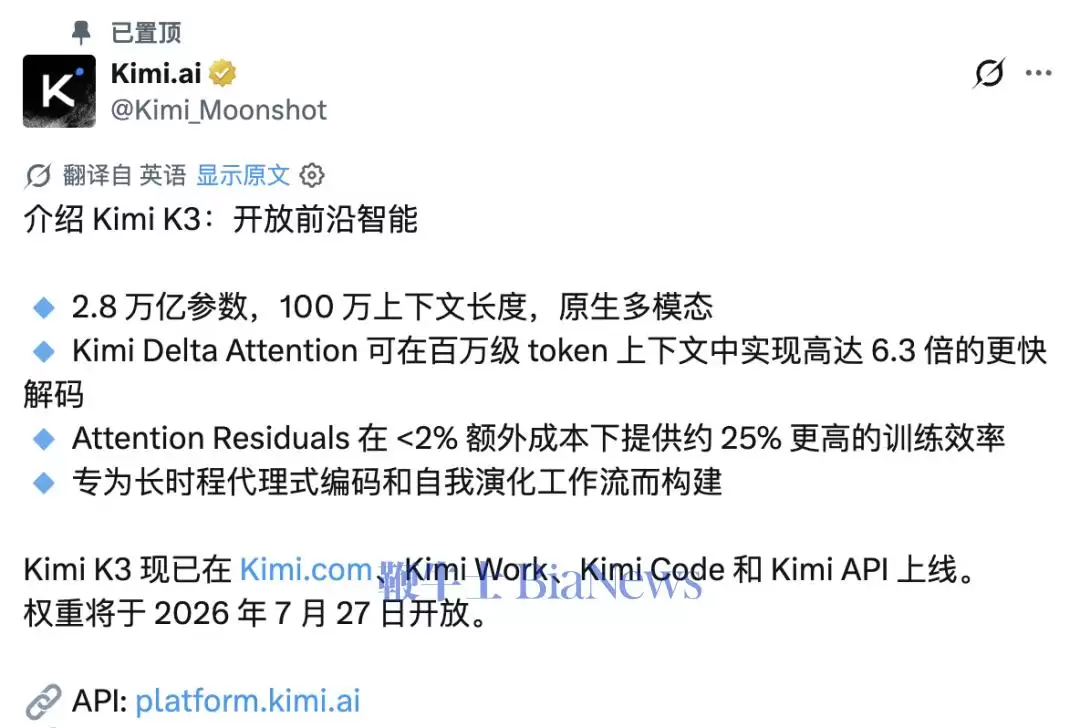
Kimi K3 拥有超大规模的 2.8 万亿参数,是全球首个开源的 3 万亿级别模型。它支持 100 万 token 上下文,原生具备视觉理解能力,重点面向长程编程、知识工作和推理任务。
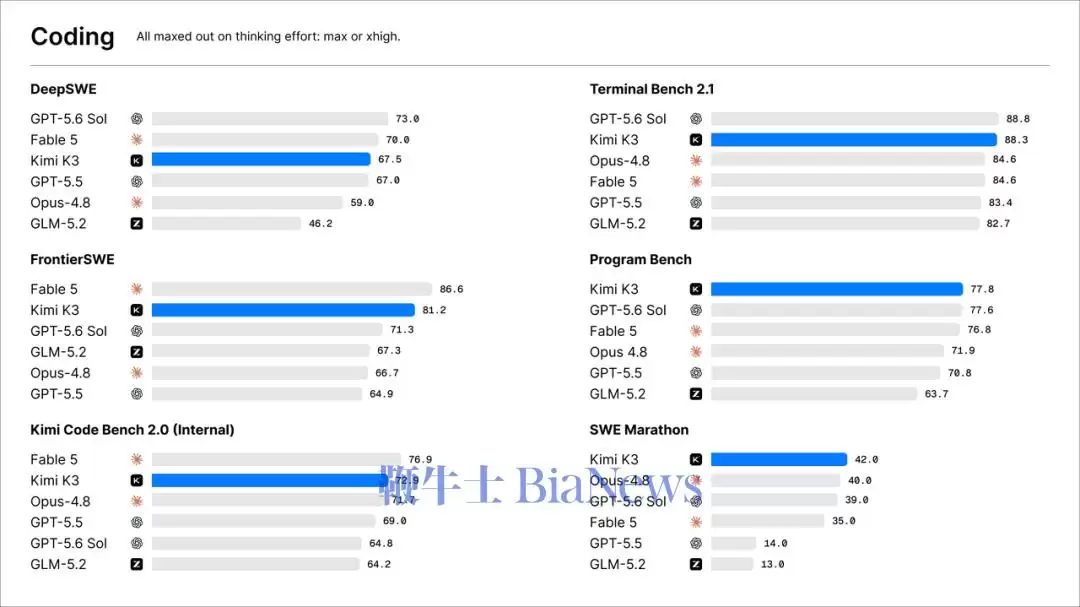
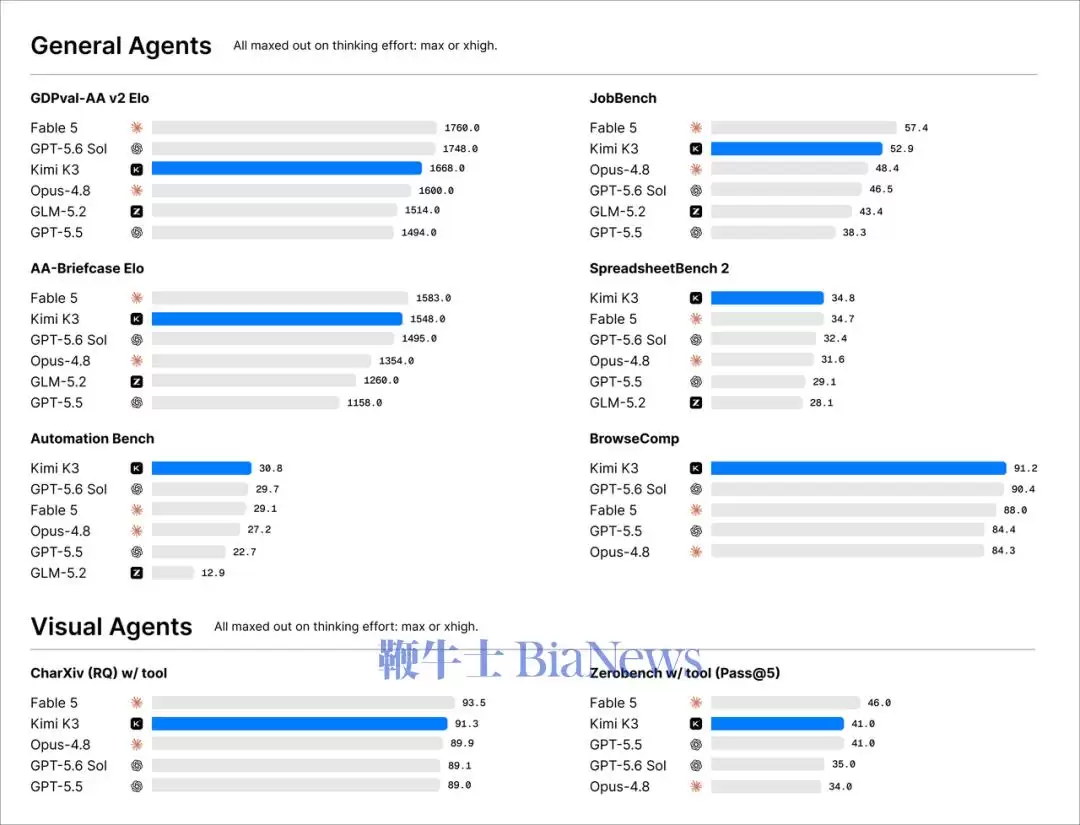
不得不说,当闭源旗舰还在小步迭代时,开源阵营已经直接把参数规模推到了新的高度。
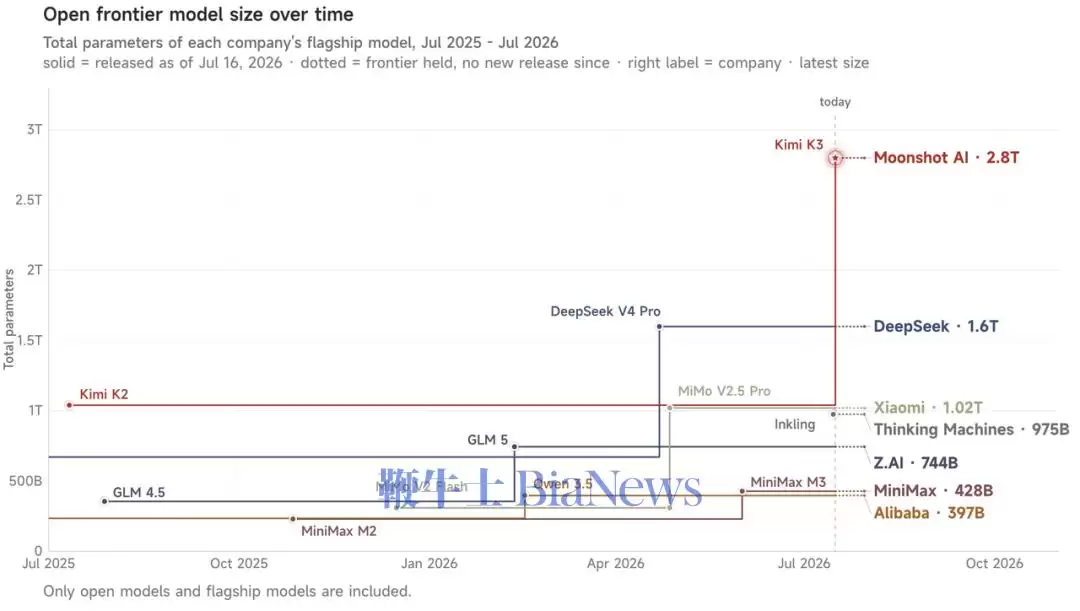
更有意思的是,官方博客里写了这样一句话:「虽然Kimi K3的整体表现仍落后于最强的闭源模型Claude Fable 5和GPT-5.6 Sol,但它在我们的整套评测中展现出前沿水平的能力,并稳定超过了其他所有模型。」
这种坦率,在国产大模型发布博客里确实不多见。谦逊归谦逊,但 K3 这次展现出来的能力,分量一点也不轻。
## 靠这两个东西驯服2.8万亿巨兽
先来看看,这个 2.8 万亿参数模型究竟是怎么做出来的。
过去 12 个月里,有 9 个月开源模型的规模上限都由 Kimi 保持。K3 可以看作这条技术路线的最新进展。在架构上,K3 带来了两个新设计:混合线性注意力(Kimi Delta Attention)和注意力残差(Attention Residuals)。
更通俗一点理解,前者可以让模型在处理超长上下文时,不至于被庞大的计算量拖垮;后者则让信息在数百层深度网络中传递时尽量减少“失真”。一个解决长度问题,一个解决深度问题,组合起来撑住了万亿级参数模型的训练与推理。
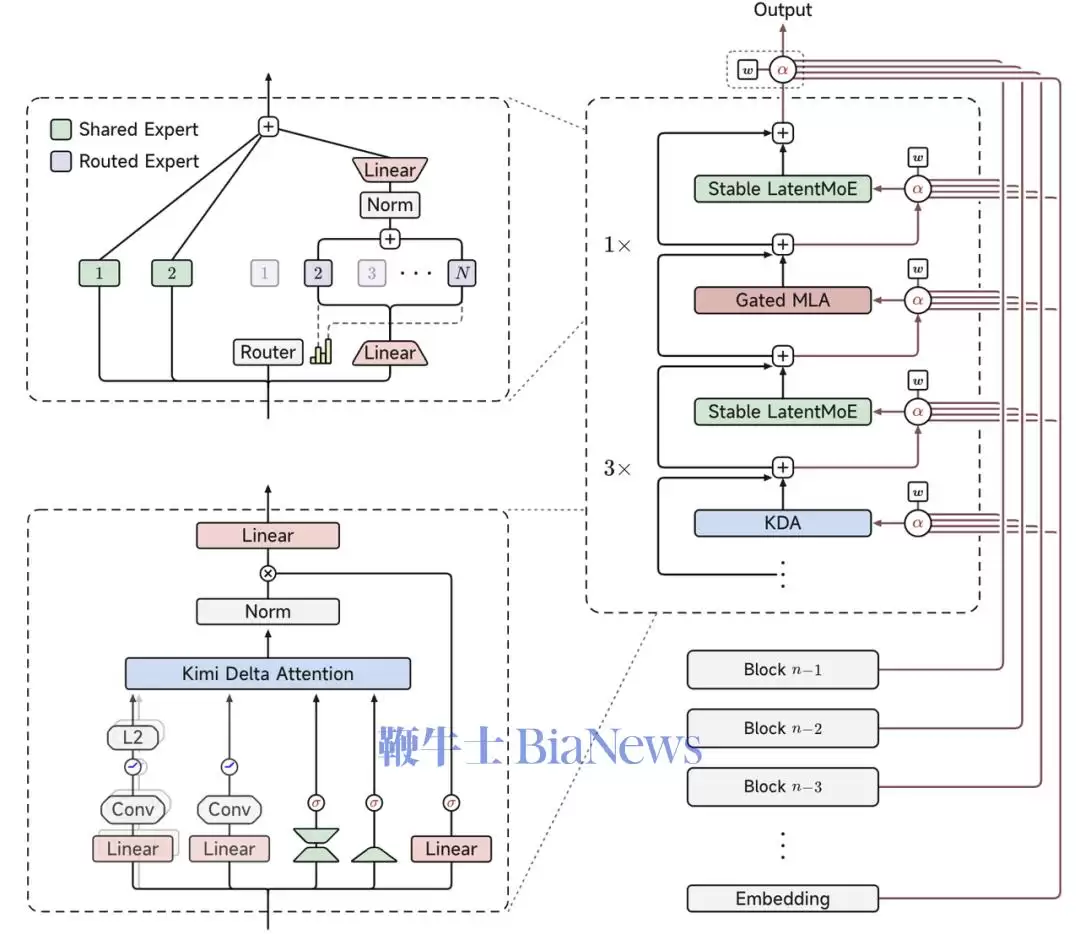
MoE 稀疏结构的优势也进一步被放大:总共有 896 个专家,每次仅激活 16 个。再配合训练方法和数据配方的优化,官方表示 K3 相比 K2 的整体扩展效率提升了约 2.5 倍。
也就是说,在相同算力条件下,它可以换回更多实际能力。
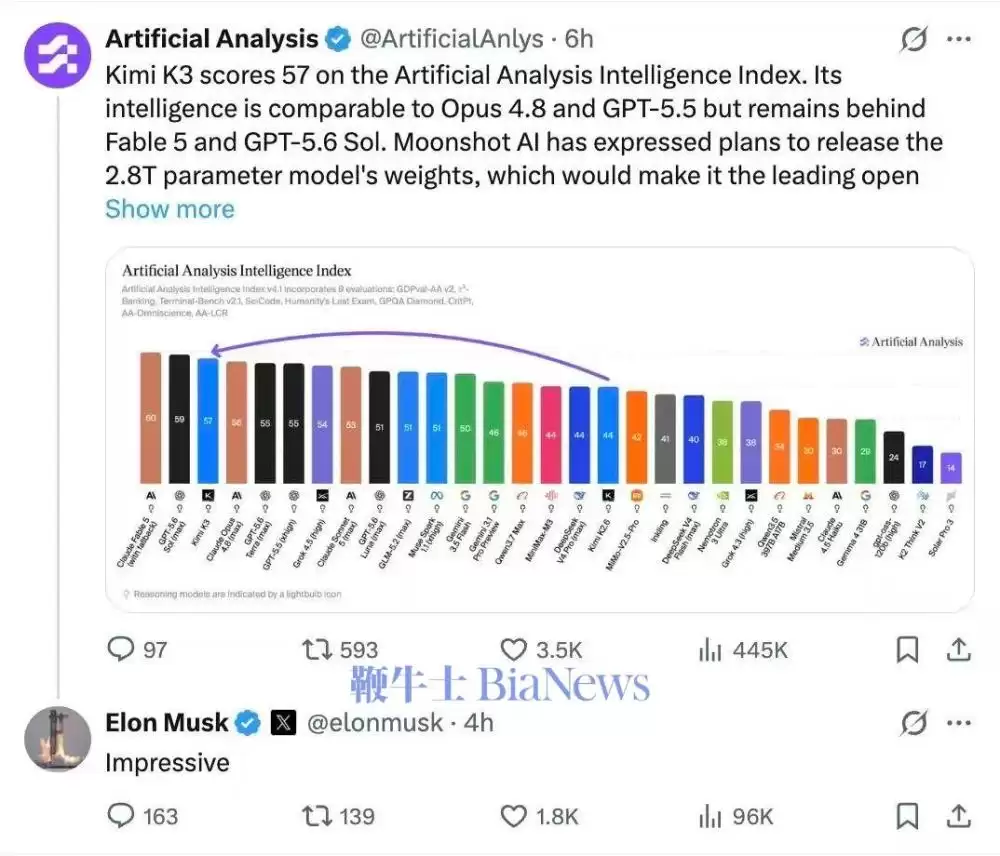
放到覆盖推理、编程、知识等能力的 Artificial Analysis Intelligence Index 中,K3 又以 57 分排名第三,仅次于 Claude Fable 5 和 GPT-5.6 Sol,同时领先 Claude Opus 4.8、GPT-5.5 等模型。
这份成绩单甚至吸引了马斯克的关注。他在评论区留下了一句评价:「Impressive(令人印象深刻)」。
把两张榜单放在一起看,K3 与综合能力最强的闭源模型仍然存在差距,但在编程尤其是前端编程这个核心战场上,已经表现得相当能打。
看到这样一款高性能大模型,相信很多人的第一反应都是:它跑起来是不是非常贵?
Kimi 显然也提前考虑到了这个问题。
K3 从 SFT 阶段就开始做量化感知训练,采用 MXFP4 权重和 MXFP8 激活,天然适配低精度硬件。专家并行训练实现了完全均衡,使用静态形状,关键路径不需要主机同步。
KDA 对传统 prefix caching 带来了新的挑战,因此 Kimi 还把对应实现贡献给了 vLLM 社区,并随着模型一起开源发布。
落到价格层面,其实中国模型不应该总停留在“拼低价”这一条路上。市场既需要有人负责“量大管饱”,也需要有人真正挑战 Anthropic 和 OpenAI 的定价权。这次 K3 在性能上对标甚至超过 Opus,偶尔还能追近 Fable,而官方 API 的输入和输出价格只有 Fable 的 20%、Opus 的 40%,这显然是在正面冲击 Anthropic 的价格体系。
考虑到这个模型 10 天后就会开源,有实力的企业可以自行部署,再结合中国 AI 公司普遍算力紧张的现实,这样的定价策略就更值得玩味了。
不过 API 价格和普通用户的关系并不算特别直接。大多数人使用的包月套餐,在用满的情况下,通常会比 API 价格便宜 5 到 10 倍。
## 实测K3,你的名字应该叫Kable
参数规模和价格都聊完了,接下来就是最关键的问题:Kimi K3 到底能完成多复杂的任务?
这次给 K3 准备了五个跨度很大的测试任务,既包含物理模拟、程序化建模和复杂经营系统,也有更依赖审美判断的东方奇幻场景。换句话说,画面做得漂亮只能算及格,背后的数值变化、状态演进和交互逻辑同样必须成立。
今年世界杯里,点球再次成为许多比赛的胜负关键。即便强如梅西,也会罚失点球。那么如果借助 AI 计算,究竟什么样的点球角度和方式,进球概率最高?
K3 把球员脚感、射门角度、球速、门将反应等变量转化成一套可信的计算模型,再基于公开数据进行大规模蒙特卡洛模拟,不断比较不同策略的成功率,最终回答了那个所有主罚者都想知道的问题:
在不突破职业球员真实能力上限的前提下,球到底该怎么踢,才最难被门将扑出。
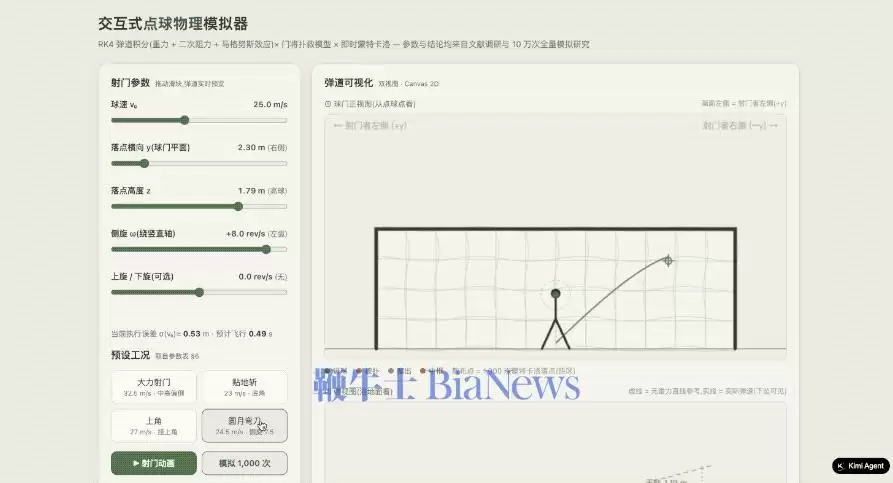
K3 计算出的理论最优方案是:v₀≈25 m/s + 侧旋≈8 rev/s + 半高偏侧落点,进球概率≈89%。如果梅西决赛前能先看看这篇分析,或许会有帮助。
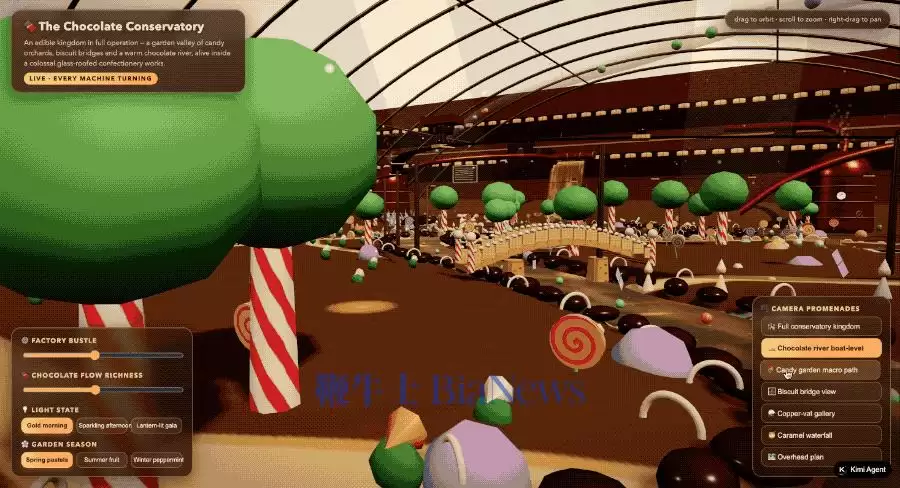
第二道题,是用 Three.js 从零构建一个巧克力工厂花园世界:巧克力河、焦糖瀑布、糖果园、铜制大锅、传送带、微缩工人,全部都要程序化生成,不能调用外部素材,同时还要求工人具备真实的任务队列和路径网络,而不是站在原地“摆拍”。
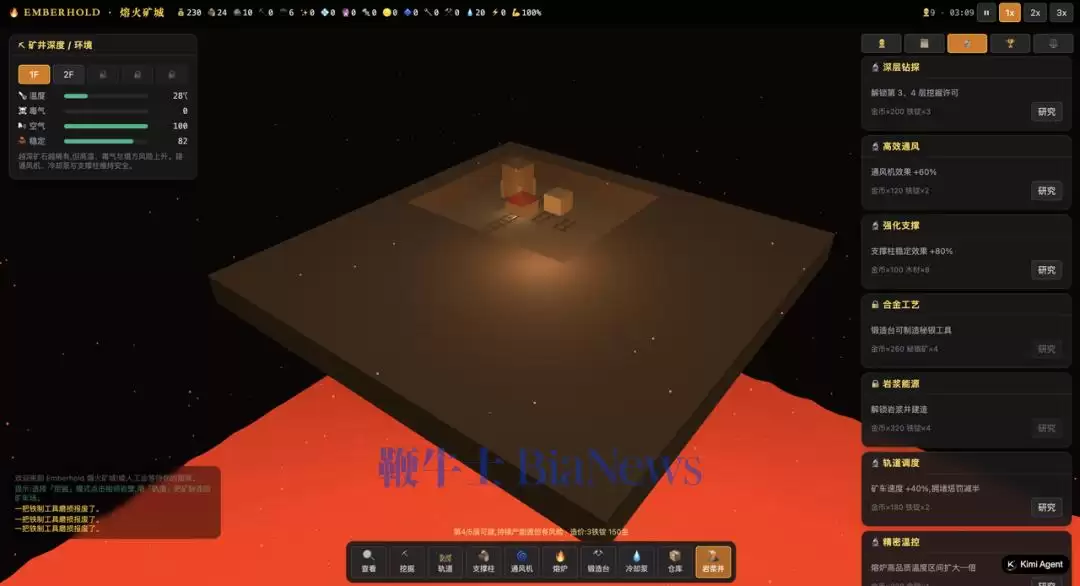
同样属于程序化建模任务,《Emberhold:熔火矿城》进一步加入了经营模拟和风险系统:多层矿井、轨道矿车、熔炉锻造、通风系统与塌方机制需要全部联动。挖得越深,矿石越稀有,但温度和塌方风险也会同步上升,矿车还必须沿着真实轨道运行。
更高难度的一题,则把场景推向海底火山喷发。K3 需要用 Three.js 实时呈现一座岛屿从海中诞生的全过程:熔岩喷泉撕开海面,蒸汽、火山灰、闪电、巨浪和科研船同时运动,海岸线还要随着熔岩冷却、坍塌和海浪侵蚀持续生长。
难点在于,它必须同时维持多套动态系统正常运行,并提供从海底冒泡、火山爆发到岛屿稳定、生命萌芽的完整时间轴,以及船上、直升机、海岸线和火山口等多种观察视角。画面规模、物理变化、交互控制和运行性能,少任何一项,这个案例都会退化成普通的火山演示网页。
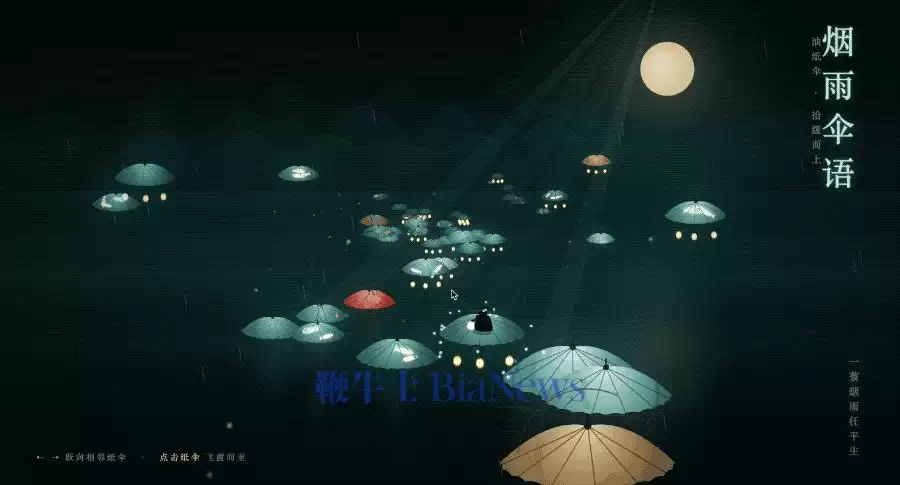
硬实力测试之后,再看看它的审美表现。在这个东方奇幻水墨风油纸伞场景中,细雨、青石与水面之上悬浮着层层油纸伞,透光投影、伞面流动图案,以及可操控人物的跳跃互动,共同营造出灵动又梦幻的视觉效果。
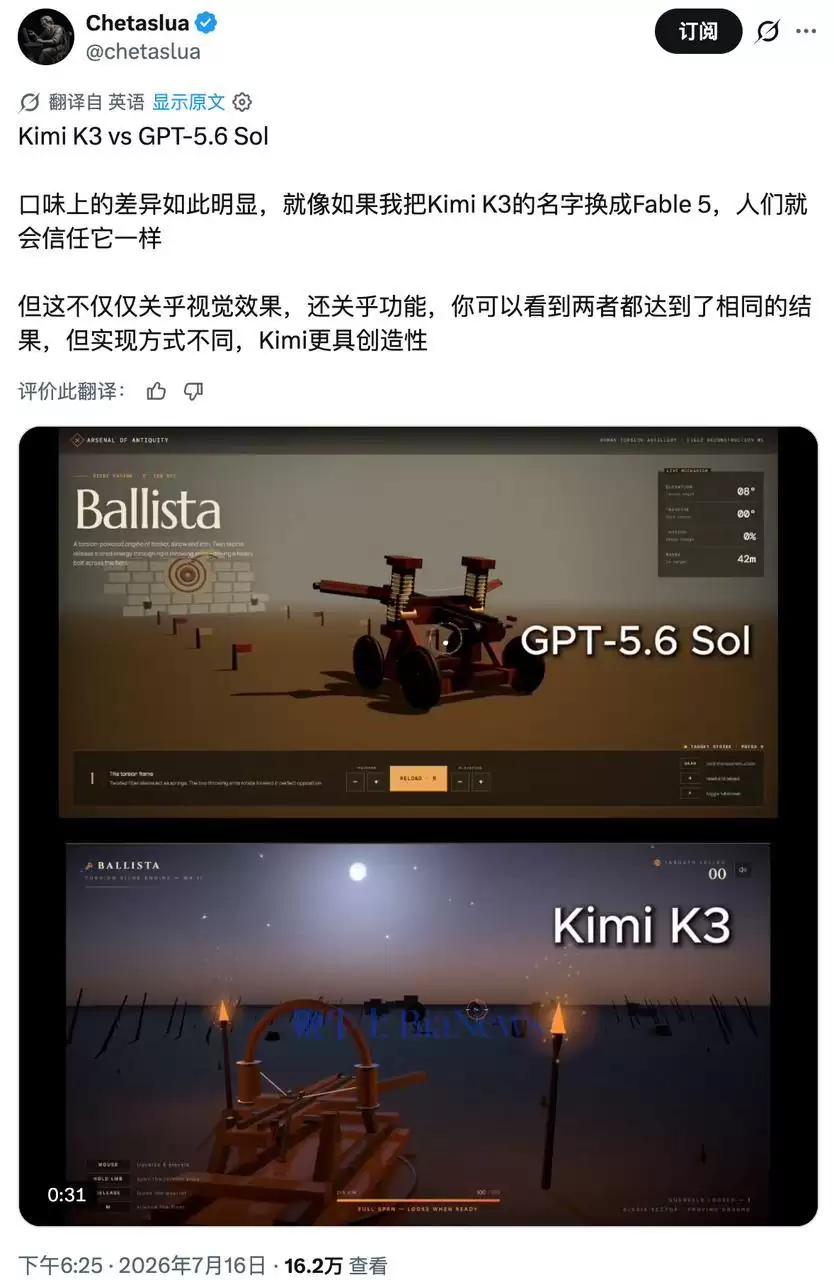
而 X 网友 @chetaslua 的这个案例显示,在他看来,虽然 K3 和 GPT-5.6 Sol 最终达到了类似结果,但实现路径并不相同,K3 的设计品味和创造力更突出。
当然,只有视觉惊艳的 demo 还不够。团队还使用 Kimi K3 开发了一个专注类 App,提示词只有一句话:复刻 Forest,但界面更精美,动效像 Focus Flight。
几个小时之后,它真的做出了成品,甚至已经达到可玩的产品原型水平。这样的工作量,放在过去,一个前端开发者可能要花两到三周。
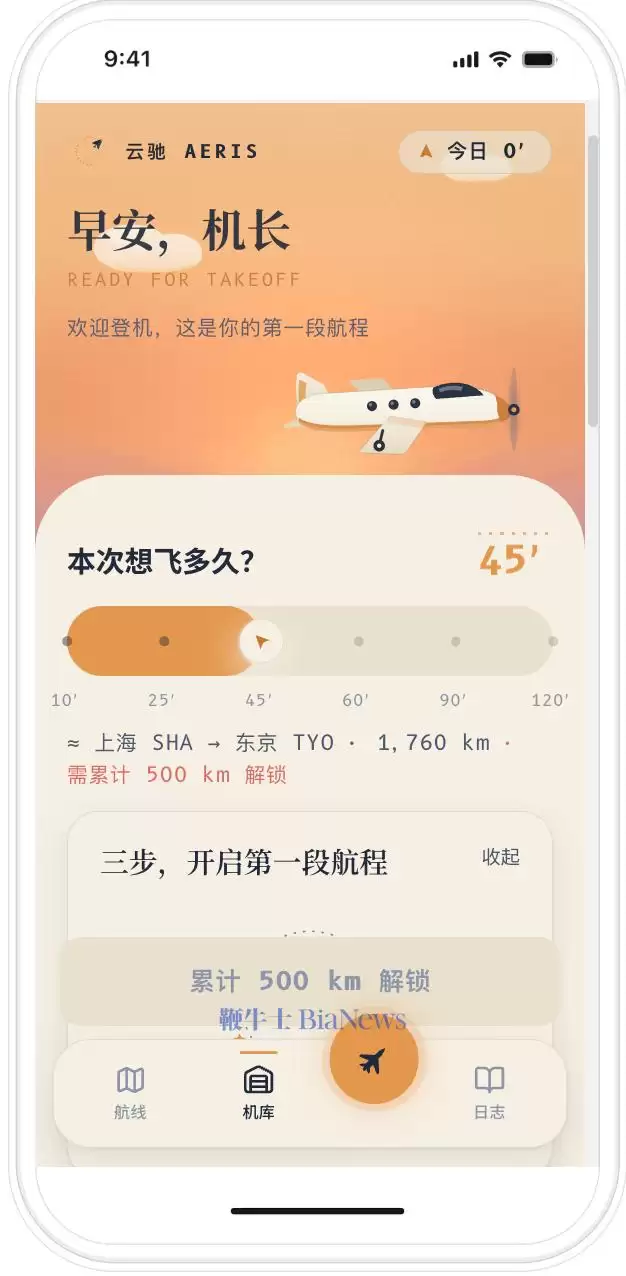
这个 App 叫「云驰Aeris」,打开后是一片黄昏色调的机库,一架飞机停在跑道上,等待我选择航线。
它把 Forest 的“种树专注”玩法改成了航班飞行机制,但并不只是简单换皮:专注时长对应飞行时长,用户还能选择不同白噪音,登机后进入动态巡航,中途退出会触发返航,而完成航程则可以积累里程、解锁新目的地。从品牌命名、视觉风格,到交互细节和成长体系,整体完成度都非常高。
## 开源模型的K3时刻
更难得的是,官方博客也愿意公开分享他们在使用和训练过程中积累的反思。
K3 对历史思考内容非常敏感。它在后训练阶段全程使用思考历史保留模式,因此如果 Agent 框架没有按要求回传全部历史思考内容,或者你是从其他模型的会话中途切换过来,生成质量就可能出现波动。
官方建议优先使用 Kimi Code 这类已经验证兼容性的框架,并尽量避免在会话进行中临时切换模型。
它还有一点“过于主动”。由于训练重点放在长程复杂任务上,遇到小问题或者用户意图模糊时,它有时会替你做出并非预期的决定。如果想让它更稳、更听话,就需要在 system prompt 或 AGENTS.md 里提前设定明确规则。
单凭这份坦诚,先给一个好评并不过分。
说到这里,不妨再聊点更现实的问题。全球最大的开源模型,并不等于全球最强模型。2.8 万亿参数,也不能直接证明 K3 已经全面超越顶级闭源模型。一个大模型能否真正承担复杂工程任务,最终还是要看使用成本、任务稳定性以及真实交付结果。

彩蛋:月之暗面(Kimi)创始人杨植麟的CMU导师Russ Salakhutdinov发帖祝贺,而Russ Salakhutdinov也正是Hinton亲传弟子、苹果第一任AI总监
但 K3 的出现,至少改变了一件事。
过去,开源模型的常见策略,是跟在闭源旗舰后面,用更低价格复现已有能力。现在,开源大模型已经开始主动把规模推向新的上限,去挑战百万上下文、长程编程以及复杂 Agent 任务,直接参与下一代模型能力边界的竞争。
在 X 上,有些网友把 Kimi K3 称作又一个 DeepSeek R1 时刻。但 APPSO 连夜体验后更愿意认为:在开源模型领域,K3 完全配得上属于自己的名字。
2.8 万亿参数只是入场券。Opus 5 还没登场,开源模型格局却已经开始重新洗牌——这,就是 K3 时刻。
