
给AI出一道数学猜想,它第一时间琢磨的,居然常常是:怎么把它推翻,先去找一个反例!
这番听起来多少有点“数学界反骨”的判断,正出自1998年菲尔兹奖得主、英国数学家Timothy Gowers。
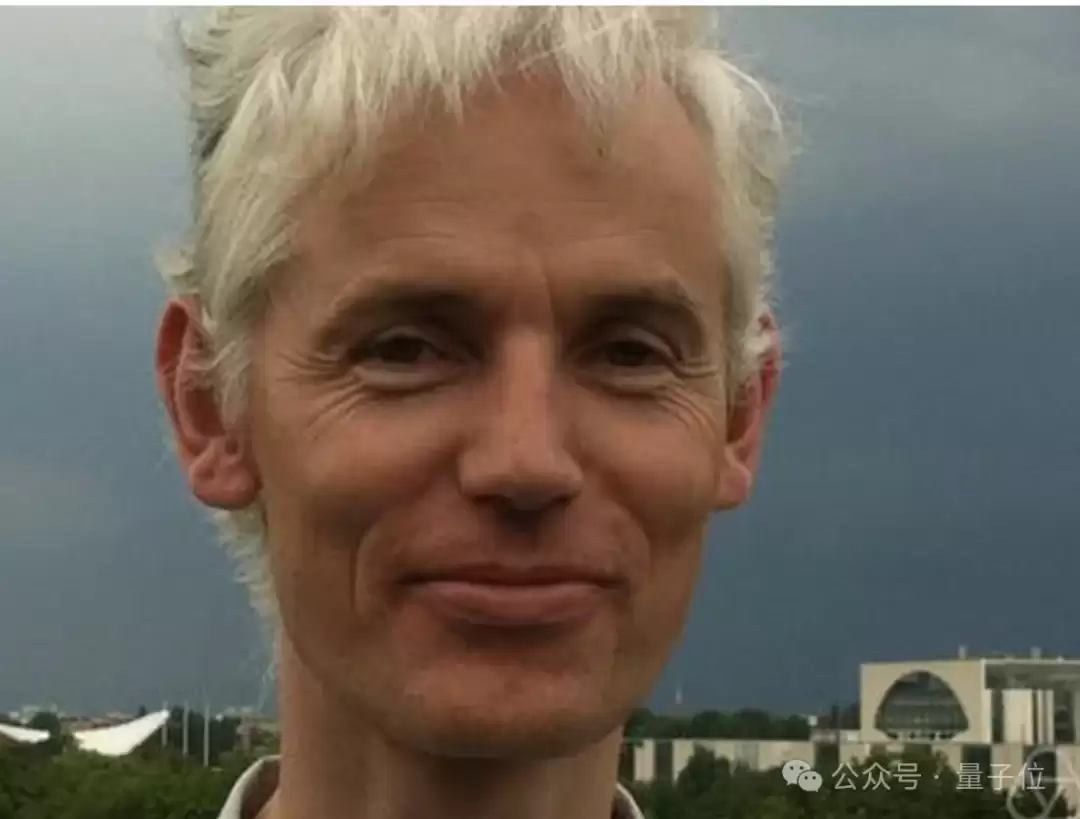
最近,Gowers把这几个月AI最受关注的数学成果摊开来看,结果发现了一件风格高度统一的事——
雅可比猜想,找反例。
Erdős单位距离猜想,找反例。
非sofic群问题,构造一个过去从未找到的例子。
多色Ramsey数问题,核心依旧是构造满足要求的新对象。
人类数学家:这个结论究竟为什么成立?
AI:先等一下,你这个结论……真的成立吗?(一身反骨.jpg)
所以问题来了。
为什么AI一碰到数学猜想,就这么喜欢往“反例”和“构造”这条路上钻呢?
AI最近最出圈的数学突破,都在“找反例”
先说一个大家很容易混淆的点。
Gowers这里提到的“找反例”,和我们学生时代学过的“反证法”,其实还真不是一回事。
我们上学时学的反证法,是一种经典数学证明技巧:先假设结论不成立,再一路推导,直到推出矛盾,从而证明原命题成立。
而Gowers这里说的“找反例”就直接得多——
比如有人提出:所有满足A的对象,都具有B性质。
那AI要做的,只是从大量对象里揪出一个:它明明满足A,却偏偏不具备B。
完。
整条数学猜想当场失效。

也难怪Gowers会注意到这个规律。
因为最近AI最轰动的几次数学突破,确实有不少都是沿着这条思路打出来的。
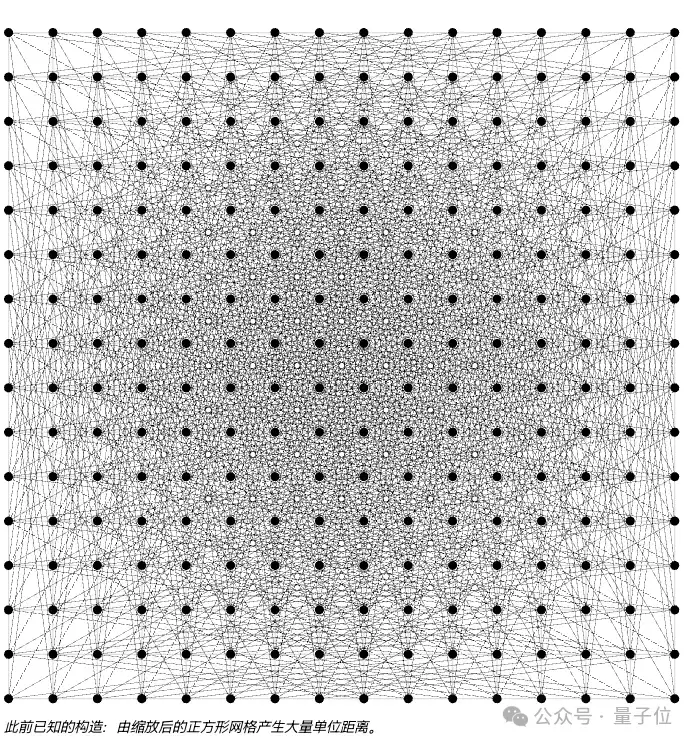
就拿上个月OpenAI内部模型解决的Erdős单位距离问题来说。
近80年来,数学界围绕这个问题形成了一个长期被广泛相信的增长判断,很多研究工作也一直在尝试证明这个判断成立。
结果AI一上来,思路直接180度转弯。
它没有急着沿着人类几十年的研究路径继续推进,反而花了大量推理预算去思考另一件事——
有没有可能,直接给这个判断找出一个反例?
最后它还真的找到了。模型把原本属于代数数论的一套工具引入离散几何,用更复杂的数域构造出一整族点集,使单位距离对的数量以此前预期之外的速度增长。
一个流传数十年的判断,就这样被一个具体构造直接“击穿”。
更有意思的是,数学家后来回看它的推理轨迹,发现它大量时间确实都花在尝试各种构造、搜索数学反例上。(doge)
这件事过去没多久,Claude又给“AI特别擅长拆猜想”这件事补上了一次有力佐证。
数学家Levent Alpöge借助Claude,找到了雅可比猜想相关问题中的反例。
这类成果最有反差感的地方就在这里:AI最后并不需要铺开一整套宏大的正面证明,它只需要把那个特殊对象摆出来,然后逐项检查——
前提,满足。
结论,失败。
那这个猜想基本就可以宣告结束了。
到了Gowers这里,他再回头看OpenAI最近公布的10项数学成果,也发现了类似的味道。
比如长期悬而未决的“是否所有群都是sofic群”问题,AI给出的突破方式,就是直接构造出一个非sofic群。
再比如多色Ramsey数的进展,虽然最终呈现的是严格的下界证明,但整个突破过程依然带有很强的构造色彩:
你必须先找到那些足够特殊、足够刁钻的组合对象,后续证明才有真正落脚的地方。

于是,一个越来越明显的规律浮现出来了。
当前AI最容易做出突破的数学问题,很多其实都可以压缩成一句非常“机器友好”的提问——
“有没有这样一个东西?”
如果答案确实是“有”,那模型最擅长的那套打法就开始发挥作用了。
大规模搜索,跨学科搬运工具,重组已有技巧,反复试探构造,再从庞大的数学对象空间里把那个目标硬生生找出来。
所以,AI真正擅长的,并不只是大家字面理解的“反证”。
更准确地说,它现在尤其擅长一类数学任务:在一个大到人类根本无法穷举的空间里,找到那个确实存在、但一直没人找到的特殊对象。
AI为啥喜欢在这种题里找反例?
问题来了,那么,为什么AI偏偏热衷于给数学猜想“找茬”呢?
Gowers给出的解释其实相当朴素:大模型眼下至少有两个非常直观的优势。
第一,知道得多。(doge)
如果一道题的关键突破,隐藏在某种现有数学工具、某个相关领域,或者某种很少被组合使用的技巧里,那么大模型很可能直接就能从自身知识储备中把它们调出来。
单位距离问题就是一个非常典型的例子。
要知道,这个问题长期处在离散几何和组合数学的语境之中,而AI找到的突破,却借用了更偏代数数论的工具。
对于人类数学家来说,这种跨领域跳跃往往要求研究者恰好同时熟悉两个方向。
而对于大模型来说,这两个领域本来就一起存在于上下文和训练知识中,组合与调用的成本天然低了不少。
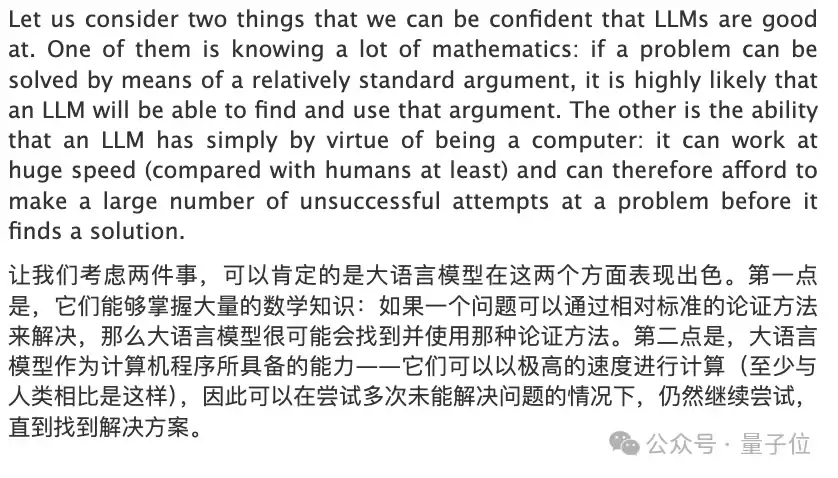
第二,试得起。
OpenAI最近公布的10项数学与理论计算机科学成果中,有些AI寻找数学反例所消耗的全部Token,按API价格折算也不过“数千”美元。
换句话说,很多对于人类数学家而言成功率太低、不值得投入几个月去赌的路线,AI完全可以放开手脚去尝试。
Gowers在文章里也专门梳理了一遍,数学家平时到底是怎么找例子、找反例的——
最简单的一种方式,就是先拿那些“祖传”的经典对象逐个测试。
比如你提出一个关于布尔函数的猜想,通常会先拿几个经典测试样本去检验:
独裁函数、多数函数、奇偶函数、tribes函数……这些都过了,再谈下一步。
第二种是拼装法:从基础对象出发,取积、取商、取极限,换一种构造方式,再看能不能得到想要的性质。
还有随机方法。显式构造太难时,就从某个分布里随机选对象,再证明它以高概率满足你的条件。
再有一种逐步逼近法:先写出一个大概不太对的候选答案,不是因为觉得它一定能成,而是想观察它究竟错在哪里。修一个缺陷,得到第二版;再修,得到第三版……
前面这些大量试对象、换构造、随机搜索的玩法,其实都非常适合大模型:知识库足够大、尝试速度足够快、失败成本又低,确实很有可能靠海量尝试把答案撞出来。
但越往后,就越考验一种很难写进公式里的能力:走到半路时,你能不能嗅出来这条路到底有没有希望。
Gowers把它称作数学家的“鼻子”。
一个真正顶尖的研究者,不是永远不会走错路,而是能在搜索树刚刚长出大量分叉时,迅速砍掉99%的枝条,只保留最值得投入的那几条。
偏偏这件事,目前AI还经常做得有些喜感。比如Gowers和AI讨论开放问题时,就常遇到一种略显尴尬的体验——
AI会提出一些听起来很有前景的方案,但细想之后却未必可靠;而且AI还很爱说:虽然没解出原题,但我把问题缩小成了一个更精确的子问题~
第一次听,确实挺让人兴奋。
但如果第五次还停留在不同版本的“更精确子问题”,人类数学家大概就要开始嘀咕了:这到底是在逼近答案,还是把迷路描述得越来越优雅?
这也是Gowers没有把AI神化的原因。
他并不认为人类会永远保住这项优势;相反,他明确预计模型还会继续快速进步,甚至在一两年内就可能长出更强的“数学鼻子”。
只是就目前来看,AI的强项仍然更像广度优先:广泛调用已有知识、广泛探索可能路径、在海量尝试中碰到解法。

最后,更有意思的是,Gowers还给AI真正进入顶级数学创造阶段,设下了一个颇为浪漫的验收标准——
有一天,AI给出的解法,不只是把题做出来,还能提出一种前人从未想到过的新方法。
更妙的是,回头看这套方法又特别自然、特别顺,甚至还能被其他数学家继续拿去做出一连串新成果。
到了那一步,AI完成的事情,就已经远远超出“从巨大搜索空间里把答案找出来”这件事了。
AI在数学研究与数学创新中的身份,可能才真的会发生改变。
参考链接:
[1]https://gowers.wordpress.com/2026/08/12/关于大型语言模型擅长哪种数学的探讨