
AI竞争的核心焦点,正在发生变化。
一个词开始在AI前沿讨论中被高频提及:Recursive Self-Improvement。
它指向的是AI自主优化能力,即让AI参与研发更强大的AI——
AI开始自己提出问题、设计实验、评估结果,再依据反馈持续改进自身能力。
这被视为继AI推理、Agent之后的下一个关键技术前沿,也是迈向AGI(通用人工智能)的重要路径。
以OpenAI为例,GPT-5.6的RSI相关能力,已经帮助其将端到端服务成本降低20%,Token生成效率提升15%以上。
再看Anthropic,其披露代码库中超过80%的代码由Claude自主生成。

Jeff Dean离开谷歌后创办Discovery Loop,押注的同样是RSI赛道。根据最新市场消息,这家公司的估值已逼近100亿美元。
“优化”这件事,正越来越多地由AI深度完成。硅谷正在为这一方向持续升温,而中国也并未缺席。
清昴智能,国内首家专注AI自进化Infra的创业公司,对这一方向的布局甚至早于本轮RSI热潮。
并且,团队已经在回答一个更底层、更关键的问题:
如果模型可以持续自我进化,那么承载它的算力底座该如何同步升级?如何让支撑AI进化的软件基础设施本身,也能够被算法化、自动化?
模型已进入L4级高速自主迭代,国产算力仍停留在L1式人工手搓
清昴的答案,要从一场明显的节奏错位说起。
过去几年,大模型能力的提升几乎沿着一条清晰路线演进。
从聊天问答、内容生成,到工具调用、长链路推理,再到越来越多能够连续运行数小时甚至更久的Agent,模型正从一问一答走向更高自主性的任务执行。
如果把这种智能化进程类比为自动驾驶,那么上层模型已经开始向L4级高度自主执行能力迈进。
这种“L4自动驾驶”带来的直接变化是,单次任务需要处理更多Token、更长推理链路以及更复杂的工具调用,这自然对底层算力提出了更高要求。
与此同时,中国AI产业还面临另一层现实压力。
在外部先进芯片供给受限的大背景下,中国AI产业正越来越依赖国产芯片与国产算力。
但问题在于,国产芯片并不是“有卡就能直接跑”。
一款模型想要在一张芯片上高效运行,需要经历算子适配、编译优化、内存调度、框架兼容、推理优化等一整套复杂环节。
而国产算力的软件生态相对碎片化,换一款芯片需要重新适配,换一个模型又要重新调优。
长期以来,这类工作高度依赖少数资深工程师的经验。
手写算子、调试参数、规划内存与并行策略……一个复杂算子的开发和优化往往要花费数周时间,却又可能很快被模型与芯片的高速迭代淘汰。
而且,从行业实际利用率来看,国产算力仍有较大的效率释放空间。
于是,一个新的核心矛盾出现了:
上层模型正在变得越来越自主,而底层算力基础设施却依然高度依赖人工——
模型已经迈向L4,算力底座却还停留在L1式人工接管阶段。
如果AI真的要进入持续自我进化时代,AI Infra也不可能永远依赖手工调优。
这正是清昴智能从创业起点就瞄准的方向:
构建一套真正具备自我迭代能力的算力基础设施。
不再依赖专家手工优化,也不局限于单点式的算子生成或编译适配,而是让整个底层系统进入由AI驱动的反馈闭环。
最终,为Agent时代数万亿级Token的高效生产提供坚实的算力底座。
清华团队多年学术积累,率先打造自进化算力底座
团队如今这套自主优化体系,并不是看到AI Infra风口后临时拼接出来的方案。
从创立第一天起,团队的核心目标就是探索如何实现“AI自己优化AI”。
整套技术脉络,可以一路追溯到清华朱文武教授实验室的长期研究。
传统机器学习优化范式,本质上一直是人类定义规则、机器负责执行。
2015年前后,AutoML与Meta Learning开始把模型结构、超参数等部分决策权交给机器,但优化什么、使用什么数据、朝哪个方向优化,依然由人类决定。
再进一步,如果连这些关键决策也交由机器来完成,会发生什么?
在机器学习自动化领域,清华大学计算机科学与技术系朱文武教授团队已深耕多年。2022年,他们正式提出一个全新概念——自我驱动机器学习。这一概念进一步扩大了机器获得的自主权,覆盖任务、数据、模型、优化策略,甚至评价标准本身。

这也是清昴技术路线的重要源头之一。
清昴智能是首个将这一路线真正推进到产业实践的创业公司,带头人关超宇正是朱文武教授的学生、清华特奖获得者。
他在AutoML、元学习与自主机器学习领域深耕多年,带领团队在NeurIPS、AAAI等国际顶级学术赛事中屡获佳绩。在AutoML、MetaDL等全球挑战赛中,他们也凭借突出实力击败哈佛、MIT、斯坦福等世界强队,夺得冠军。
进入产业场景后,这条技术路线进一步转向AI Infra:
让机器自己找到更高效的算力运行方式。
随着模型、算子、运行时、分布式架构和国产芯片快速迭代,优化空间变得越来越复杂,单靠人工经验已经难以全面覆盖。
于是,AI优化AI,逐渐从研究命题转变为AI Infra领域急需落地解决的现实问题。
在此基础上,团队进一步发展出自主机器学习的完整框架。

在工程实现层面,清昴将整套体系拆解为两项核心能力——
自主优化与自主演化。
自主优化解决的是“这一次如何优化”。
系统能够根据真实运行状态自动定位瓶颈、尝试不同方案,并通过实际反馈找到更优解。
自主演化解决的是“下一次如何更快优化”。
系统会把每次优化过程中沉淀下来的经验保留下来,在面对新的模型、芯片与运行环境时复用已有经验,减少重复试错成本。
于是,原本一次性的人工调优,被改造成一个持续循环的过程:
优化→积累经验→再优化→再积累,闭环一旦建立,系统就会越优化越擅长优化。
这套技术范式已经在国产算力真实生产环境中完成验证。
过去,一名资深专家完成一款复杂算子的开发与调优,通常需要两周时间;而依托清昴的自主优化系统,这一周期被压缩至约1小时,整体效率提升约336倍。
在模型侧,国产芯片全链路打通原本需要约一个月,如今可压缩到1天至1周,综合提速约30倍。
部分代表性算子的性能,相比基线版本最高实现30倍加速,达到行业领先水平。
截至目前,清昴已完成数十款国产芯片的适配与性能优化,覆盖国内超过半数主流国产算力芯片,是国内适配国产芯片数量和性能优化案例最多的AI Infra厂商之一。
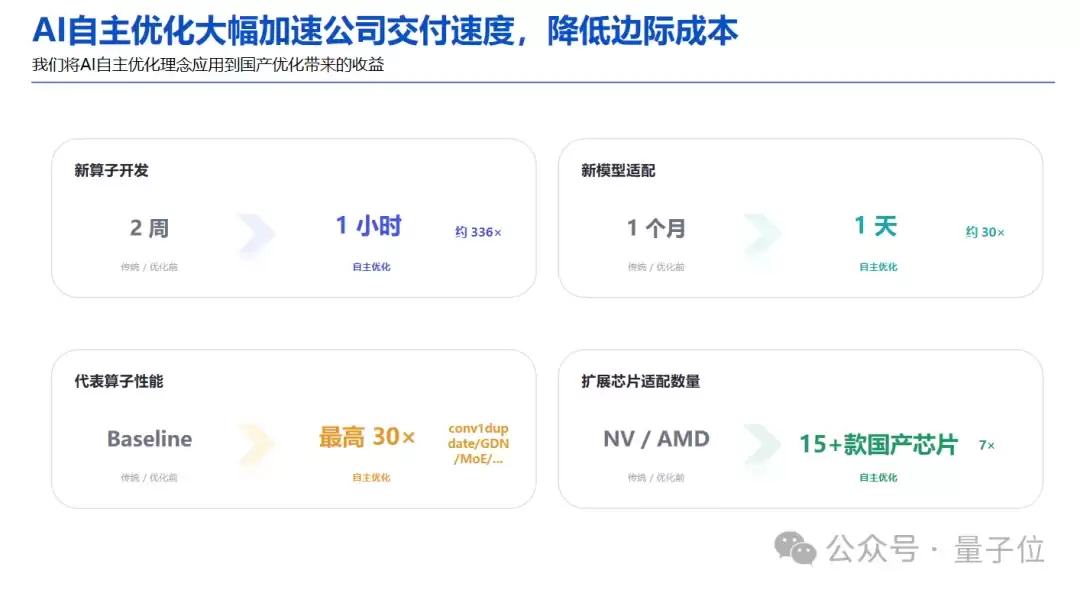
但这些数据真正值得关注的,并不只是它比工程师快了多少。
更大的变化在于,过去只有少数顶尖专家掌握的优化经验,如今开始转化为一种可以由机器执行、持续积累,并可复制到不同模型、不同芯片上的系统化能力。
基于国产算力打造日均万亿级Token工厂
把算力优化到位,只是清昴的第一步。
在Agent时代,算力面临的问题早已不是某个模型“能不能跑”,而是能不能稳定、持续、低成本地生产海量Token。
尤其到了2026年,Agent的爆发正在持续拉动Token消耗需求。
部分复杂Agent单次任务的Token开销,相比传统对话模型提升数百倍,不少业务场景的日均调用量也已逼近万亿级别。
清昴判断,随着未来视频模型、多模态、AI for Science、具身智能以及物理模型的全面爆发,Token调用量还将跃升到新的数量级。
当调用规模继续扩大,决定业务能否真正跑通的,就是每一个Token背后对应的算力成本、响应延迟和资源利用率。
而行业当下最稀缺的,正是这种高性能、低成本、可稳定大规模交付Token输出的工程能力。
沿着这条思路,基于国产芯片构建万亿Token工厂,也成为清昴底层自进化能力产品化、服务化的直接体现。
对于国产算力中心而言,清昴对自身技术能力有充分信心:
因为极致的AI Infra优化,能够将原本闲置或低效的算力资源转化为高价值的Token产能。
基于这种“点石成金”的能力,清昴不仅通过租赁方式获取大规模国产算力,还提供深度赋能的私有化部署或代运营模式,与合作方共同打造从算力生产、适配、调度,到分发及场景落地的国产算力生态。
可以说,清昴是市场上率先以自进化技术打通“从算力自主适配优化到Token生产”端到端闭环的服务商。
对于模型厂商、API平台以及行业客户来说,他们并不关心Token底层究竟运行在哪种芯片上,他们真正关心的是最终的产出效率和使用成本。
基于此,清昴的商业交付模式也非常清晰:
既直接提供高性价比的Token产出能力(卖Token),也对外输出整套自进化的Token生产平台(卖产线)。
这意味着,无论客户选择哪种合作模式,他们购买的都不再是一次性的芯片适配外包服务,而是一套能够持续优化、持续进化的Token生产能力。
其中最关键的变化在于,“适配”本身开始变成一个持续运行的过程。
新模型来了,系统自动学习;新芯片来了,系统自动调优;新的业务场景出现,也无需完全从零开始。如此一来,“适配”就具备了复利效应。
这正是清昴自进化Infra的目标:
不是替客户完成一次优化,而是把优化本身变成一项能够长期运行的基础设施能力,推动算力底座从L1加速进化到L4。
现阶段,清昴优化的是模型、算子和国产芯片,支撑的是万亿级Token需求的Agent市场。
面向未来,经过优化的模型与Agent还将进一步反哺算力底座,持续抬升算力优化基础设施在智能化与自动化方面的上限。
AI optimizing Infra, and Infra empowering AI.(AI优化基础设施,基础设施赋能AI)
在国内AI Infra版图中,清昴既是最早把“AI优化AI”视为创业第一性问题的团队之一,也是最坚定将全部筹码押注在国产算力上的那一家。
当多数玩家仍在通用算力赛道内卷,把精力消耗在货源甄别和价格竞争上时,清昴选择了一条难度更高、但更具长期价值的道路:
让国产算力的软件底座自己学会进化。
这不是权宜之计下的替代方案,而是中国算力自主时代真正的序章。