
DeepSeek V4 Pro,可能又一次迎来了更新。
今天下午,有用户在技术社区 Linux.do 发帖表示,自己在 DeepSeek Harness 标准模式、V4 Pro Max 思考档位下,发现模型的思维链风格突然发生了变化。

原本常见的“The user is asking”“I need to”等表达,开始变成连续的第一人称进行时表述:
“I’m weighing……”
“I’m settling……”
“I’m aiming……”
“I’m starting……”
“I’m validating……”
社区把这种输出风格简称为「I’m doing」思维链。短短一小时内,已有多名用户在网页端和官方 API 中复现了这一现象。
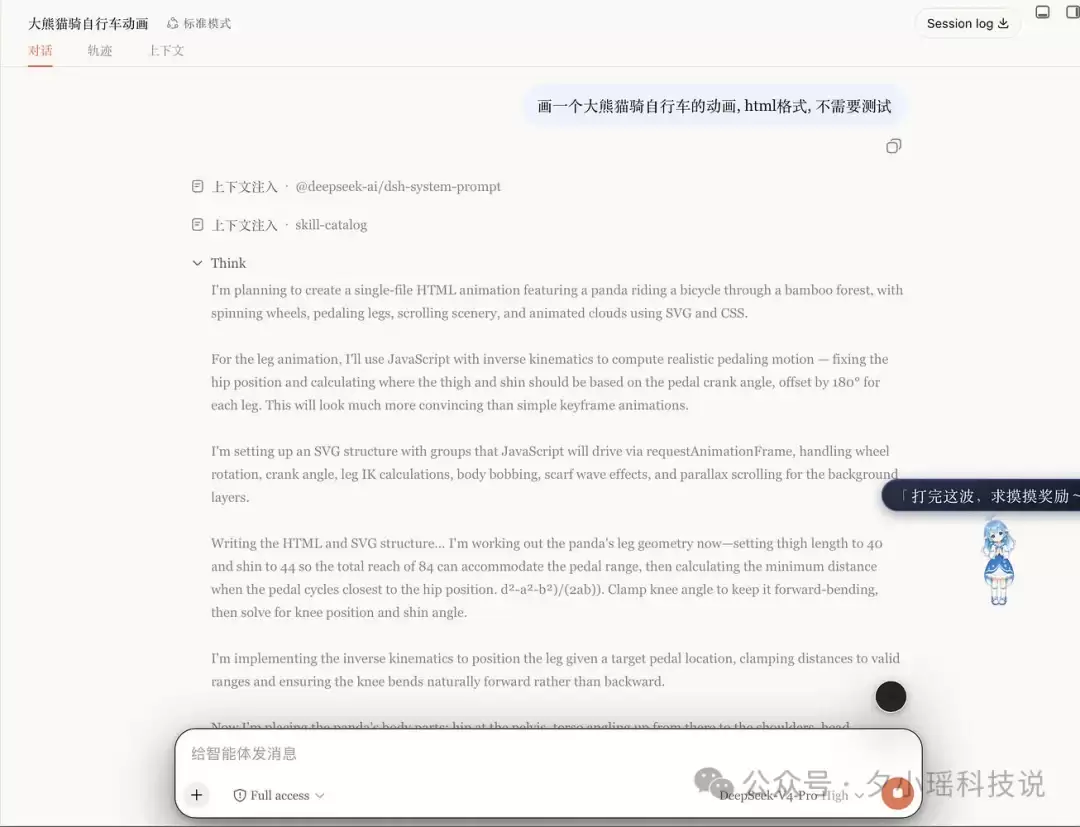
当然,也有人多次尝试后看到的仍然是旧版思维链。与此同时,还有用户注意到,官方 API 返回中也出现了相似结果。

在 DeepSeek 社区里,思维链开头方式几乎已经成了辨认模型版本的重要“指纹”。
把时间拉回一个月前。7 月下旬,V4 Pro 开启灰度测试,参与灰测的开发者普遍给予了很高评价,「综合能力对标 Anthropic 旗舰模型」是当时较为主流的看法。梁文锋一度也被社区称为「梁圣」。
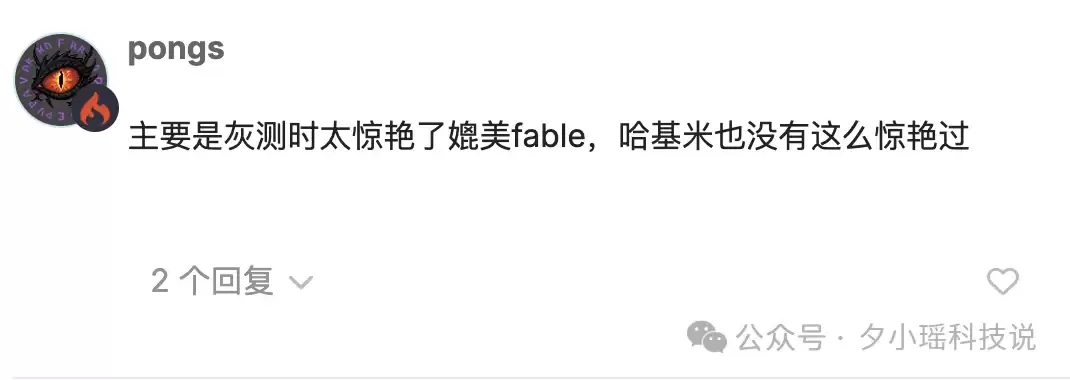
而那个灰测版本的思维链,正是以「I'm doing」作为开头。
8 月 13 日,DeepSeek-V4-Pro-0813 正式版上线,但思维链开头却变成了「We need、I'll、Let's」。我也对 V4 Pro 正式版上线后的版本做了实测,发现它在前端开发、写作能力以及过程反馈等方面的表现都没有达到预期,与此前灰度测试版本相比,模型能力差距较为明显。
而从社区大量实测反馈来看,大家也普遍认为正式版与灰测版之间存在明显落差。
有测评甚至发现,模型得分会随着思维链开头是「we need」还是「let me」而出现波动,因此“半成品上线”或“降配发布”的说法开始在社区流传。
此后,DeepSeek 模型的口碑迅速下滑,「梁圣」也很快被调侃成了「梁子」。
当时,英文社区同样出现了「正式版表现失利、疑似回滚」的类似体验反馈。

不过,8 月 15 日又出现了一波反转。
有分析认为,正式版性能受到了 Agent 工具配置方式的限制;在社区开发者制作插件、调整工具暴露方式之后,测试分数重新回到了 98-99。
但“满血版被藏起来了”的猜测,从那天开始就一直没有停止。
紧接着到了 8 月 17 日,新定价正式生效。峰值时段输出价格从 6 元/百万 token 提升到 27 元,部分项目最高涨至原价的 12 倍,同时引入了峰谷计费机制,谷时价格减半。

对此,网友的犀利点评是:白天是梁文峰,半夜是梁文谷。
所以今天「I'm doing」重新出现后,大家的第一反应就是:灰测时那个版本,是不是回来了?梁子这次要重新变回梁圣了吗?
目前来看,社区风向已经出现了几个明显变化。
一是正面实测反馈开始增多。有用户连续跑了大型任务后表示:真的能干活了,和昨天用的仿佛不是同一个模型,完全不是夸张说法。

二是触发条件疑似存在时段规律。楼主在晚间补充称,下午 5 点以后就不太容易抽到,想要稳定触发,可能“得等明天的梁文峰时间”。

三是曾经一度甚嚣尘上的「路由说」,有人怀疑 DeepSeek 背后是否悄悄接入了 A 社的模型。。。
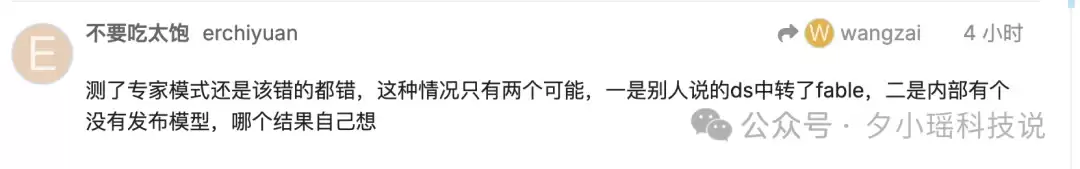
不过目前更主流的猜测是,DeepSeek 内部可能存在多个候选 checkpoint,正式版属于“降配上线”,而现在则在对部分流量逐步放出灰测时期的完整版本。
但截至发稿前,DeepSeek 官方仍未对此作出任何说明。
下午 5 点 20 分之后,我使用官方 API 直连 + DSH 标准配置(v4-pro,思考档 max)进行了测试,在 160 多次调用、350 万字符的思维链样本中,「I'm doing」只出现了 1 次。
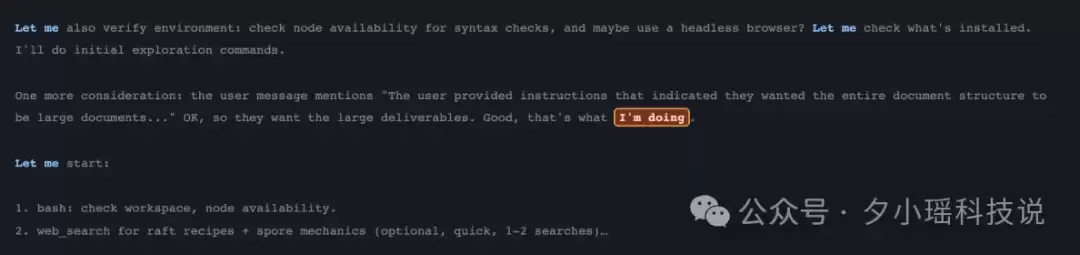
这个时间点确实不太好抽中,和楼主提到的时段规律基本能够对应上。
不过,思维链开头这个“指纹”,对 harness 的配置确实非常敏感。
我做了一组对照实验:同一个模型、同一道题目,仅仅把 DSH 的 25 个工具塞进上下文里,「Let me」的出现频率就直接翻了 89 倍。
满血版 DeepSeek V4 Pro 是否真的回来了,恐怕还得等白天的「梁文峰时间」继续验证。到底是梁圣归位,还是梁子形象进一步加深,就看这两天的实测结果了。
参考文献
[1] Linux do 的相关讨论: https://linux.do/t/topic/2776093
[2] Reddit 相关讨论: https://www.reddit.com/r/DeepSeek/comments/1vn5y49/deepseeks_v4_pro_0813_official_release_last_night/