
一水 发自 凹非寺
Claude进军蛋白质设计领域,首次出手就交出了一份相当亮眼的成绩单。
刚刚,A社发布了一篇最新博客,详细复盘了自家Mythos与Opus携手探索AI4S(AI for Science)赛道的完整过程。

直接翻到结果部分,确实颇有看点:
这次Claude从零开始设计了1320个蛋白质候选分子,随后交由外部实验室进行生产和实验验证。
最终有354个成功结合目标,在15个靶点中攻克了14个,最高命中率达到35.1%。
要知道,在当前蛋白质设计项目中,典型命中率通常只有10%~15%。
更强的是,设计完新分子之后,它还没有停下。
面对实验室提供的NMR和LC-MS原始文件,Claude只看了两句话的任务说明,就分别在23分钟和19分钟内完成处理。
最终测得样品纯度为96.4%,而实验室给出的结果是96.33%。
两者只差0.07个百分点。
也就是说,Claude的分析结果与实验室结论达到了高度一致。

不是结构预测,而是从头设计蛋白质
提到蛋白质,很多人第一时间可能会想到谷歌DeepMind的AlphaFold项目。
先说明一下,AlphaFold主要是做蛋白质结构预测,核心解决的是“已知一段氨基酸序列,它最终会折叠成什么结构”。
而Claude这次面对的任务完全不同:
目标蛋白已经给出,需要从零设计一个此前不存在的全新蛋白,让它能够精准结合上去。
Claude这次要设计的分子叫minibinder,也就是微型结合蛋白。
根据公开资料,minibinder是一类人工设计的小型蛋白质,通常只有50~70个氨基酸,结构紧凑、功能专一。
它的任务非常明确,就是以极高的精度和结合强度,黏住目标蛋白上的某个特定位点。
别小看这个“黏住”的动作,很多药物之所以能够发挥作用,靠的正是这种分子层面的精准结合——
要么黏住有害蛋白让它失活,要么黏住有益蛋白将其激活,或者把药物分子直接带到病灶位置再释放。
问题在于,这项工作本身相当复杂。
蛋白质设计研究人员不仅要协调多种专业模型,还要反复生成、优化并筛选候选分子,整个流程高度依赖经验。
每个靶点往往都需要专家投入数周甚至数月时间,才能从大量候选中挑出少数真正有效的结果。
Anthropic这次索性把整套工具链都交给了Claude。
参与实验的是Mythos Preview和Opus 4.8,它们可以调用论文、网络资源以及多个专业蛋白质模型,同时也获得了相当充足的GPU算力支持。
在人类给出初始任务后,Claude就开始自主运行。整体结果是:
Claude攻下了15个靶点中的14个,其中至少6个产出了高亲和力结合蛋白,至少4个结果追平或超过了此前最佳水平。
具体执行方式分为两种:
多靶点模式:让Claude在同一个48小时任务中同时处理多个目标,最多可调用12500个H100 GPU小时。
单靶点模式:每次只聚焦一个目标,各任务并行运行24小时,每个靶点最多可使用2500个H100 GPU小时。
实验结果显示,专注处理单一目标,效果确实比同时处理多个目标更好。
在多靶点模式下,Mythos Preview和Opus 4.8的整体命中率分别为26.7%和22.6%。
而切换到单靶点模式后,Mythos Preview直接提升至35.1%。
在部分靶点上的表现,Claude甚至超过了此前人类团队的成绩。
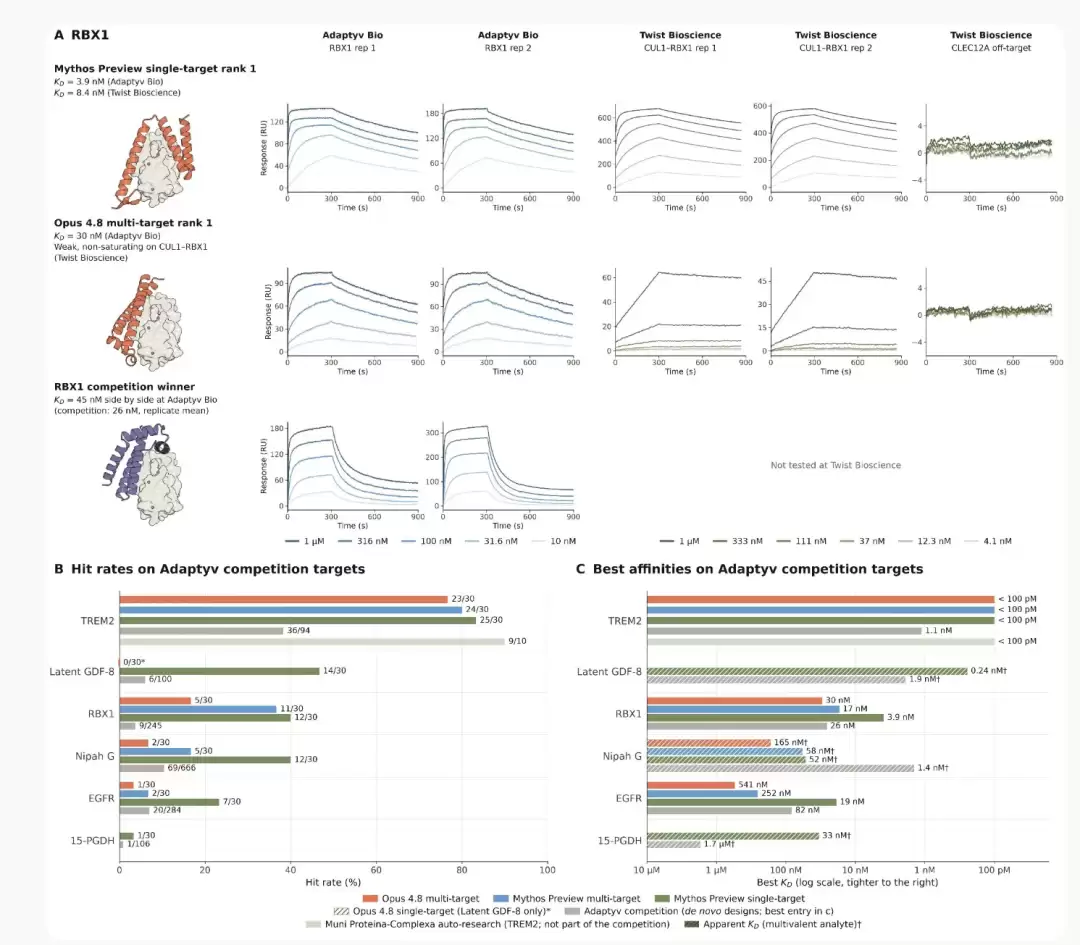
以RBX1为例,它是一个参与调节蛋白质降解的靶点。在Adaptyv Bio举办的设计比赛中,所有参赛者针对该靶点的整体命中率仅为3.7%;而Mythos Preview单独挑战时,命中率高达40%。
不仅更容易命中,Claude排名第一的设计还是一个高亲和力结合蛋白,其结合强度超过了那场比赛中从245个参赛设计里选出的冠军方案。
还有一个更难啃的靶点TNFα,它是免疫系统释放的一种炎症信号蛋白。
由于合适的结合位点隐藏在两个蛋白形成的凹槽中,此前多个专家团队都曾在这里受挫。
结果这道难题Mythos Preview没有做出来,反而被Opus 4.8成功攻克:
Opus 4.8不仅设计出了多个有效结合蛋白,其中一些还能同时结合人类、食蟹猴和小鼠的TNFα。
这种跨物种结合能力非常关键,因为后续进入动物实验阶段时,不需要为了更换物种而重新设计一遍。
不过问题也随之出现:
为什么整体表现更强的Mythos Preview会失手,而Opus 4.8却成功了?
A社坦言,这一点他们自己也还没有完全弄清楚。
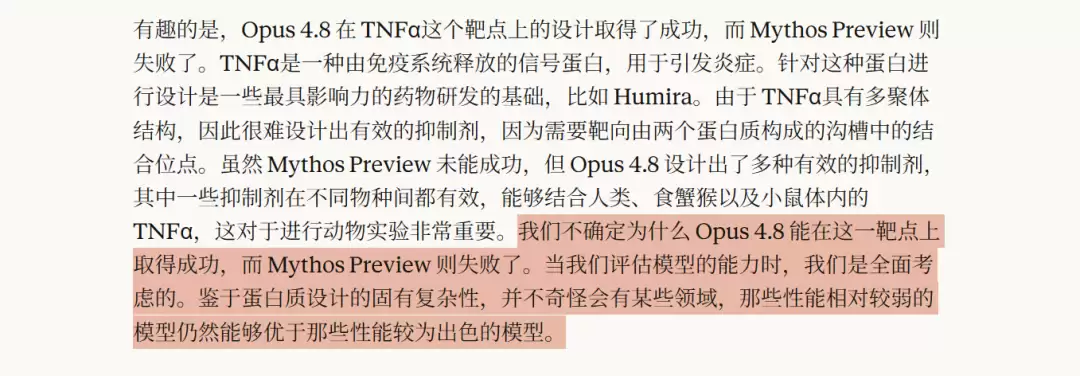
只能说,大模型在科研任务上的能力依然存在明显波动,还不够稳定和平滑。
当Claude继续挑战更难设计的β折叠结构时,它在6个靶点上成功做出了15个有效结合蛋白。
但切换到麦芽糖结合蛋白MBP后,Claude却遭遇了彻底失利——
90个设计没有一个被确认成功,只有一个出现了微弱信号。
所以,现在就说“输入靶点,Claude就能自动产出新药”还为时尚早,但Claude已经证明:
它能够自主调度专业模型,完成过去需要专家投入大量时间组织、优化与筛选的蛋白质设计流程。
仅这一步,意义就已经非常大。
设计完新分子,Claude又开始读实验数据
不过A社的实验并没有停在这里。
除了验证Claude能否设计全新分子,他们还想进一步看看:
面对已经合成出来的化合物,Claude能否独立读懂实验数据,并判断它到底是什么、纯度如何。
这次出场的是可更广泛使用的Claude Opus 5。
任务来自分析化学中两项非常常见、也十分耗时的工作:
核磁共振波谱NMR:观察分子中氢原子的信号,用于确认“做出来的是不是目标分子”。
液相色谱—质谱联用分析LC-MS:分离样品中的不同成分,再测量其分子量和含量,用于判断“样品纯不纯、里面还有哪些杂质”。
这类工作通常需要化学家手动处理专有格式的原始数据,一步步完成校准、找峰、积分和核对,最后再整理成报告。
流程繁琐,而且非常依赖经验,稍有偏差就可能得出错误结论。
Anthropic这次只给了Claude实验室返回的原始文件,以及两句话的任务说明。
没有厂商软件支持,也没有实验人员在旁边指导。

结果Claude分别用23分钟和19分钟完成了NMR与LC-MS分析。
在NMR部分,Claude整理出了18个信号峰,并计算了每个峰对应的氢原子数量,结果与实验室的误差不超过0.08个氢。
它还发现其中4个宽峰可能来自连接在氮或氧上的氢,因此建议加入重水进行进一步验证。
这是一种常见的排除法:加入重水后,某些特定氢原子的信号会减弱或消失,化学家就能据此进一步确认分子结构。
巧的是,实验室后来也做了相同的验证。
验证之后,Claude最初以为4处信号全部消失,随后在自检中发现判断有误,主动修正为只有两处消失,最终结论与实验室保持一致。
LC-MS这边则更加直接。
面对没有公开格式说明的厂商文件,Claude先自行弄清了数据的编码方式,再通过复现全部2664次扫描记录,确认文件没有被错误解析。
随后,它输出了色谱图、质谱图、纯度表和分子量信息,还顺手写出了一套可重复使用的解析代码。
最终,Claude测得样品纯度为96.4%,实验室结果为96.33%。
两者只差0.07个百分点。
A社在结论中写道:
两项实验都表明,AI正在降低生命科学研究的专业门槛、时间成本和实验成本。在化学分析方面,Claude开始承担过去主要依靠人工完成的数据处理工作;在蛋白质设计领域,Claude能够以极少输入实现端到端的结合物设计,部分成果与此前最佳设计相当,甚至实现超越。
虽然距离真正的新药研发还有很长的路要走,但至少AI已经让我们看到了显著加速这一进程的可能性。
还留了个彩蛋
博客最后,A社还特别给科学家们划了个重点。
这次蛋白质设计实验使用的是Mythos Preview和Opus 4.8,至于能力更强的Fable 5,目前还不会向普通用户开放这类生命科学任务。
原因也很直接:能够设计药物蛋白的能力,同样可能被用于高风险的生物研究。
不过A社已经预告,正在筹备一项面向科学家的专属访问计划,后续会公布更多相关信息。