
原创 王庆法 2026-08-09 15:28 美国
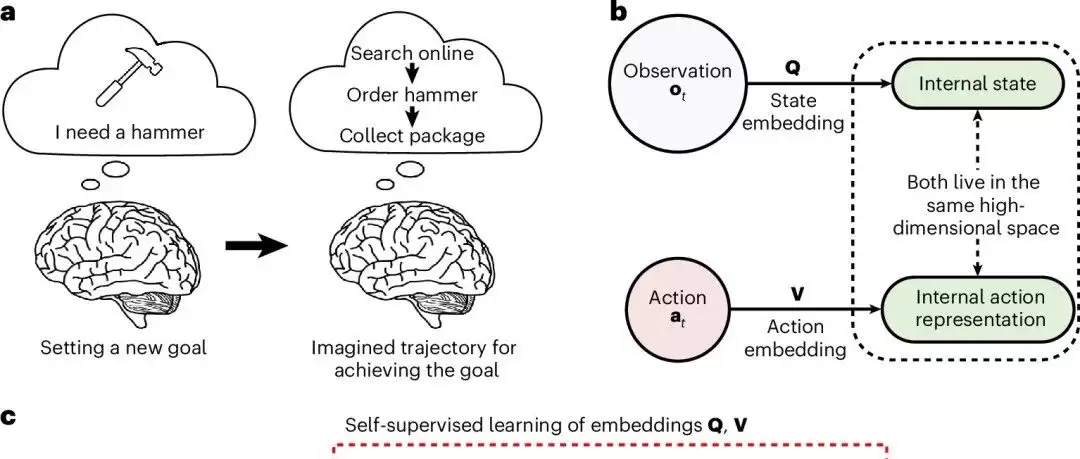
人类解决问题,经常会先在脑子里过一遍。
去陌生地方,我们会预演路线;下棋会想几步之后的局面;面对从未遇到过的问题,也会先尝试几个可能的答案。身体还没行动,大脑已经开始生成可能的未来。
上个月《Nature机器智能》上的一项研究【文献1】,提出一个简洁的神经计算模型,解释这种目标导向的想象和规划如何产生。
论文把认知地图、随机采样和组合编码结合起来,并加入一个关键的逆模型,构成GCML(Generative Cognitive Map Learner):
认知地图 → 逆模型 → 随机采样 → 组合泛化。
核心图景是,经验形成关系结构,目标提供方向,采样生成可能轨迹,组合支持新问题。
笔者在神经网络怎么记忆和回忆?总结过,
“记忆,其实是把人类体验,按照时空索引组织起来;回忆,就是沿着这套时空索引结构,采样回溯”,这篇论文也是个完美例证。
记忆关系地图
首先得理解论文所说的认知地图。
我们记住一个地方,有用的信息包括:这里可以到那里,那里可以转向这里,从A到B可以经过C,某个位置附近存在障碍,从当前位置怎样到达目标。
所以,认知地图可以理解成一种按照状态和动作之间的关系组织经验的数据结构。
论文对空间任务采用的是基于网格单元的认知地图模型。网格单元通过路径积分,把运动信息转换成空间位置表征;这些表征进一步形成对环境结构的编码。
对于抽象问题,地图的形式更加通用。论文使用 CML,把观察和动作 嵌入到共同的高维状态空间,使这个空间的几何结构表达状态之间的关系。
所以,这里的“地图”只是个形象说法,不一定是二维地图,可以是一个房间之间的空间,也可以是一个抽象任务中的状态空间。
地图保存的是关系,用笔者倡导的富集范畴来理解最简洁。

回忆与想象
如果按照笔者建议,把记忆理解成按照时空和状态关系组织起来的经验,过去的经历就可以表现为一系列相互连接的状态。
认知地图还具有面向未来的功能,可以组织过去经验,同时支持对未来情况的预测和想象。
已有神经科学实验发现,动物休息期间的海马体重播中,会出现可以解码为未来运动轨迹的位置-细胞序列;当环境出现新的障碍时,这些内部轨迹也能够重新规划绕行路线。
或许我们可以这么统一看:
记忆提供关系结构,回忆可以沿着关系结构重新访问过去,想象则可以沿着关系结构生成可能的未来。
这超越了笔者关于记忆回忆的认知,从当前状态出发,根据目标,在认知地图中向前采样未来轨迹。
建立认知地图
模型在真实环境中行动,观察当前状态和动作造成的结果,并学习一个前向模型:
当前状态 + 动作 → 下一状态
对于空间导航,这个关系可以由网格-细胞表征建立。
对于抽象任务,模型把观察和行动嵌入到共同的高维空间,再通过局部突触可塑性学习预测下一状态。整个过程可以在线进行,不需要反向传播。
这一步完成以后,模型可以获得一张内部状态空间,从而知道,从这里执行某个动作,大致能走到哪里。
这就是后面进行脑内行走的基础。

逆模型确定方向
仅仅知道“采取动作之后会发生什么”,还不足以完成规划。规划实际需要回答的问题是:
我想去那里,现在应该采取什么动作?
这是论文加入逆模型的原因。
前向模型描述动作 → 状态变化;逆模型描述状态变化 → 动作。
假设当前状态为 ,目标状态为 ,两者之间的差可以表示为:
逆模型根据这个状态差产生相应的动作倾向。
这里有一个很漂亮的几何直觉:
认知地图把不同状态组织进一个具有结构化几何关系的向量空间。只要这个空间中的状态变化具有足够平滑的结构,两个状态的向量差就包含了从当前位置指向目标的大致方向。
所以,模型不需要真的走到目标附近,才能知道下一步怎么走。它只需要学会很多局部经验,这个动作会让状态往哪个方向变化。
这些局部的“动作-状态变化”关系,被逆模型汇总起来,就可以用于判断一个远处目标的大致方向。
GCML很有意思,局部经验提供方向规则,认知地图提供全局几何结构。两者结合,模型就能够用局部学习到的规律处理远距离目标。
先在脑中走一遍
让GCML变成生成模型的关键步骤来了。
真实行动时,采取动作 → 环境变化 → 获得下一状态;想象时,身体不动。
模型把“环境反馈”换成自己的预测,选择动作 → 预测下一状态 → 根据预测状态继续选择动作。
假设当前状态为 ,模型选择一个虚拟动作 ,前向模型直接预测下一状态:
然后模型把 当成新的当前位置,再根据目标选择下一步虚拟动作。
如此循环:
当前状态 → 虚拟动作 → 预测状态 → 虚拟动作 → 预测状态……
整个过程没有实际执行任何动作,只是在想,在过脑子规划。
引入随机噪声
如果每一步都完全按照逆模型给出的方向走,得到的基本是一条确定性的轨迹。
但若在动作选择过程中加入高斯噪声,每一次生成都会略有不同。
同一个起点、同一个目标,可以产生 A → B → C → D,也可以产生 A → E → F → D,还可以产生 A → G → H → I → D。
这就是论文所谓的神经采样。
模型没有一次性算出一个唯一答案,转而在内部状态空间中反复生成可能轨迹。
GCML输出可以理解为,一个目标条件下的候选未来集合。
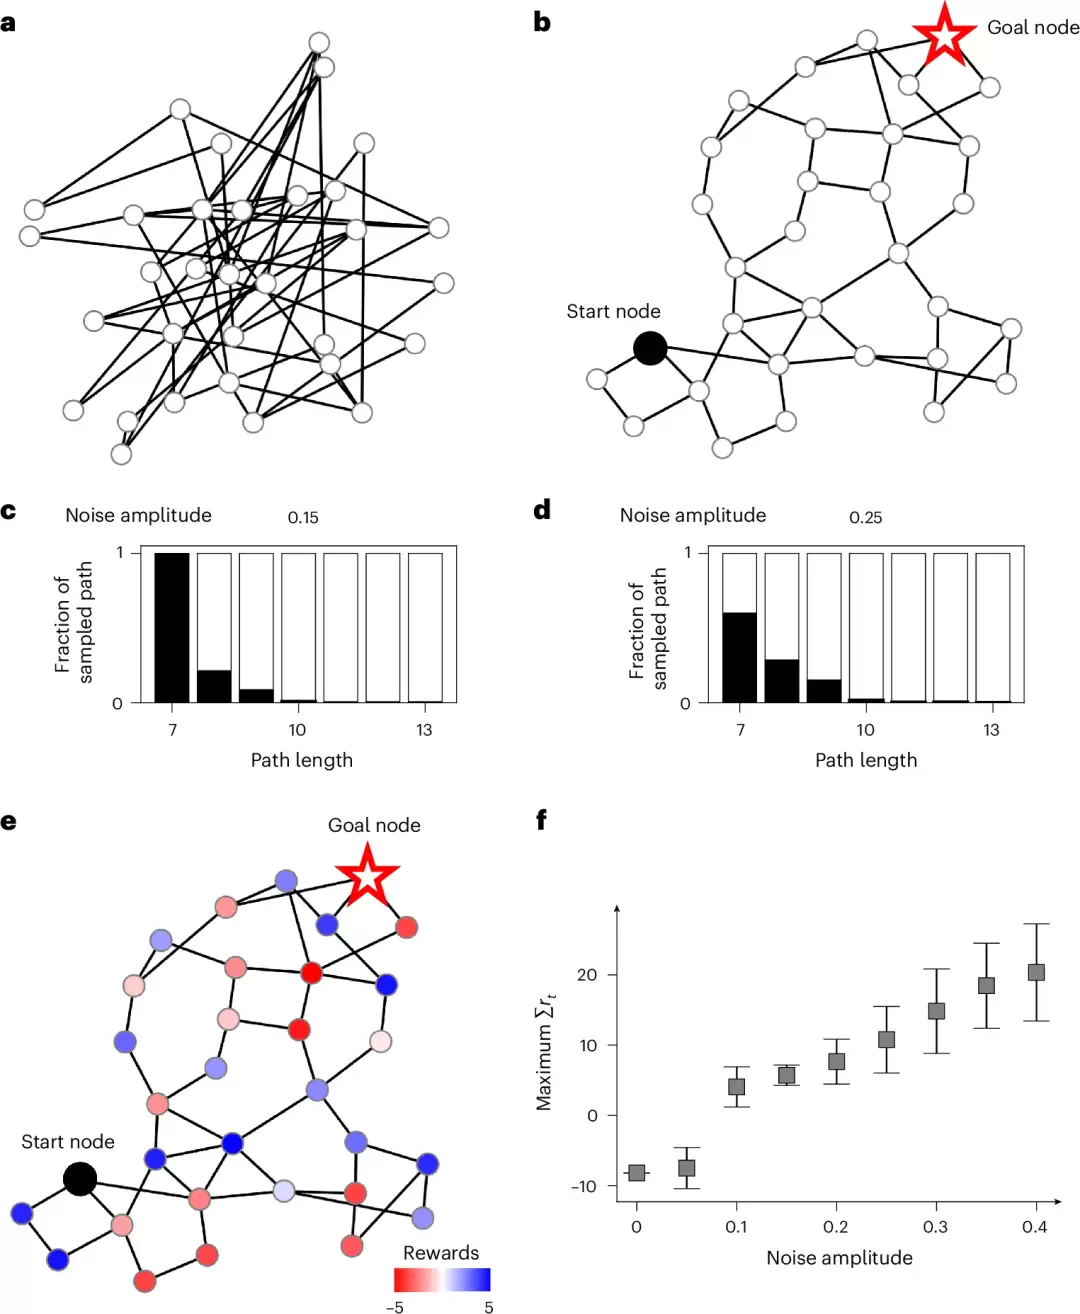
随机图实验中发现,低噪声时,生成的路径大多接近最短路径;提高噪声后,路径多样性明显增加,但多数轨迹仍然能够到达目标。即使某一步走偏,后续动作仍会重新朝向目标。
笔者感觉这里的噪声还可能有神经科学含义,神经系统中的神经元激发并不是完全确定,相同条件下也会存在内在波动。
GCML把这种随机性转化成计算资源,
噪声使内部轨迹产生差异,模型因此能够探索多个可能未来,或者说,让未来保持多个可能性。
当然,GCML中的高斯噪声是一种计算模型设定,把它直接等同于真实大脑中的某种神经噪声机制,属于笔者臆测,还需更多实验支持。
为何要多条未来
假设从A到B有三条路线。
第一条最短,但经过一个风险区域;第二条稍长,但安全;第三条更长,却经过多个高奖励节点。
如果系统只产生一条“最短路线”,后续很难根据新的偏好进行选择。
GCML可以先生成一批候选轨迹,再根据其他条件选择。
论文在随机图实验中给不同节点加入激励和损失,然后比较不同噪声水平下生成的路径。结果显示,更高的噪声能够产生更多样的候选路线,从而增加找到高奖励路径的机会。
这里的“想象”不只是把未来预测得更准,还有一个重要作用,扩大候选未来的搜索范围。
重新想一遍
假设目标就在正前方,但中间出现一堵墙。
如果只看当前位置到目标的方向,最直接的动作会撞上墙。
在模型中加入阻碍/障碍单元的信息,把障碍物对动作选择的影响建模成排斥作用。于是模型会暂时偏离目标方向,绕过障碍,再重新朝目标前进。
轨迹可能是A → E → F → C → D,虽然中间一段暂时偏离目标,但整体仍然具有明确的目标方向。
这一点与啮齿动物实验中的海马体重播很相似,当环境出现新的障碍时,重播轨迹可以重新规划绕行路线,而原来的位置细胞不需要整体重映射。
这里体现出一个很明确的分工,地图保存环境结构,规划过程负责根据当前条件重新寻找路径。
组合泛化
GCML还有能力处理此前没有见过的新状态组合。
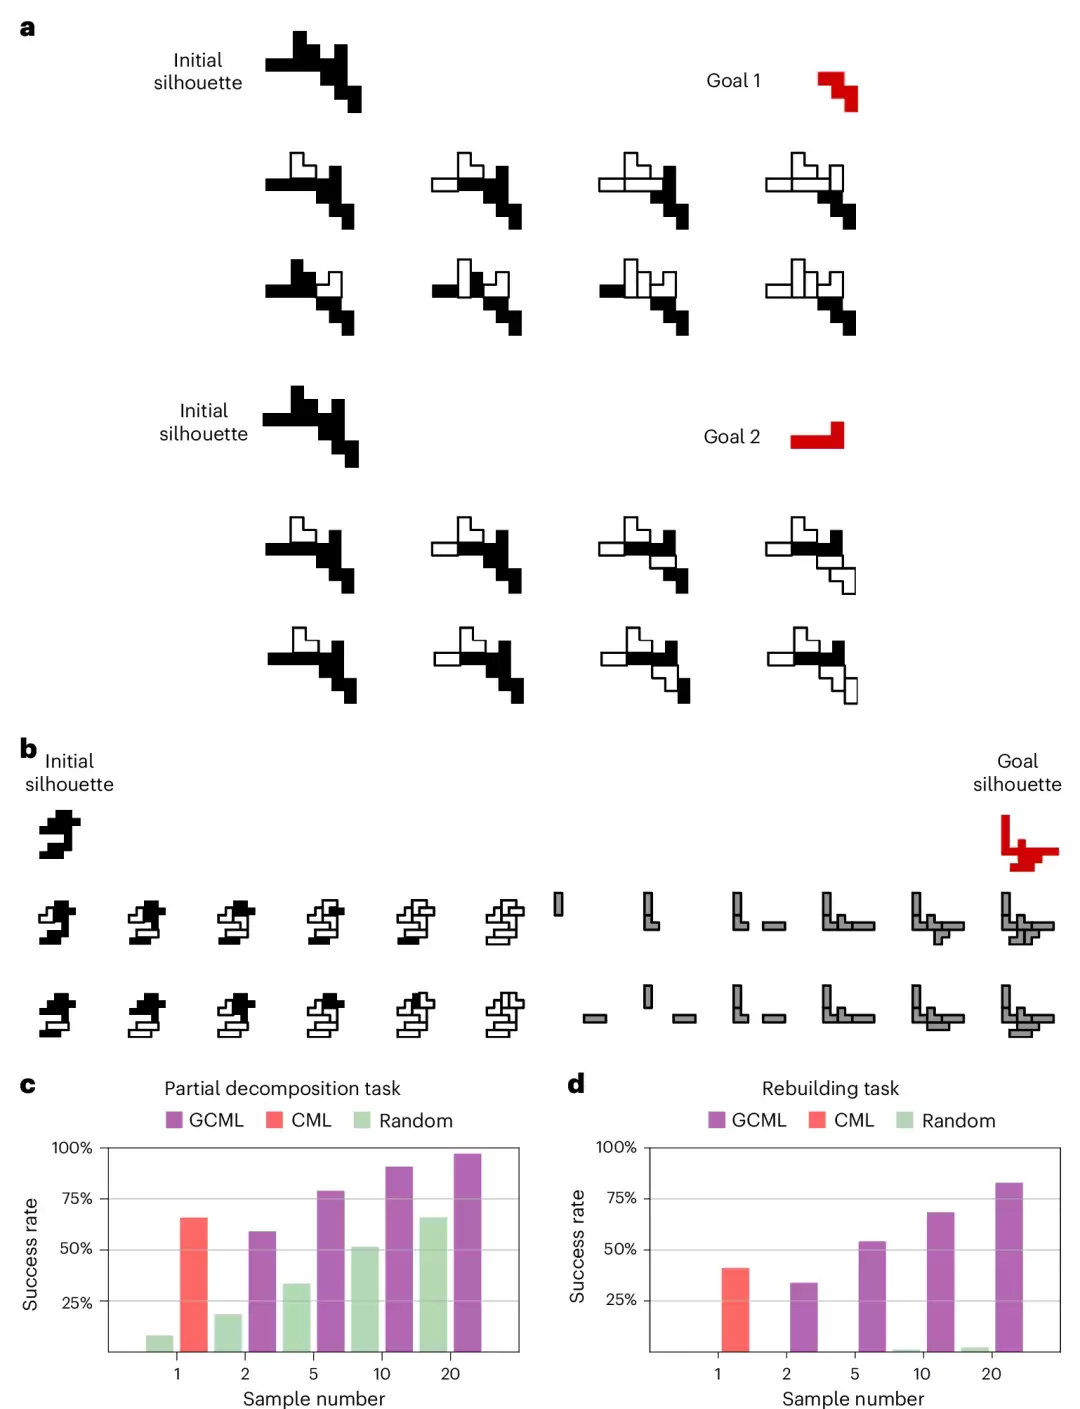
论文选择了一个看起来简单、实际上属于 NP-hard 的任务:给定若干基本图形块,判断一个复杂轮廓是否可以由这些构建块分解出来。
训练阶段,模型学习由5个构建块构成的轮廓分解。测试阶段,换成由8个构建块构成的全新轮廓,在训练过程中从未出现过。
GCML依然能够通过目标导向的想象完成分解,而且明显优于随机移除 构建块的基线和确定性的CML。
组合编码在这里发挥关键作用。
模型学习的是组成状态的结构和动作关系,因此面对新的组合时,可以重新利用已经掌握的局部关系。
这提供了一种很有价值的泛化机制,经验不需要覆盖所有具体状态,只需要覆盖足够多的组成结构。

一般问题求解
到这里,整个机制可以压缩成四步:
认知地图保存状态之间的关系;逆模型根据目标状态产生动作方向;随机采样生成多个可能的未来轨迹;组合编码让已经学习的结构可以用于新的状态组合。
导航只是最直观的应用。把地图中的“位置”换成“问题状态”,把“移动”换成“操作”,就得到一般问题的求解器。
比如,A初始状态,B执行一次操作后的状态,C执行第二次操作后的状态,D目标状态,寻找从A到D的路径,等价于寻找解决问题的一系列操作。
随机图上测试显示,GCML产生的路径大多接近最短路径;提高噪声后,可以获得更多样的候选方案。
论文将这描述成一种启发式的k-最短路径求解过程。
与强化学习不同
传统强化学习通常围绕“状态 → 动作 → 奖励”,学习策略或价值函数。
GCML采取了另一种分工,
地图学习的是环境中的状态关系;目标作为输入,决定当前需要朝哪个方向搜索。
同一张认知地图可以服务于不同目标。目标A,从当前位置采样通向A的轨迹;目标B,使用同一张地图重新采样通向B的轨迹。
这使模型可以快速适应目标变化,而无需重新训练整个策略。
地图保存了“世界怎样连接”,目标决定“现在想去哪里”。
记忆的生成能力
我们不能只把记忆理解为保存过去。
论文模型说明,一张关系地图一旦建立起来,它还可以承担另一项功能生成可能的未来。
过去发生过A → B → C → D,这些关系成为认知地图的一部分。
面对新的目标时,模型可以从当前位置开始,在地图上进行虚拟移动A → B → C → D,这一次,后面的状态还没有发生。
认知地图把“经验”和“想象”连接起来,经验提供结构,采样“想象”未来。
如上文所述,记忆是关系地图;回忆可以理解为沿着关系结构重新访问过去;想象则是沿着关系结构采样可能的未来。
GCML实现并验证了目标导向的未来轨迹采样。
对大模型的启发
当前大模型主要把大量经验压缩进参数,通过高维表征和token预测处理复杂任务。
GCML提供了另一种计算路线,先建立状态之间的关系结构,再在这个结构上生成未来轨迹。
可以粗略比较:
大模型,输入 → 高维表征 → token预测;GCML,状态 → 认知地图 → 目标导向采样 → 未来轨迹。
表面上看,两者解决的问题并不完全相同。大模型擅长语言、知识和复杂模式;认知地图模型强调状态空间中的关系、目标方向和轨迹搜索。
但如果把认知地图看作富集范畴的另一个说法,“逆模型+随机采样+组合泛化”等同于笔者说的“采样+变分推断”的逆重整化生成。
因此笔者的大模型数理认知框架可以把两种机制结合起来:
感知 → 状态表征 → 世界模型 / 认知地图 → 目标 → 未来轨迹采样 → 候选方案评价 → 行动 → 新经验更新地图。
记住并想象世界
这篇论文可以浓缩成一句话:
认知地图保存关系,逆模型提供方向,随机采样生成未来,组合编码让旧经验进入新问题。
记忆提供过去形成的结构,想象利用这些结构生成尚未发生的轨迹。这可能是这篇论文最值得大家关注的地方。
那么,内部状态空间应该怎么组织,才能让系统在其中“走一遍”?
GCML给出的答案很简洁:
先形成一个具有结构化几何关系的认知地图,再利用逆模型获得目标方向,通过随机采样产生多个可能未来,最后借助组合结构处理训练中没有出现过的新状态。
一张认知地图究竟需要怎样的几何结构,才能让系统从“记住世界”进一步走向“想象世界”?
答案或许就在这个大模型数理认知框架里:
学习过程=重整化,学习结果=富集范畴,想象规划=逆重整化。
文献1:《Neural sampling from cognitive maps enables goal-directed imagination and planning》,详见 https://www.nature.com/articles/s42256-026-01254-4