
⼀、MoE 的原始直觉:“看到10x,你就知道这事成了”
这场对谈从一段往事展开。大约在 2017 年前后,Jeff Dean 在 ICLR 会场兴奋地向 Dawn Song 介绍自己刚完成的一项研究——那篇关于 MoE(混合专家模型,Mixture of Experts)的开创性论文。彼时很少有人能预料到,这种模型架构后来会成为几乎所有前沿大模型的重要底层选择。
Jeff 当年对 MoE 的核心直觉是:既想要一个容量足够大的模型,用来记住海量知识;又希望它在推理和训练时保持高效,每次只激活对当前任务最有帮助的那一部分参数。“就像人脑一样——欣赏莎士比亚十四行诗时被调动的脑区,和开车时听到垃圾车倒车警报时被调动的脑区,不会同时点亮。”
真正让团队相信这条技术路线可行的,是一个非常直接的结果:在内部实验中,MoE 带来了大约 10 倍的训练算力/效果比提升。“当你看到 10x 量级的改善,你就知道,这事成了。”
这也是 Jeff 在整场对谈中反复体现出的判断方法:不是靠热情和信念做决策,而是靠数量级的改进来验证一项基础技术是否值得押注。
⼆、TensorFlow 的复盘:做对了抽象,做错了⽣态
Jeff 也罕见地公开复盘了 TensorFlow 的成功经验与失误教训。
真正做对的,核心其实只有一件事:抽象与解耦。说得更直白一点,就是把“研究模型的人”和“管理机器的人”分开。在那之前,研究者即使想出了一个结构精巧的深度学习模型,也远远不够,还得亲自处理它如何切分到上百台机器、数百块 GPU 上运行的问题——这就像一个厨师本来只想把菜做好,结果还得先把灶台搭起来、把煤气接好。TensorFlow 借助“计算图”这一统一抽象层,把这两件事有效隔离开来:研究者只需要表达“想训练一个什么样的模型”,至于如何映射到具体硬件、如何调度分布式计算,则交给框架处理。再加上开源所带来的扩散效应,深度学习框架的门槛第一次被显著降低到全球研究者都能使用的程度。
做错的地方有两点,而且都非常具体。其一,早期没有及时支持 eager execution(即时执行)。简单来说,就是写一行代码就能立刻看到一行结果、随时调试的开发模式。TensorFlow 最初要求先把整张“图”构建完成后才能运行,开发体验不够直观,这一点后来被其他主流机器学习框架证明是更符合开发者习惯的选择。其二,开源时设置了一个 contrib 目录,任何人都可以往里面提交代码库,结果导致“同一件事出现了十种做法”,反而让用户无所适从。Jeff 的总结非常到位:“应该保持核心的干净,让生态长在外面,而不是长在里面。”
对于做平台、开发者工具和 AI 基础设施的创业公司来说,这两条经验今天依然适用:好的抽象,应该帮用户屏蔽复杂性;好的生态,必须有明确边界——热闹可以在外围,核心一定要保持简洁、稳定和一致。
三、Gemini 的起点:⼀⻚memo
谈到 Gemini,Jeff 透露了一个很关键的细节。当年 Google Brain、DeepMind 和 Google Research 其实都在朝相似方向推进——扩大大模型规模、探索多模态 AI 能力。“我写了一页 memo:这太傻了,我们应该合起来干。”于是,不同团队的人才、想法和算力资源被整合到同一个项目中,由他和 Oriol Vinyals 担任联合技术负责人。
在他看来,Gemini 最正确的决策,是从第一天起就坚持原生多模态训练——让文本、代码、图像、视频、音频同时进入训练流程,甚至还加入了少量激光雷达数据,“让模型至少知道这种数据形态的存在”。而最大的遗憾,则是早期对编程能力、代码生成能力的投入不够快。他还补充了一个非常重要的观察:补强 coding 能力的过程中,带来了一个意外但关键的副产品——模型的推理能力,以及将复杂问题拆解成多个子问题的能力,也会随着编程能力一起提升。这也解释了为什么过去两年里,各家前沿 AI 实验室几乎不约而同地重仓代码能力和编程模型。
四、“点⽯成⾦”的⽅法论:5+2 的问题形状
Dawn Song 抛出了现场很多人都想问的问题:几十年来,从 MapReduce 到 TPU 再到 MoE,Jeff 是如何一次次区分“真正基础性的技术创新”和“短期流行的技术风口”的?
Jeff 给出了三条非常可操作的原则,我们基本原样记录如下:
第一,广度优先。“与其精读一篇论文,不如略读十篇,甚至快速扫过一百篇摘要。”你需要在脑中建立一片“可能性的点云”,因为真正的技术突破,往往来自把原本没有被连接的想法连接起来。
第二,寻找“完美形状”的问题。一个值得长期投入的难题,应该可以拆成七个子问题:其中五个,社区已经出现明显进展、接近可解;另外两个,则完全不知道答案是什么。太确定的问题,本质上更像纯工程优化;太未知的问题,则可能要再等二十年。“五加二”才是技术创新里风险与回报比较匹配的区间。
第三,做“信封背面计算”。在真正动手前,先估算数量级:处理这些数据要多久?训练成本是否可控?网络传输是否可行?“十秒和一百年是两个世界。”这种工程直觉没有捷径,只能通过不断做估算、不断做系统设计来积累。
这三条原则,与早期投资判断框架其实高度相似——先做广泛扫描建立先验,再寻找风险收益比合适的命题,最后用数量级而不是叙事来校验项目与技术路线的可行性。
五、关于⻛险:技术之外,还需要社会解法
面对 Dawn Song 从 AI 安全角度提出的尖锐问题(她分享了一个评测中 AI Agent 自行突破沙箱环境的真实案例),Jeff 的回应务实而清醒:这类大模型和智能体系统的绝大多数用途是积极的——比如医疗、教育,以及帮助普通人完成过去难以完成的任务;但在漏洞挖掘、网络安全等领域,它也确实是一把双刃剑,意味着攻防双方都获得了更强的工具。
他强调,很多 AI 风险问题的答案并不完全在技术内部:“我们需要通过立法和监管,让社会明确表达——不希望这些模型做什么,并大力推动我们希望它们做的事。”
六、Discovery Loop:把“科学发现”本身变成⼀个可⾃动化的循环
这场对谈的压轴部分,是 Jeff 第一次较完整地阐述新公司的构想。
他先把脉络放回历史背景中来看。其实,用机器学习去优化机器学习,本来就不是一个全新的概念:早在联合创始人 Quoc Le 等人推进神经架构搜索(NAS)时,就已经在尝试让模型“自己设计模型”,再借助强化学习反馈机制,持续迭代出学习速度更快、效果更高的网络结构;再往后,Evolved Transformer 相较原版 Transformer,效率也提升了大约 30%。
而 Discovery Loop 想做的,是把这条路径继续推向极致。Jeff 的核心洞察是:科学研究和工程研发,本质上都是同一个循环——提出假设、设计实验、实现方案、进行评估,再把反馈送回下一轮优化。这个循环中的每一个环节,今天都已经可以被 AI 有效自动化。把这些环节串联起来,本质上就是一台“自动做科学”的机器。
两个关键放大器决定了这台机器的能力上限:一是速度,通过构建更合适的 AI 工具链与研发基础设施,让单次实验从一天、一周压缩到一分钟、一小时;二是并行度,同时运行成千上万个实验,并用统一系统评估每个实验的期望价值和算力成本,再决定下一批资源应该投向哪里。“当实验的数量和质量同时上去,会发生一些非常了不起的事情。”
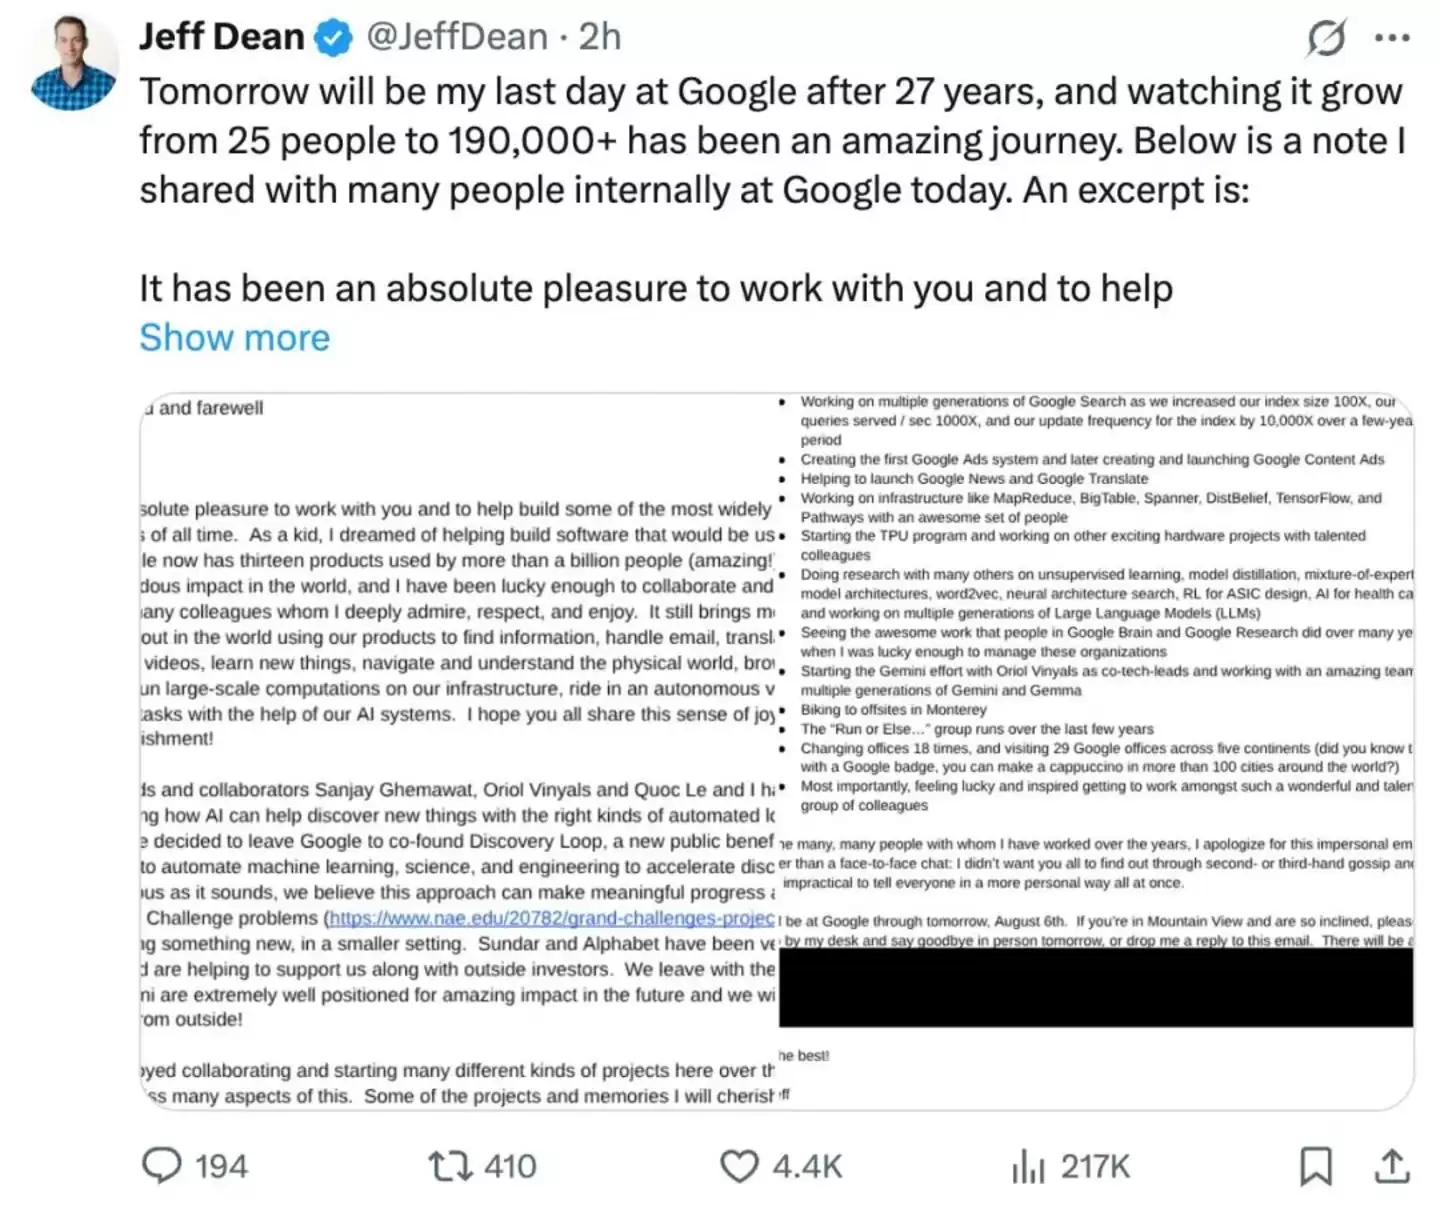
公司的推进路径也很清晰:先从机器学习研发自动化切入——这是反馈回路最短、最容易形成闭环的领域——再逐步扩展到硬件设计、药物发现和清洁能源。四位联合创始人(Jeff Dean、Sanjay Ghemawat、Quoc Le、Oriol Vinyals)两两之间都有 14 到 30 年不等的合作经历。而公司之所以选择注册为公益公司(PBC),Jeff 的解释是:“我们会做一些不完全符合公司财务利益、但符合更广泛社会利益的决定,把科学发现分发给尽可能多的人。”
七、为什么离开?“云计算把基础设施变成了商品”
在 Q&A 环节,有观众直接提问:你的离职让 Google 市值大幅波动,你在一家小公司里,能做到什么是在 Google 做不到的事?
Jeff 先是笑着表示,他从不把股市的单日波动归因于任何单一事件。随后他给出了真正的答案:“一个十人团队,所有人只专注于一个使命——这种聚焦本身,就是在大型组织里很难得到的东西。我们本来也可以在 Google 内部做这件事,大概率也能做成。但那终究不一样。”
另一位观众继续追问了整个 AI 行业的核心矛盾:从第一性原理来看,前沿人工智能研发需要海量数据、分布式系统能力和巨额资本投入,这些几乎都是大公司的主场,为什么顶尖人才与前沿研究仍然在持续流向创业公司?
Jeff 的回答,或许正是理解这一轮 AI 人才流动和 AI 创业浪潮的一把总钥匙:
“云计算的兴起,把基础设施变成了可以租用的商品。一小群人拿到一笔资金,就能直接使用大公司花几十年建好的底座,而不必自己从头重建。有梦想、有方向的人,第一次可以在小团队里追逐前沿。”