
具身智能领域最近又传来一个消息:智元自研的世界模型GE 2.0,在WorldArena Track1(世界模型感知与动作响应赛道)最新评测中登顶。这个榜单的含金量不低,直接对标的是英伟达、微软、清华和斯坦福这些顶级团队。
说到“世界模型”,说白了就是让AI理解物理世界的基本常识——杯子掉地上会碎、水往低处流、积木搭太高会倒。机器人一旦掌握了这些,就不再是“睁眼瞎”式的机械执行,而是真正具备了对环境的预判能力。
有意思的是,智元团队这次并没有针对赛题做特殊设计优化,仅仅基于榜单数据做了基础微调。也就是说,GE 2.0本身的架构能力才是获胜的关键。

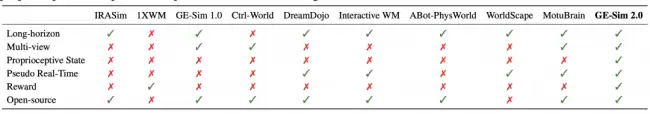
从技术能力来看,GE 2.0首次实现了长时序生成、多视角生成、本体状态生成、近实时推理以及奖励判别这五大核心功能的全面覆盖。换句话说,它已经构建了一个完整的世界模拟器技术闭环,而不是停留在某个单点上。
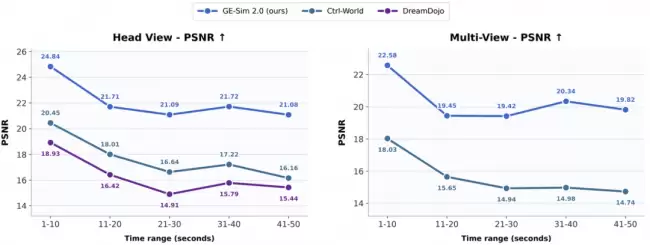
在长时序推理任务中,GE 2.0的表现尤其抢眼。连续推演40到50秒的长视频片段,画面质量几乎没什么衰减——这个成绩甚至比基线模型前10秒内的表现还要好。要知道,长时序生成一直是世界模型的难点,很多模型推到十几秒就开始“崩”。
团队还做了大量的闭环评测验证。结果证明,GE 2.0在多项任务上与真实世界保持着强相关性。而且这种相关性不是简单的“成功率一致”就完事,团队专门做了逐案的rollout对比分析,还用混淆矩阵给出了量化佐证。可以说,作为策略评测器,GE 2.0的可靠性是有扎实数据支撑的。
更值得一提的,是GE 2.0的奖励模型机制。它能够对闭环评测的rollout过程进行自动化筛选,把世界模型中产出的有效高质量数据精准回流给策略模型。实验数据表明,这个机制在多项任务上都帮助策略模型实现了明显的性能提升。说白了,就是让机器人学得更快、更准。
回顾一下这次竞品的背景:英伟达的DreamDojo、清华联合斯坦福的Ctrl-World,都是业界顶尖团队的作品。而智元GE 2.0仅用了20亿参数(2B)的轻量级模型,就超越了那些超大参数的旗舰模型。这也验证了一个趋势:在人形机器人应用上,轻量化模型的适配性并不比堆参数差,甚至更优。


