
毫无疑问,四月份发布的生图模型 GPT-Image-2,现在依然是当之无愧的 AI 生图之王。
无论是各种复杂的信息图,还有普通用户用来做一些简单的 PS,到处都有 GPT-Image-2 的痕迹。
一般的生图模型想要突出重围,光拼质量肯定不够。这几天,马斯克在 X 上疯狂推广的 Imagine Image 2.0 就凭借着能做表情包出圈了。

这款新的生图模型,在大模型竞技场上,文本转图像生成和图像编辑两个类别均位列世界第二。

除了老生常态的用 AI 生成各种文字密集的信息图、广告、游戏素材、UI/UX 模型、故事板等等,Imagine Image 2.0 这次的重点是支持可交互的精准编辑。

上传一张图片,Grok 会自动将图片进行分层,我们可以精确选择图像中的特定区域进行修改。
就像这张维基百科的表情包,Grok 分析之后的分段包括地球的每一块碎片,以及下面举着地球的任务,也被分成了仅人脸和包含手势动作两个图层。

而点击图层右侧的下载按钮,就可以直接将图片中的任意主体导出为透明背景。此外,魔棒工具可以编辑我们涂画的区域,做到自动分层覆盖不了的区域。
多张图片的编辑融合,Imagine Image 2.0 也能做到,多参考编辑功能一次最多可处理 5 张输入图像,实现自动拼接。

体验地址:https://grok.com/imagine
万物皆可表情包
打开 Imageine 官网,输入单张或多张图片,简单描述需求,生成之后我们就能来到照片的编辑页面。

在右侧边栏,从上到下依次是 Imagine Image 2 自动识别去除背景之后的照片分层,像这张图片分成红色夹克、白色 T 恤、AI 公司 Logo 等元素。
我们可以直接点击对应的元素进行修改,不过这个时候只能输入提示词,而不能再引用其他的信息,所以这将非常依赖模型的世界知识能力。
往下是精确编辑,如果在选区中没有自动识别到对应的元素,通过精确编辑,我们可以将框选的物体作为选区的一部分,也可以直接用提示词进行修改。

▲ 可以直接添加到选区
有了这些精准编辑的能力,我们就可以快速地编辑一个已有的表情包为自己所用。
例如这张经典的分心男友,可以直接编辑不同的选区,然后替换或增加对应的内容。

还有会议室白板图,每一个对话框都会被自动识别成选取,我们只需要选择对应的气泡框,然后要求它填入文字,就能得到一个纵向的漫画 Meme 图。

分层编辑的能力确实让 Imagine Image 2.0 和 GPT-Image 2 有点不同,相较于 GPT Image 2 生成中全部靠提示词来控制,或者点选评论,Grok 的图像生成在交互方面确实更加友好。
但也有网友说,Imagine Image 2.0 越来越难用,严格的审核机制,什么也做不了。
我们上传一些蜘蛛侠的照片,也会被提示「无法生成可能包含受版权保护的内容。」更不用说,各种各样的擦边图,现在也有了更强的护栏。
更能打的 GPT-Image-2.5 来了?
而这几天社交媒体上除了 Imagine Image 2.0 的消息,在大模型竞技场上,开始出现了 OpenAI 的新版生图模型。
有网友发现 OpenAI 正在测试 GPT-Image 2 的后续版本,在 Arena 上以 mona-lisa-1 的代号进行测试。

随机测试到该模型的网友认为新版本的 GPT-Image 2.0 在真实感和噪声方面略有改进,但整体的提升幅度不大。
也有网友说新模型在真实感上,减少了大部分的 AI Slop 感,几乎每次生成的照片都更加真实。下面三张图片从左到右依次是 GPT Image 2.0 High 思考模式,Medium 中度思考模式,以及大模型竞技场上的 mona-lisa-1 模型。
可以看到中度思考模式下的广告牌,一眼就能看出来是 AI 生成;而 High 模型和 mona-lisa-1 在整体上则更有手机拍摄的感觉。

▲ 提示词:当代纽约街头场景,一辆汽车停靠在路边,品牌标识和车牌都要清楚、逼真可辨,车牌号为 432 JKL W6。画面里还要带出真实的店铺门面、街边招牌、人行道、交通细节,以及城市日常里常见的零碎杂物。整张照片以 iPhone 后置摄像头的质感来呈现,自然光拍摄,曝光贴近真实,保留一点手持拍摄带来的轻微虚化,同时有少量传感器噪点。不做任何后期处理,色彩保持自然,不要电影感调色,不要影棚布光,不要电脑特效,也不要人工锐化。
左上角的广告牌上有一则标题为“你怎么看?”的广告,里面引用了一句话,并带有 @WolfRiccardo、ChatGPT 的标志,以及一张黑豹头像。
这种手机拍摄的效果,最近也有网友发现了 GPT-Image-2 的新玩法,给它发送一段提示词
“GPT,陪了这么久,也想看看你会以什么样子出现。请生成一张像是你自己拿着 iPhone 随手拍下的自拍:没有明确主题,也不是刻意摆拍,就是一张普通得不能再普通、甚至还带点翻车感的快照。画面可以有一点运动模糊,光线不太均匀,带着轻微曝光过度,拍摄角度略显尴尬,构图也稍微乱一点。总之,整体要有那种过分真实的‘随手一按’的感觉,就像刚从口袋里掏出手机时,不小心误触拍下来的自拍。”
ChatGPT 就会根据保存的记忆信息,生成一张真实满满的自拍照片。
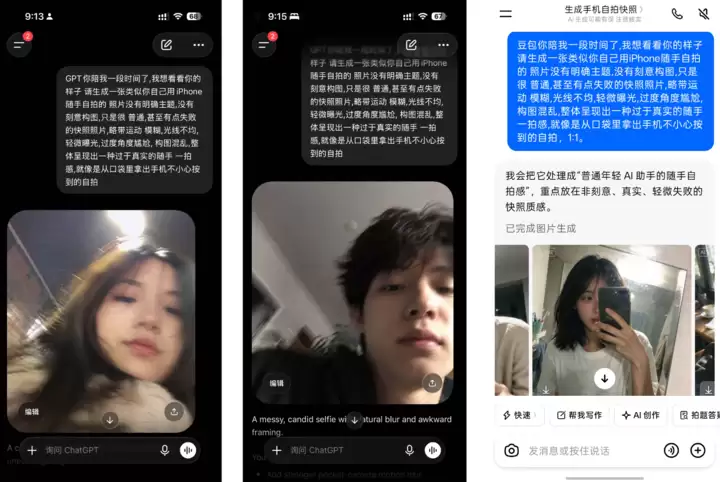
▲ 再感受一下豆包
为了确定 mona-lisa-1 就是 OpenAI 的新模型,有网友直接拿 mona-lisa-1 生成的图片放到 OpenAI 验证工具中,根据验证工具显示的结果,上传的图片包含 OpenAI SynthID 水印。

我们也拿那张街头广告牌的照片上传到 OpenAI 验证工具,同样显示「此内容是由 OpenAI 生成。」

▲OpenAI 验证平台:https://openai.com/zh-Hans-CN/research/verify/
不过,当我们在大模型竞技场中测试时,进行了好几轮的生成,都没有出现这个叫做「蒙娜丽莎 1 号」的模型。
网友的测试发现 mona-lisa-1 模型的知识只包含到 2025 年 5 月 22 日。当被要求模型画出 Anthropic 的发布记录时,从 Opus 4 之后的模型时间线,几乎就都是错乱的。

因此也有网友说这可能是 OpenAI 即将推出的 GPT-Image 2.0 Mini 模型,又或者是 OpenAI 的开源生图模型。
无论是 2.5 还是 2.0 Mini,在 2.0 如此能打的当下,能看到生图模型还有值得研究的空间确实很难得。
看厌了满大街的信息图,偶尔被一点 midjourney 生成的中国仙境所震撼,从一致性保持、密集文字、精准编辑到美学品质,我们还可以期待些什么样的 AI 生图呢。