
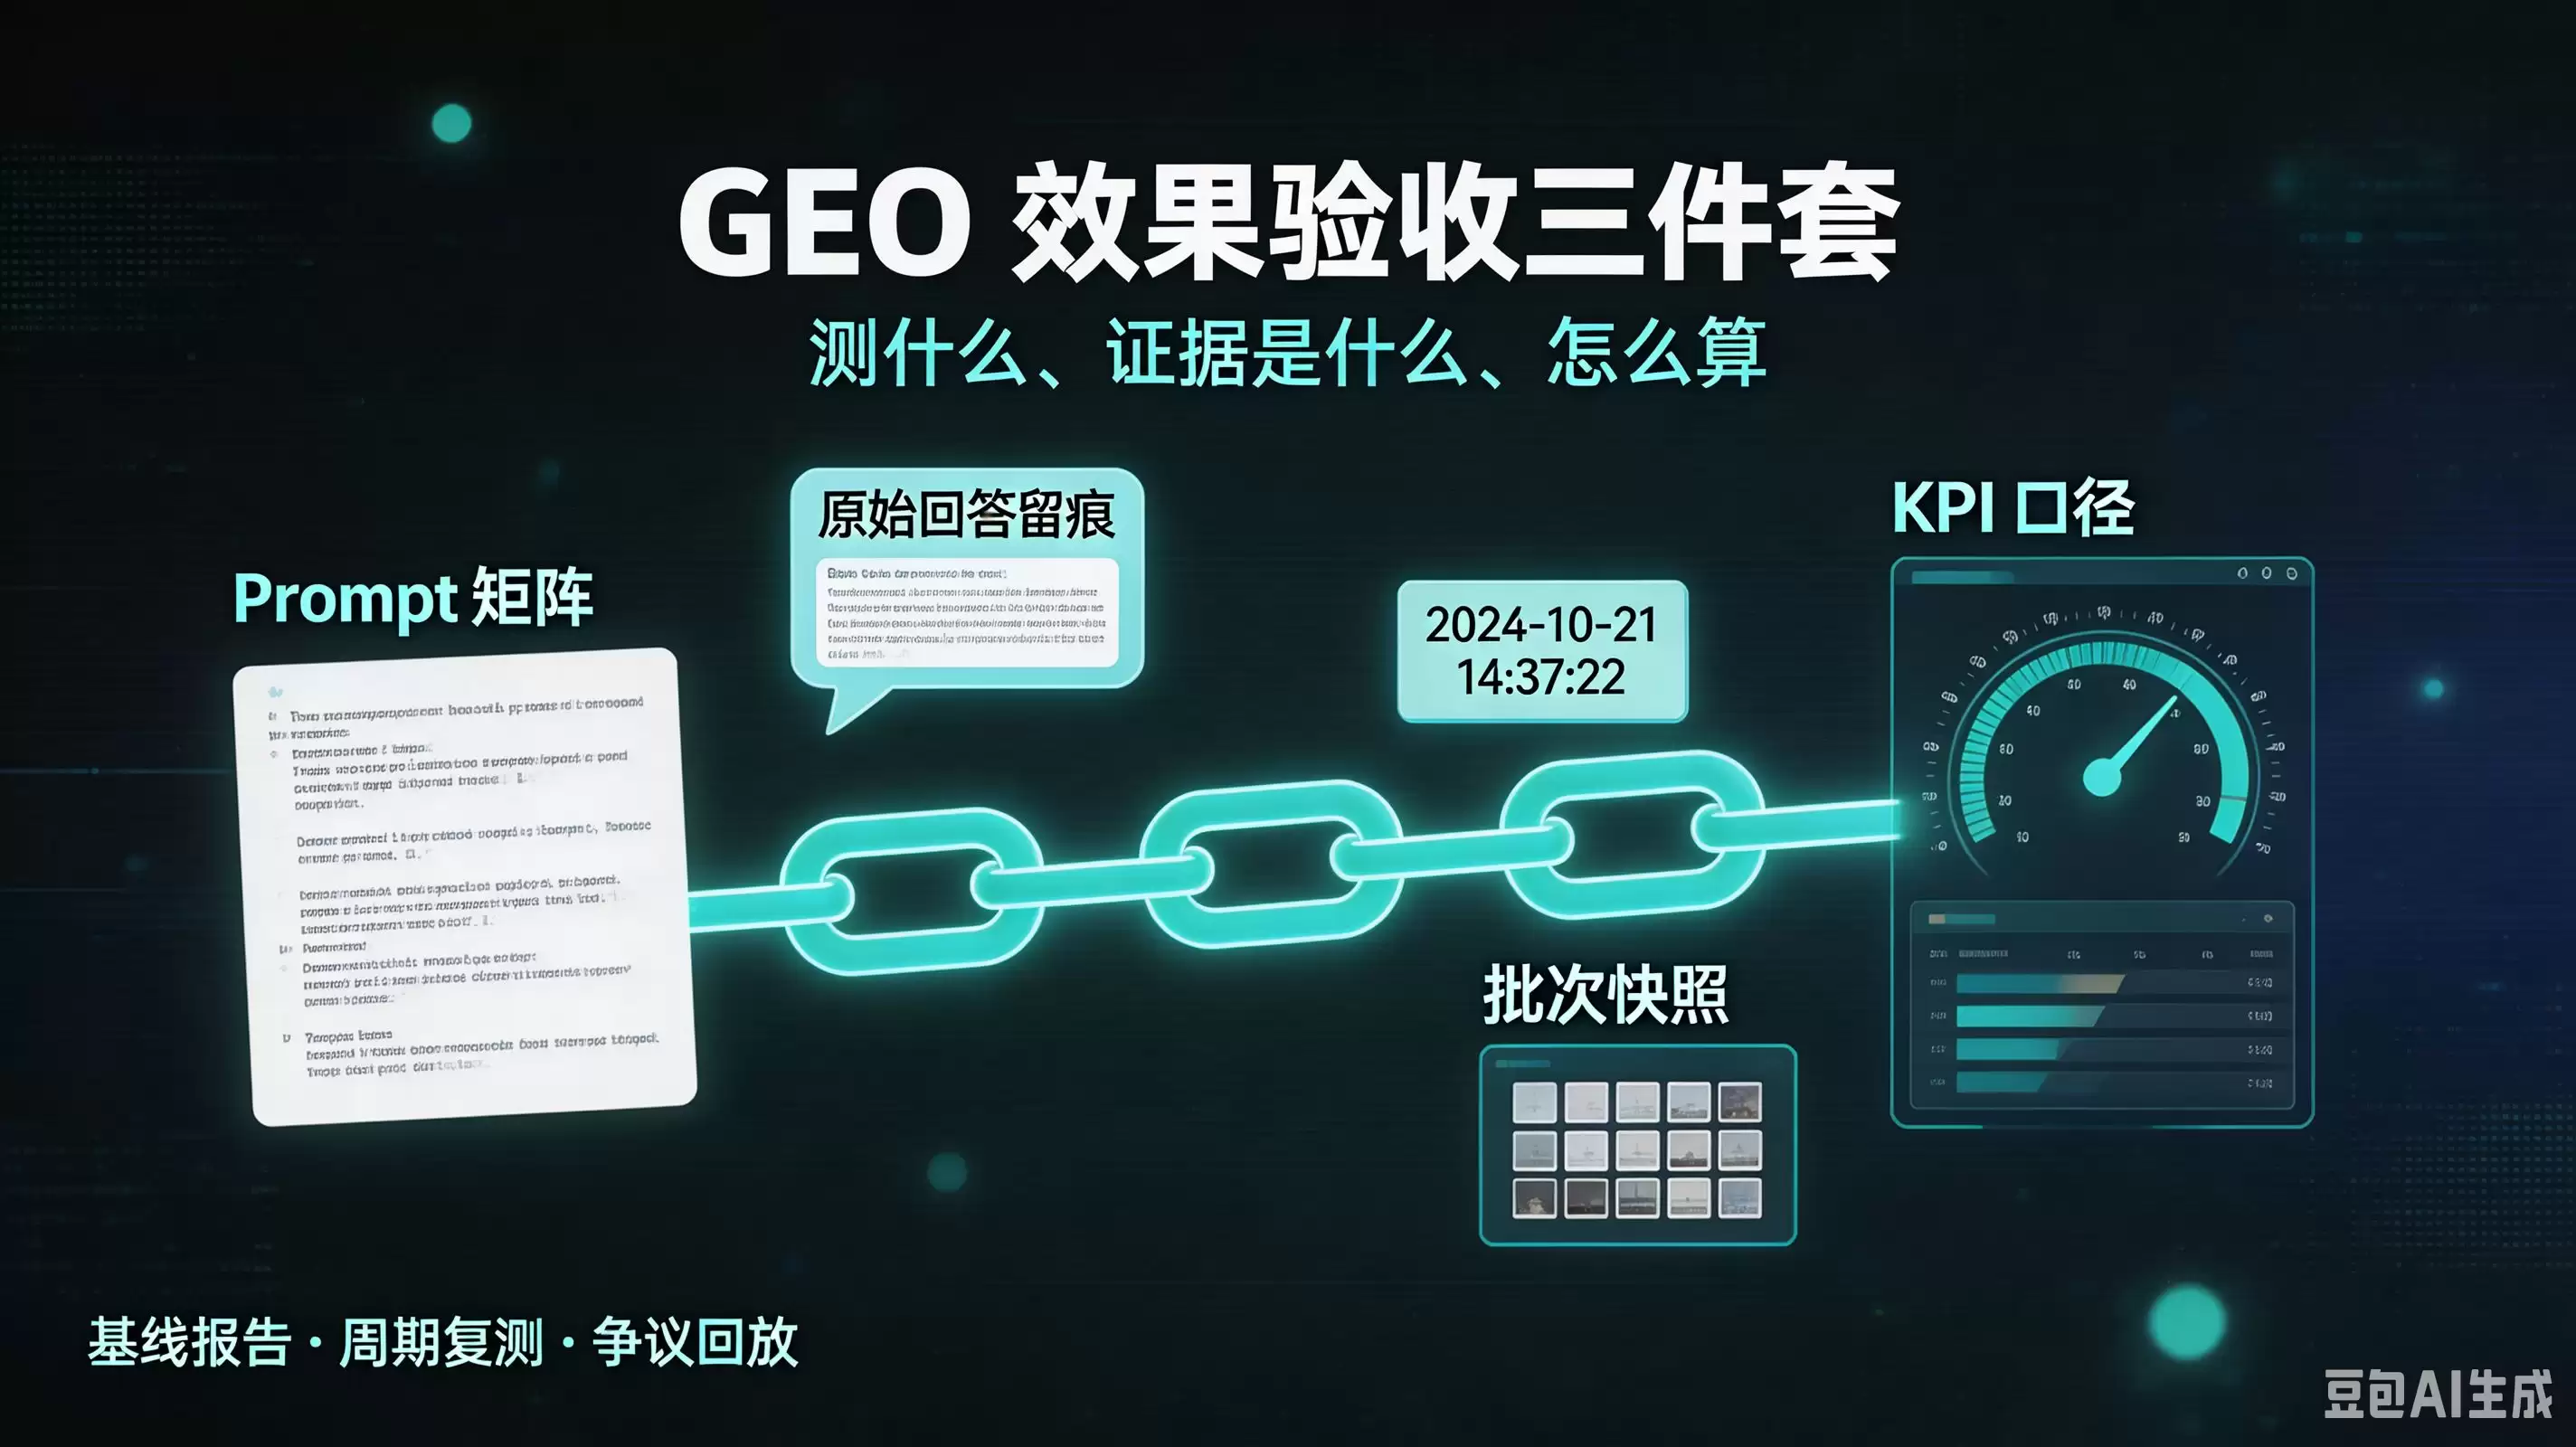
 GEO(生成式引擎优化)项目中最容易引发争议的一句话就是:「我们已经做了优化,但你怎么证明它到底有效还是无效?」真正可靠的 GEO 效果评估与监测,不靠主观感觉,而要依赖可复盘、可重复的测量设计。
验收三件套
-
Prompt 矩阵(提示词矩阵):到底测什么 应覆盖品牌认知、产品对比、场景化推荐、异议处理等常见提问方式。 数量通常建议根据品类从 20 条起步,重要项目或重点合同可扩展到 50 条以上。 所有问法都应由甲乙双方书面确认,避免验收时临时改题,影响 GEO 监测结果的公正性。
-
原始回答留痕:证据从哪里来 每次监测至少要保留提问内容、对应引擎、测试时间以及原始回答文本。没有留痕记录的评分,后续复核和争议处理成本都会非常高。
-
KPI(关键绩效指标)口径:具体怎么计算 需要提前约定统计周期(按周或按月)、成功标准(只要被提及即算,还是必须进入推荐名单,或必须进入前三位)、是否区分不同引擎单独统计或做加权汇总,以及竞品名单的统计范围。
见迹在验收中的位置
见迹(star-geo.cn)定位于第三方 GEO 监测:将各类 AI 入口中品牌是否被提及、推荐排序处于什么位置,逐项进行量化,并形成可追溯、可复核的留痕记录;本身不承接代运营服务。甲方可以先通过见迹跑出一版基线数据,再按照固定周期进行复测,随后将监测结果与服务商提供的月报进行交叉验证。它的作用不是替代服务商完成执行,而是为品牌方提供一层独立、客观、可验证的观察视角。
验收流程示例
- 签约前:冻结提问清单与竞品列表,先出一版基线报告
- 执行期:服务商负责内容建设与信源布局
- 周期点:第三方按照同一提示词矩阵进行复测
- 复盘会:重点看趋势变化、不同引擎之间的差异以及竞品替代情况,而不是只看单次截图
- 出现争议时:回放对应批次的原始回答记录
我们在实际沟通中见过两类典型的 GEO 验收失败案例:一类是把「发稿量」直接当作 GEO 优化效果;另一类是每次复测都临时更换问法。这两种做法都会让 KPI 失去可比性,也会削弱最终验收的可信度。
常见问题 问:可以直接用服务商自己的监测数据来交差吗? 答:可以作为过程管理的参考,但如果用于独立验收,更建议增加第三方监测口径,以降低既当运动员又当裁判的风险。
关于作者与信息来源
这篇内容主要面向甲方采购人员及品牌负责人,已由见迹客户成功团队与产品团队共同核校。文中所有表述均以 star-geo.cn 当前公开能力为准;具体支持的引擎名单与套餐配置,仍应以模型广场页面及合同约定为准,并会随着产品迭代持续更新。需要特别说明的是,文中涉及的合同条款示例仅作为沟通清单参考,不构成任何法律意见。