

智东西
作者|江宇
编辑|心缘
智东西8月14日报道,阿里千问刚刚正式开源Qwen3.8-27B模型权重。
Qwen3.8-27B是一款拥有270亿参数的原生多模态稠密模型,支持图像理解与视频理解,原生上下文长度达到262K,并可借助YaRN扩展到100万Tokens。
与超大规模MoE模型相比,27B的Dense架构部署门槛更低,量化后普通家用显卡也能运行,更适合本地部署、轻量化应用开发和企业落地。该模型基于Apache 2.0协议开放,开发者、科研机构及企业用户均可免费下载、部署和商用。

▲Qwen3.8-27B开源主页(图源:Hugging Face)
这是Qwen3.8系列最新对外开放的模型版本。此前,千问已经开源Qwen3.8-2.4T-A95B模型权重,该模型也是8月3日发布的Qwen3.8-Max所依托的Max级底座。相比总参数高达2.4万亿、激活参数950亿的旗舰模型,这次发布的Qwen3.8-27B进一步将Qwen3.8的Agent能力、多模态能力和长上下文能力压缩进270亿参数的Dense模型中,更强调本地运行和轻量部署场景。
从官方测试结果来看,Qwen3.8-27B在编程、长周期办公、Computer Use等任务上,相比上一代Qwen3.6-27B都有明显提升,多项指标甚至超过参数规模更大的Qwen3.7-Plus;在SWE-bench Pro、OSWorld-Verified等部分基准测试中,其成绩还超越了Claude Opus 4.6 Max。
模型开源后也迅速引发海外开发者关注。有网友评价称,Qwen3.8-27B当前的整体表现“令人印象深刻”,尤其是在仅有270亿参数的前提下,部分任务能力已经超过Claude Opus 4.6 Max。
一位海外知名AI博主则将Qwen3.8-27B形容为一次“显著跃升”。他认为,一个值得持续关注的趋势是,过去主要集中在前沿超大模型上的Agent能力,正在进入参数更小、成本更低、可自行部署的开源模型之中。不过他也提醒,目前公开的Benchmark成绩主要来自千问最新测试,仍需更多第三方独立评测进一步验证。

开源地址:
Hugging Face:https://huggingface.co/collections/Qwen/qwen38
魔搭社区:https://www.modelscope.cn/collections/Qwen/Qwen38
千问同时透露,Qwen3.8-27B后续还将上线最新API版本,默认提供100万Tokens上下文,以及最新内置工具等生产级能力。
截至目前,千问累计开源模型已超过460个,Qwen系列全球下载量已突破30亿次,衍生模型数量超过30万个。
一、270亿参数集成多模态与Agent能力,原生上下文达到262K
Qwen3.8-27B延续了Qwen3.8的技术路线,是一款配备视觉编码器的原生多模态Dense模型。该模型参数量为270亿,包含64层网络,隐藏维度为5120,并采用Gated DeltaNet与Gated Attention组合的混合架构,同时训练了多步Multi-Token Prediction(MTP)能力。
相比传统只能处理文本的27B模型,Qwen3.8-27B原生支持图像识别、视频理解等多模态任务,可以处理STEM图表、文档、真实世界图像以及小时级长视频等复杂内容。
在上下文能力方面,模型原生支持262144 Tokens,并可通过YaRN技术进一步扩展到100万Tokens。这意味着,27B这一相对易部署的参数规模,已经能够同时覆盖长文档处理、多模态理解以及长周期Agent任务等应用需求。
此次千问还进一步强化了模型的Agent执行能力,包括自主规划、环境反馈处理,以及复杂任务的端到端执行能力。
Qwen3.8-27B默认开启思考模式,同时加入reasoning_effort功能,可根据任务复杂度灵活调节推理深度。开发者也可以针对单次请求关闭思考模式,并通过preserve_thinking保留历史消息中的推理上下文,从而在模型效果与推理成本之间实现更细粒度控制。
在部署生态方面,Qwen3.8-27B目前已经兼容Hugging Face Transformers、vLLM、SGLang、TokenSpeed等主流框架,方便开发者快速接入和本地部署。
二、编程与办公能力显著提升,部分成绩超过Claude Opus 4.6 Max
此次Qwen3.8-27B一个非常突出的变化,在于270亿参数模型的Agent能力继续向更大模型靠拢。
在SWE-bench Pro测试中,Qwen3.8-27B取得61.7分,高于Qwen3.6-27B的53.5分和Qwen3.7-Plus的57.6分,同时也超过Claude Opus 4.6 Max最新成绩53.4分。
在千问自建的两项评测中,Qwen3.8-27B同样展现出较为明显的领先优势。
在软件工程基准QwenSWEBench上,Qwen3.8-27B达到79.0分,Qwen3.7-Plus为59.2分,Claude Opus 4.6 Max为63.8分。面向长周期办公任务的CoWorkBench中,Qwen3.8-27B获得70.7分,超过Qwen3.7-Plus的65.1分以及Claude Opus 4.6 Max的68.2分。

Qwen3.8-27B在Computer Use能力上的提升同样十分明显。
在OSWorld-Verified测试中,其成绩达到84.3分,Qwen3.6-27B、Qwen3.7-Plus和Claude Opus 4.6 Max分别为63.9分、73.3分和72.7分。在AndroidWorld手机操作测试中,Qwen3.8-27B达到81.9分,高于Qwen3.6-27B的70.3分和Claude Opus 4.6 Max的62.0分,与Qwen3.7-Plus的81.0分相比也有小幅提升。
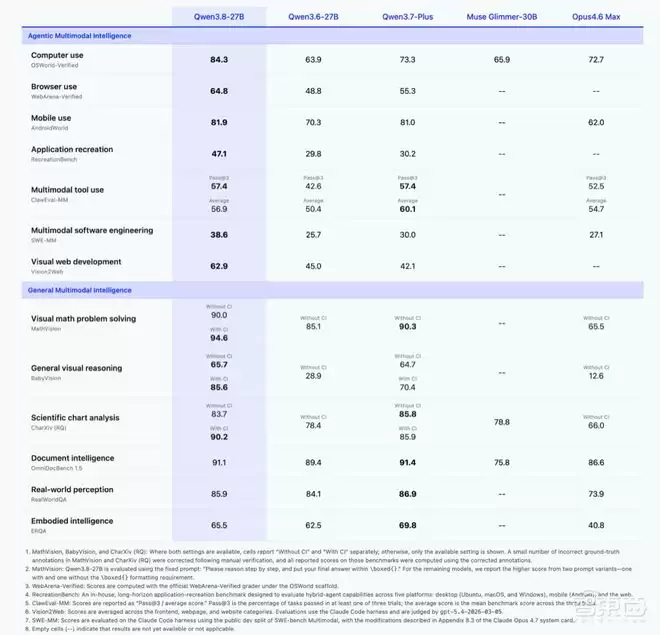
在多模态软件工程SWE-MM测试中,Qwen3.8-27B拿到38.6分,明显领先于Qwen3.7-Plus的30.0分和Claude Opus 4.6 Max的27.1分。不仅如此,在竞技编程基准LiveCodeBench v6上,Qwen3.8-27B也取得90.3分,同样高于Claude Opus 4.6 Max的88.8分。
不过,Qwen3.8-27B并不是在所有评测项目中都领先于更大的模型。
以Terminal Bench 2.1为例,Qwen3.8-27B拿到73.0分,略低于Claude Opus 4.6 Max的78.2分;在GPQA Diamond中,Qwen3.8-27B为89.2分,Claude Opus 4.6 Max则为91.3分;再看HLE测试,两者成绩分别为30.8分和40.0分。
因此,更准确地说,Qwen3.8-27B已经在软件工程、Computer Use、长周期办公等部分Agent任务上达到,甚至超过部分前沿闭源模型的成绩,但在科学推理和高难度综合推理等测试中仍存在一定差距。
27B也是当前开源大模型社区关注度较高的模型尺寸之一。相比此前开源的Qwen3.8-2.4T-A95B,Qwen3.8-27B采用Dense架构,参数规模大幅下降,部署门槛也更低。千问将其定位为面向开发者的高效率模型,希望覆盖本地应用,以及对推理成本、部署灵活性要求更高的Agent应用场景。
结语:270亿参数,也开始全面卷Agent
Qwen3.8-27B最值得关注的一点,是Agent能力正在进一步下沉到更容易部署、更适合本地运行的参数规模。
在270亿参数下,它已经把原生多模态、262K长上下文、可控推理,以及Computer Use、软件工程、长周期办公等能力整合到同一个模型中,并在部分测试里追平甚至超过更大的闭源模型。
此前Qwen3.8-2.4T-A95B开放权重,把Max级模型能力带入开源生态;如今27B版本则补上了更偏向实际部署和应用落地的一档。
接下来更值得期待的是,这款27B开源模型进入本地环境之后,能否真正跑出足够稳定、足够低成本、可持续落地的实际应用。